
목차
다음 목록은 이 VisualApplets 버전이 지원하는 모든 하드웨어 플랫폼의 주요 하드웨어 사양을 보여줍니다. 자세한 목록을 확인하시려면 각 제품의 데이터 시트를 참조하십시오.
| 자료 | imaFlex CXP-12 Quad | imaFlex CXP-12 Penta | imaFlex 2 Dual 100 | ||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 비전 프로세서 | Xilinx UltraScale+ XCKU3P-FFVD900-1-E | Xilinx UltraScale+ XCKU3P-FFVB676-1-E | Xilinx UltraScale+ XCKU15P-FFVE1517-1-E | ||||||||||
| LUT | 160679 | 161049 | 447992 | ||||||||||
| 플립플롭 | 323224 | 323216 | 895984 | ||||||||||
| 블록 RAM (18k) | 720 | 720 | 1776 | ||||||||||
| URAM 블록 (288k) | 48 | 48 | 128 | ||||||||||
| Arithmetic 로직 유닛(DSP48) 내장형 | 1368 | 1368 | 1800 | ||||||||||
| RAM 용량 | 3 x 512 MiB DDR4 | 5 x 512 MiB DDR4 | 2개 @ 5 x 1024 MiB DDR4 | ||||||||||
| RAM 데이터 폭 | 384비트 | 640비트 | 640비트 | ||||||||||
| 총 RAM 대역폭 (공유) | 14.4 GB/ |
24.0 GB/s |
2 @ 24.0 GB/s |
||||||||||
| 기본 설계 클럭 (기본값) | 312.5 MHz |
312.5 MHz |
391.5 MHz |
||||||||||
| 기본 설계 클럭 (최대) | 400.0 MHz | 400.0 MHz | 420.0 MHz | ||||||||||
| Host Interface | PCIe x 8 Gen 3 (직접 메모리 액세스) | PCIe x 8 Gen 3 (직접 메모리 액세스) | PCIe x 16 Gen 3 (직접 메모리 액세스) | ||||||||||
| 호스트 인터페이스 (PCIe ×8 Gen 3) 대역폭 (이론값) | 8000 MB/s | 8000 MB/s | 16,000 MB/s | ||||||||||
| 호스트 인터페이스 (PCIe ×8 Gen 3) 대역폭 (표준/최대) | 7200 MB/s의 지속적 데이터 대역폭 | 7200 MB/s의 지속적 데이터 대역폭 | 13,000 MB/s의 지속적 데이터 대역폭 |
||||||||||
|
|||||||||||||
표 68. imaFlex 플랫폼의 하드웨어 구성
| 자료 | mE5 marathon VCX-QP | mE5 marathon VCL | mE5 marathon VCLx | ||||
|---|---|---|---|---|---|---|---|
| 비전 프로세서 | Xilinx Kintex7 XC7K160T - 2FFG676C FPGA | Xilinx Kintex7 XC7K160T - 1FBG676C FPGA | Xilinx Kintex7 XC7K410T - 1FBG676C FPGA | ||||
| LUT | 101400 | 101400 | 254200 | ||||
| 플립플롭 | 202800 | 202800 | 508400 | ||||
| 블록 RAM (18k) | 650 | 650 | 1590 | ||||
| Arithmetic 로직 유닛(DSP48) 내장형 | 600 | 600 | 1540 | ||||
| RAM 용량 | 4 x 512MiB DDR3 | 4 x 512MiB DDR3 | 4 x 512MiB DDR3 | ||||
| RAM 데이터 폭 | 512비트 | 256비트 | 256비트 | ||||
| 총 RAM 대역폭 (공유) | 12.8 GB/s |
6.4 GB/s |
6.4 GB/s |
||||
| 기본 설계 클럭 (기본값) | 125MHz | 125MHz | 125MHz | ||||
| 기본 설계 클럭 (최대) | 312.5 MHz |
312.5 MHz |
312.5 MHz |
||||
| Host Interface | PCIe x 4 Gen 2 (직접 메모리 액세스) | PCIe x 4 Gen 2 (직접 메모리 액세스) | PCIe x 4 Gen 2 (직접 메모리 액세스) | ||||
| 호스트 인터페이스 (PCIe x 4 Gen 2) 대역폭 (이론값) | 1×2000 MB/s | 1×2000 MB/s | 1×2000 MB/s | ||||
| 호스트 인터페이스 (PCIe x 4 Gen 2) 대역폭 (일반/최대) | 1800 MB/s의 지속적 데이터 대역폭 | 최대 1800 MB/s의 지속적 데이터 대역폭 | 최대 1800 MB/s의 지속적 데이터 대역폭 | ||||
|
|
|||||||
표 69. 하드웨어 구성 microEnable 5 marathon
각 하드웨어 플랫폼에서 장치 리소스는 제한되어 있습니다. 아래 목록은 지원되는 모든 플랫폼에서 사용 가능한 리소스를 보여줍니다. 연산자는 장치 리소스를 소모하며, 대부분의 리소스 인스턴스는 한 번만 사용할 수 있습니다. 이 규칙에는 몇 가지 예외가 있는데, 예를 들어, GPI 연산자 등이 있습니다. 이러한 경우, 리소스 소비에 대한 내용은 해당 연산자의 참조 문서에 명시되어 있습니다.
장치 리소스는 다음 중 하나로 할당됩니다.
-
자동으로,
-
연산자 매개변수를 사용하거나, 또는
-
'리소스' 대화 상자에서.
자세한 내용은 ‘장치 리소스 할당’을 참조하십시오.
| 자료 | imaFlex 2 Dual 100 | ||||||||
|---|---|---|---|---|---|---|---|---|---|
| Port[0] CoF 레인 |
4 | ||||||||
| 포트[1] CoF 레인 |
4 | ||||||||
| Port[0] CoF 수신 트리거 레인 |
4 | ||||||||
| 포트[1] CoF RX 트리거 레인 |
4 | ||||||||
| Port[0] CoF TX 트리거 레인 |
4 | ||||||||
| 포트[1] CoF TX 트리거 레인 |
4 | ||||||||
| Port[0] CoF 상태 레인 |
4 | ||||||||
| 포트[1] CoF 상태 레인 |
4 | ||||||||
| 포트[0] DF 수신 데이터 레인 |
4 | ||||||||
| 포트[1] DF RX 데이터 레인 |
4 | ||||||||
| 포트[0] DF RX 메타 레인 |
4 | ||||||||
| 포트[1] DF RX 메타 레인 |
4 | ||||||||
| 포트[0] DF 송신 데이터 레인 |
4 | ||||||||
| 포트[1] DF TX 데이터 레인 |
4 | ||||||||
| 포트[0] DF TX 메타 레인 |
4 | ||||||||
| 포트[1] DF TX 메타 레인 |
4 | ||||||||
| 포트[0] DF 그린 LED 레인 |
4 | ||||||||
| Port[0] DF Red LED 차선 |
4 | ||||||||
| 포트[1] DF 그린 LED |
1 | ||||||||
| 포트[1] DF 레드 LED |
1 | ||||||||
| DmaToHostPort |
5 | ||||||||
| DmaFromHostPort |
1 | ||||||||
| GPI |
16 | ||||||||
| GPO |
16 | ||||||||
| EventPort |
31 | ||||||||
| 이벤트 ID |
64 | ||||||||
| 사용자 LED |
6 | ||||||||
| ImageChannel |
1024 | ||||||||
| RAM |
2 @ 1 x 5 GiB에서 8 x 625 MiB로 | ||||||||
|
|||||||||
표 70. 장치 리소스 목록 imaFlex 2 Dual 100
| 자료 | imaFlex CXP-12 Quad | imaFlex CXP-12 Penta | ||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Camera Port | 4 | 5 | ||||||||||||
| CxpStatusPort | 4 | 5 | ||||||||||||
| CxpRxTriggerPort | 4 | 5 | ||||||||||||
| CxpTxTriggerPort | 4 | 5 | ||||||||||||
| DMA | 4 | 5 | ||||||||||||
| DmaFromHostPort | 1 | 1 | ||||||||||||
| GPO |
10 OUT | 12 OUT | ||||||||||||
| GPI |
12인치 | 12인치 | ||||||||||||
| LED 항구 |
6 | 6 | ||||||||||||
| SignalChannel |
4000 | 4000 | ||||||||||||
| EventPort |
32 | 32 | ||||||||||||
| 이벤트 ID |
64 | 64 | ||||||||||||
| ImageChannel |
1024 | 1024 | ||||||||||||
RAM |
1 x 1.5 GiB에서 8 x 192 MiB로 | 1 x 2.5 GiB에서 8 x 320 MiB로 | ||||||||||||
|
||||||||||||||
표 71. imaFlex CXP-12 Quad 및 imaFlex CXP-12 Penta
표 72. 장치 리소스 목록 microEnable 5 marathon
imaFlex 2 Dual 100 플랫폼에는 각각 5 GiB 용량을 가진 두 개의 별도 물리적 RAM 뱅크가 포함되어 있습니다. 이러한 물리적 뱅크는 애플릿에서 사용되는 RAM 기반 VisualApplets 연산자의 수에 따라 필요에 따라 중복되지 않는 메모리 영역으로 나뉩니다. VisualApplets 내에서는 이러한 영역이 가상 RAM 뱅크로 표시됩니다. 연산자가 RAM을 필요로 할 때, 해당 연산자는 가상 RAM 뱅크를 할당받게 되며, 이는 물리적 RAM 내의 전용 비중첩 영역에 해당합니다.
VisualApplets 의 메모리 연산자에 대한 실용적인 지침은 ‘메모리 요소 자습서’ 항목을 참조하십시오.
imaFlex 2 Dual 100 플랫폼에서는 물리적 RAM 뱅크당 최대 8개의 중복되지 않는 메모리 영역을 정의할 수 있으며, 이는 두 RAM 인터페이스에 걸쳐 총 16개의 영역을 의미합니다. 물리적 인터페이스에 RAM 연산자가 단 하나만 할당된 경우, 해당 연산자는 해당 인터페이스의 전체 용량인 5 GiB에 모두 접근할 수 있습니다. 여러 오퍼레이터가 동일한 물리적 인터페이스를 공유하는 경우, 사용 가능한 메모리는 오퍼레이터들 간에 비례적으로 분배됩니다. 예를 들어, 동일한 인터페이스에 8개의 오퍼레이터가 할당된 경우, 각 오퍼레이터는 5 GiB 메모리의 1/8을 할당받게 되며, 결과적으로 오퍼레이터당 약 0.625 GiB를 사용하게 됩니다.
imaFlex 2 Dual 100 의 RAM 대역폭은 동일한 물리적 인터페이스에 연결된 모든 오퍼레이터 간에 균등하게 공유되며, 어느 특정 오퍼레이터에게만 독점적으로 할당되지는 않습니다.
-
특정 설계에서 하나의 인터페이스에 할당된 8개의 RAM 리소스를 모두 사용하는 경우, 각 RAM 기반 연산자는 해당 연산자의 효율 계수에 따라 조정된, 전체 인터페이스 대역폭의 약 1/8을 할당받게 됩니다.
-
RAM 기반 오퍼레이터가 하나만 사용되는 경우, 해당 인터페이스의 최대 대역폭을 모두 활용할 수 있습니다.
-
두 통신 사업자가 동일한 인터페이스를 공유하는 경우, 각 사업자는 전체 대역폭의 절반을 할당받게 되며, 이와 같은 방식으로 배분됩니다.
플랫폼의 2개 물리적 RAM 인터페이스는 VisualApplets 에서 16개의 가상 RAM 포트에 매핑됩니다. 첫 번째 RAM 인터페이스는 RAM 리소스 인덱스 0부터 7까지에 매핑되고, 두 번째는 RAM 리소스 인덱스 8부터 15까지에 매핑됩니다.
할당되지 않은(따라서 사용되지 않는) RAM 포트는 항상 메모리 용량의 0%를 할당받습니다. 즉, 사용 가능한 총 메모리는 RAM 포트를 적극적으로 사용하고 있는 연산자들끼리만 분배됩니다.
-
포트가 1개만 사용되는 경우: 해당 포트는 사용 가능한 메모리의 100%를 할당받습니다.
-
2개의 포트를 사용하는 경우: 각 포트는 사용 가능한 메모리의 50%를 할당받습니다.
-
3개의 포트가 사용되는 경우: 리소스 ID가 가장 낮은 포트가 50%를 할당받으며, 나머지 2개의 포트는 각각 25%를 할당받습니다.
-
4개의 포트를 사용하는 경우: 4개 포트 모두 각각 25%씩 할당받습니다.
-
5개의 포트가 사용되는 경우: 첫 번째 3개 포트(리소스 ID가 가장 낮은 포트)는 각각 25%를 할당받으며, 나머지 2개 포트는 각각 12.5%를 할당받습니다.
-
6개의 포트가 사용되는 경우: 리소스 ID가 가장 낮은 2개의 포트는 각각 25%를 할당받고, 나머지 4개의 포트는 각각 12.5%를 할당받습니다.
-
7개의 포트가 사용되는 경우: 리소스 ID가 가장 낮은 포트가 25%를 할당받으며, 나머지 6개의 포트는 각각 12.5%를 할당받습니다.
-
8개의 포트를 사용하는 경우: 모든 포트가 각각 12.5%씩 할당받습니다.
 |
비대칭 메모리 할당 |
|---|---|
|
비대칭 크기 분할의 경우, 동일한 물리적 뱅크 내에서 RAM 인덱스가 가장 낮은 포트에 더 많은 할당량이 주어집니다. 예를 들어, 3개의 RAM 포트 (0, 1, 2)가 사용되는 경우, 포트 0은 RAM 크기의 50%를 할당받는 반면, 포트 1과 2는 각각 25%를 할당받습니다. 포트 8, 9, 10의 경우에도 마찬가지입니다. 이 포트들은 두 번째 RAM 인터페이스에 매핑되지만 여전히 동일한 물리적 RAM 뱅크에 속하기 때문입니다. |
RAM 인덱스는 연속적일 필요가 없으며, 절대 순서에 따라 할당이 결정됩니다. RAM 인덱스는 가상 식별자이므로, 시퀀스에 공백이 있더라도 FPGA 리소스 사용량에는 영향을 미치지 않습니다. 예를 들어, 3개의 RAM 포트 (1, 5, 7)이 사용되는 경우: 포트 1은 RAM 크기의 50%를 할당받고, 포트 5와 7은 각각 25%를 할당받습니다.
모든 리소스가 동일한 물리적 뱅크에 매핑될 경우, RAM 인덱스의 할당 방식에 따른 장단점은 없습니다. VisualApplets 에서 제공하는 자동 할당 기능을 사용하거나, 특정 설계 연산자가 다른 연산자보다 더 많은 RAM을 필요로 하는 경우 수동으로 조정할 수 있습니다.
|
독립형 RAM 인터페이스 |
|---|---|
|
두 물리적 RAM 인터페이스는 완전히 독립적입니다. 예를 들어, 두 개의 연산자를 사용하며 그중 하나는 첫 번째 RAM 인터페이스에, 다른 하나는 두 번째 인터페이스에 할당된 경우, 각 연산자는 해당 인터페이스의 최대 RAM 용량을 모두 활용할 수 있습니다. |
공유 메모리 컨트롤러는 라운드 로빈(Round-robin) 알고리즘을 사용하여 물리적 RAM 인터페이스 내의 모든 할당된 포트에 대역폭을 균등하게 분배합니다. 이 알고리즘은 크레딧 기반 중재 방식에 기초합니다. 포트가 활성 상태가 되면, 새로운 RAM 작업을 계속 제공하는 한 설정된 크레딧 클럭 사이클 수 동안 활성 상태를 유지합니다. 활성 포트에서 더 이상 작업이 없으면 비활성화되며, 활성화 토큰은 대기 중인 요청이 있는 다음 포트로 이동합니다. 이를 통해 유휴 포트에 대역폭이 낭비되지 않도록 보장합니다.
크레딧 값은 애플릿 합성 과정에서 펌웨어에 의해, 사용된 RAM 연산자의 수를 기준으로 프로그래밍됩니다. 이 값은 실행 중이거나 Framegrabber SDK 을 통해서도 변경할 수 없습니다. 사용자는 크레딧 설정에 접근할 수 없습니다.
포트가 활성화된 상태에서는 메모리 컨트롤러 대역폭의 100%를 차지합니다. 물리적 뱅크에 있는 8개의 포트가 모두 균등하게 활성화된 경우, 각 포트는 시간이 지남에 따라 전체 대역폭의 약 1/8을 할당받게 됩니다. 그 외의 경우에는 실제 평균 대역폭이 각 포트의 부하에 따라 달라집니다.
물리적 RAM 인터페이스는 완전히 독립적입니다. RAM 기반 연산자를 서로 다른 인터페이스에 할당하면 대역폭 효율을 극대화할 수 있습니다. 대역폭은 동일한 물리적 RAM 인터페이스에 연결된 연산자들 사이에서만 공유됩니다.
imaFlex CXP-12 Quad 및 imaFlex CXP-12 Penta 플랫폼은 단 하나의 물리적 RAM 뱅크(크기는 플랫폼에 따라 다름)로만 구성됩니다. 이 단일 물리적 뱅크는 애플릿 내에서 사용되는 RAM 기반 VisualApplets 연산자의 양에 따라 중복되지 않는 영역으로 동적으로 포맷됩니다. 이러한 영역들은 VisualApplets 내에서 가상 RAM 뱅크로 표현됩니다. 연산자가 RAM 리소스를 예약하면, 물리적 RAM 내의 배타적이고 중복되지 않는 메모리 영역에 매핑되는 가상 RAM 뱅크를 사용하게 됩니다. imaFlex 플랫폼에서는 최대 8개의 중복되지 않는 영역을 정의할 수 있습니다. RAM 연산자가 1개만 사용되는 경우, 해당 연산자는 플랫폼의 전체 RAM 크기를 할당받습니다. 추가 운영자마다 할당되는 크기는 해당 운영자가 동일한 물리적 인터페이스에 도킹된 수에 비례하여 해당 운영자가 소유한 크기를 비례적으로 감소시킵니다. 8명의 운영자가 사용될 경우, 각 운영자에게는 플랫폼 메모리 크기의 1/8이 할당됩니다.
그러나 RAM 대역폭은 설계 내의 모든 RAM 기반 연산자 간에 공유됩니다. 설계에서 8개의 RAM 리소스를 모두 활용하는 경우, 8개의 RAM 기반 연산자 각각은 최대 1/8 GB/s의 전용 대역폭을 가질 수 있으며, 여기에서 해당 연산자의 효율 계수를 차감합니다. 설계에서 RAM 기반 연산자가 단 하나만 사용되는 경우, 이 연산자는 플랫폼의 전체 대역폭을 할당받습니다. 연산자가 2개 사용되는 경우, 두 연산자 각각은 전체 대역폭의 절반을 할당받으며, 이와 같은 방식으로 배분됩니다.
할당되지 않아 사용되지 않는 RAM 포트는 항상 메모리 용량의 0%를 차지합니다.
-
1개의 포트가 사용 중입니다: 사용 중인 포트의 사용률이 100%입니다.
-
2개의 포트가 사용되며, 사용된 두 포트 모두 50%를 차지합니다.
-
3개의 포트가 사용되며, 리소스 ID 번호가 가장 낮은 포트가 50%를 차지하고, 나머지 2개의 사용 중인 포트는 각각 25%를 차지합니다.
-
4개의 포트가 사용되며, 4개 포트 모두 25%씩 할당됩니다.
-
5개의 포트가 사용됩니다. 리소스 ID 번호가 가장 낮은 3개의 포트는 25%를 할당받습니다. 나머지 2개의 포트는 12.5%를 할당받습니다.
-
6개의 포트가 사용됩니다. 리소스 ID 번호가 가장 낮은 2개의 포트는 25%를 할당받습니다. 나머지 4개의 포트는 12.5%를 할당받습니다.
-
7개의 포트가 사용됩니다. 리소스 ID 번호가 가장 낮은 포트는 25%를 할당받습니다. 나머지 6개의 포트는 각각 12.5%를 할당받습니다.
-
8개의 포트가 사용되며, 모든 포트에 12.5%씩 할당됩니다.
|
|
|
RAM 지수가 낮은 포트는 비대칭 크기 분할이 이루어지는 경우 더 많은 RAM을 할당받게 됩니다. 예를 들어, 0, 1, 2번 RAM 포트 3개가 사용된다고 가정해 보겠습니다. 0번 포트에는 RAM 용량의 50%가 할당됩니다. 1번과 2번 포트에는 각각 25%씩 할당됩니다. RAM 인덱스는 연속적일 필요가 없으며, 절대적인 순서에 따라 할당이 결정됩니다. RAM 인덱스는 가상 번호이므로, 순서에 간격이 있어도 FPGA 리소스 사용량에는 영향을 미치지 않습니다. 예를 들어, 3개의 RAM 포트( 1, 5, 7)가 사용된다고 가정해 보겠습니다. 포트 1에는 RAM 크기의 50%가 할당되고, 포트 5와 7에는 각각 25%씩 할당됩니다. 연산자의 RAM 인덱스를 할당할 때 특별한 장단점은 없습니다. 자동 할당 VisualApplets 을 사용하거나, 특정 설계 연산자가 다른 연산자보다 더 많은 RAM 용량을 필요로 할 경우 수동으로 조정하십시오. |
공유 메모리 컨트롤러는 라운드 로빈(Round-robin) 알고리즘을 적용하여 할당된 모든 포트에 대역폭을 균등하게 분배합니다. 이 알고리즘은 크레딧 중재 방식을 사용합니다. 포트가 활성 상태가 되면, 해당 포트가 새로운 RAM 작업을 제공하는 한 크레딧에 해당하는 클럭 사이클 동안 활성 상태를 유지할 수 있습니다. 포트가 활성화된 후 더 이상 작업이 없으면, 해당 포트는 비활성화되고 활성화 토큰은 대기 중인 요청 작업이 있는 다음 순서의 포트로 이동합니다. 이러한 방식으로 대역폭이 유휴 상태로 낭비되는 일이 없습니다. 크레딧은 사용된 RAM 연산자의 양에 따라 애플릿 합성 단계에서만 펌웨어에 의해 프로그래밍되며, Framegrabber SDK /실행 중에는 변경할 수 없습니다. 사용자는 크레딧 설정에 접근할 수 없습니다. 활성 포트가 RAM 인터페이스를 소유하고 있는 동안에는 메모리 컨트롤러의 대역폭 100%에 접근할 수 있습니다. 8개의 포트가 모두 사용되고 균등하게 활성화된 경우, 시간 경과에 따른 각 포트의 대역폭은 1/8이 됩니다. 그 외의 모든 경우에는, 포트에 가해지는 부하가 각 포트의 실제 평균 대역폭을 결정합니다.
microEnable 5 marathon 플랫폼은 단 하나의 물리적 RAM 뱅크(크기는 플랫폼에 따라 다름)로만 구성됩니다. 이 단일 물리적 뱅크는 서로 겹치지 않는 4개의 메모리 영역으로 포맷됩니다. 이 4개의 영역은 VisualApplets 내에서 4개의 가상 RAM 뱅크로 표현됩니다. 운영자가 RAM 리소스를 예약할 때, 이는 물리적 RAM 내부의 배타적이고 중복되지 않는 메모리 영역에 매핑되는 가상 RAM 뱅크를 사용하는 것입니다.
그러나 RAM 대역폭은 설계 내의 모든 RAM 기반 연산자 간에 공유됩니다. 설계가 4개의 RAM 리소스를 모두 활용할 경우, 4개의 RAM 기반 연산자 각각은 최대 1.6 GB/s의 전용 대역폭을 가질 수 있으며, 여기에서 해당 연산자의 효율 계수를 차감합니다. 설계에서 RAM 기반 연산자가 단 하나만 사용되는 경우, 이 연산자는 총 대역폭 6.4 GB/s를 모두 확보합니다. 연산자가 2개 사용될 경우, 두 연산자 각각은 총 대역폭의 절반을 확보하게 되며, 이와 같은 방식으로 배분됩니다.
|
운영자당 대역폭 |
|---|---|
|
온보드 RAM은 총 6.4GB/s의 대역폭을 제공합니다. 개별 RAM 기반 연산자에 사용할 수 있는 대역폭은 총 대역폭을 설계 내의 모든 인스턴스화된 RAM 기반 연산자의 수로 나눈 값입니다. |
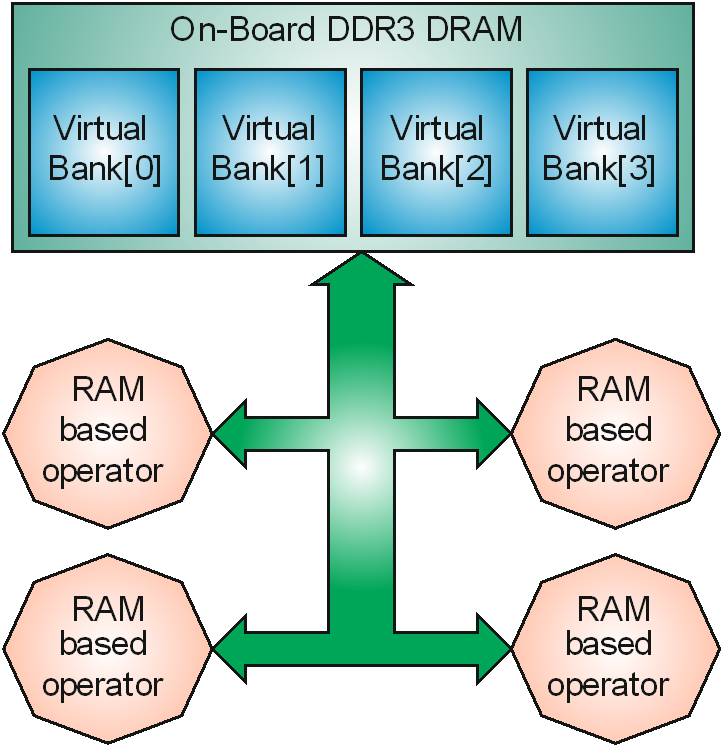
RAM 기반 연산자를 사용하여 설계할 때는 이 RAM 아키텍처를 고려해야 합니다.
공유 대역폭 아키텍처로 인해, 애플릿 개발자는 여러 개의 RAM 기반 연산자를 사용할 때, 비록 단일 RAM 연산자의 입력에 필요한 대역폭이 더 적더라도, 메모리 인터페이스(RAM 데이터 폭)의 256 비트를 모두 활용하여 메모리 인터페이스를 통한 처리량을 극대화해야 합니다.
imaFlex 2 Dual 100 는 C0와 C1이라는 두 가지 광섬유 QSFP28 커넥터를 제공합니다.
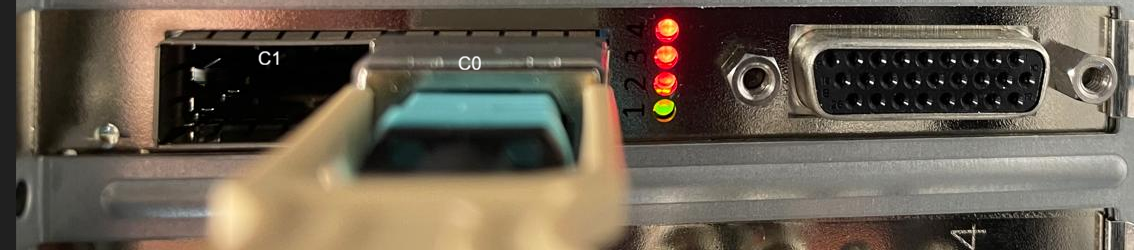
두 커넥터 모두 CXP over Fiber( CoF ) 및 데이터 전달 프로토콜을 지원합니다. 각 광섬유 커넥터에는 고유한 LED가 있습니다. 커넥터 C0에는 4개의 LED가, 커넥터 C1에는 LED 1개가 할당되어 있습니다.
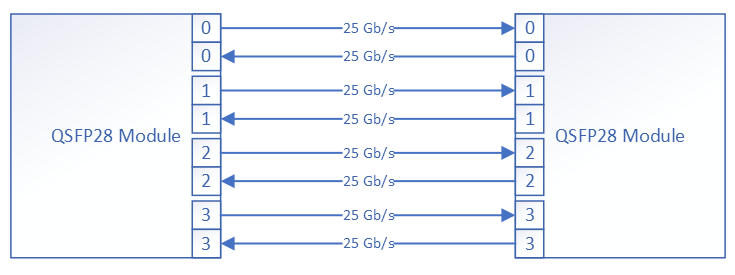
각 커넥터는 QSFP28 광 모듈을 지원합니다. QSFP28 인터페이스는 양방향으로 4개의 광섬유 연결, 즉 4개의 RX 및 4개의 TX 연결을 제공합니다. 광섬유 연결을 레인 이라고 합니다. 각 QSFP28 포트에는 RX 및 TX 방향 모두에 4개의 광 라고 합니다. 각 QSFP28 포트에는 RX 및 TX 방향 모두에 4개의 광섬유 레인이 있으며, 0부터 3까지 번호가 매겨져 있습니다. 각 레인은 25 Gbit/s로 작동합니다. 따라서 단일 QSFP28 커넥터는 TX 및 RX 방향에서 총 100 Gbit/s의 누적 대역폭을 전송할 수 있습니다.
imaFlex 2 Dual 100 여러 프레임 그래버 간에 데이터를 양방향으로 전송할 수 있는 데이터 전달 기능을 제공합니다. VisualApplets 의 데이터 전달 기능은 데이지 체인 및 더 진보된 모델을 포함하여 데이터와 메타데이터를 전송하기 위한 다양한 토폴로지를 지원합니다. 데이터 전달 동작은 VisualApplets 연산자를 통해 사용자가 완전히 제어할 수 있습니다. 카메라 데이터, 애플릿에서 생성된 데이터 및 메타데이터는 TX 및 RX 양방향으로 독립적으로 전송될 수 있습니다. 또한 VisualApplets 는 레인을 다중화하여, 두 개의 별도 가상 채널을 사용하여 단일 광섬유 레인을 통해 메타데이터와 일반 이미지 데이터를 동시에 전송할 수 있게 합니다. 메타데이터는 적시에 전달될 수 있도록 우선순위가 부여됩니다.
파이버 기술은 양방향 통신을 지원하기 때문에, 고급 마스터-슬레이브 애플리케이션을 통해 마스터가 슬레이브 장치가 수신할 데이터를 제어하고, 해당 장치들로부터 처리 결과를 수집할 수 있습니다. 슬레이브의 GPU 또는 CPU에서 생성된 처리 결과는 다음을 통해 다시 전송될 수 있습니다 DmaFromPC 를 통해 다시 전송된 후, 데이터 전달 연산자를 거쳐 마스터 프레임 그래버로 다시 전달될 수 있습니다.
일반적인 데이터 전달 데이지 체인 구성에서는, 선택된 카메라 데이터가 여러 프레임 그래버로 전달됩니다. 그런 다음 이 프레임 그래버들은 PCIe 를 통해 매우 낮은 지연 시간으로 데이터를 외부 GPU 로 전송합니다.
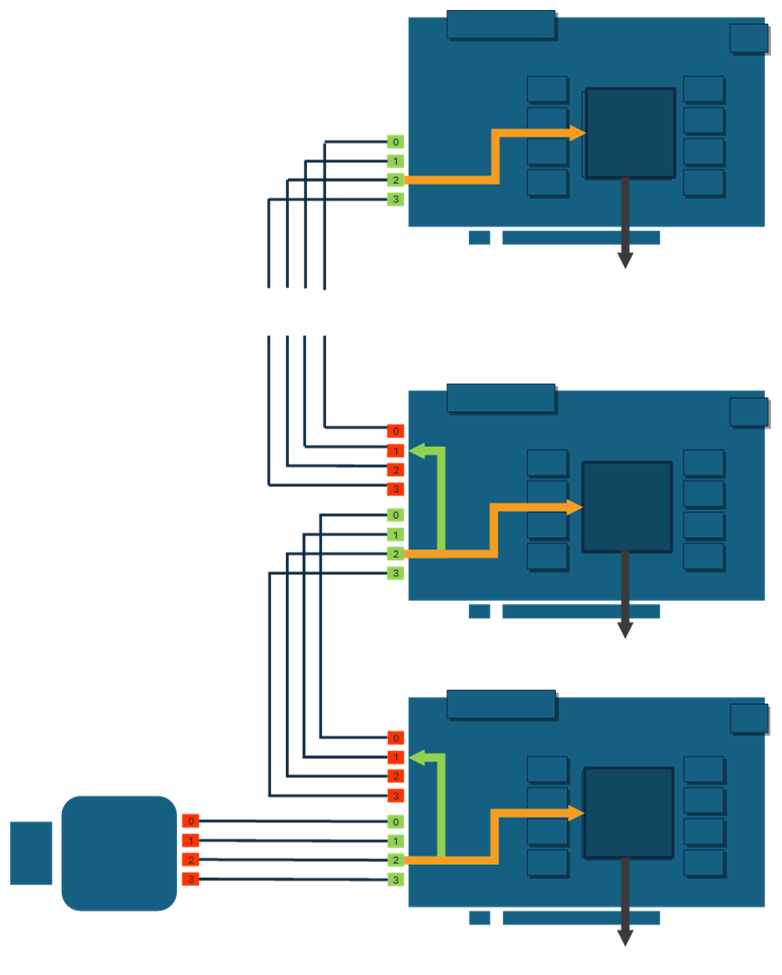
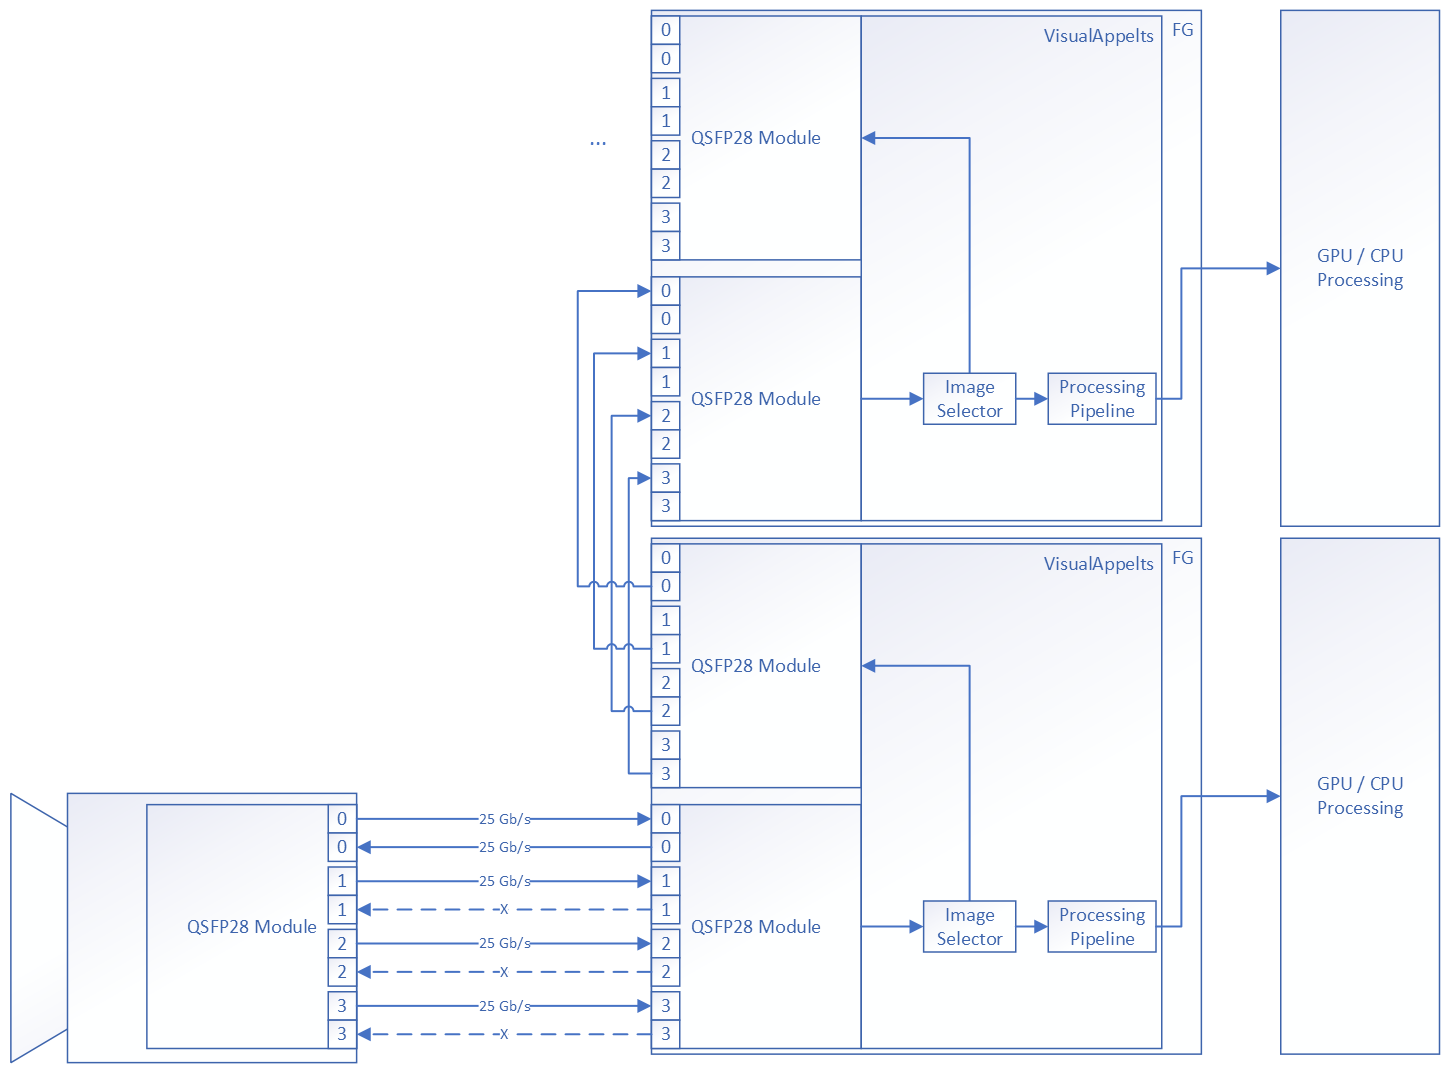
CoF (CXP over Fiber)는 4개의 다운스트림 연결과 1개의 업스트림 연결을 사용합니다. 두 프레임 그래버 간의 데이터 전달 링크는 필요한 데이터만 전송하도록 구성되어 있으며, 네이티브 CoF 트래픽을 전송하지 않고 대신 VisualApplets 데이터 및 메타데이터 스트림을 전달합니다. CoF 와 데이터 전달 모두 전방 오류 정정 (FEC)에 의해 보호됩니다.
마스터 프레임 그래버는 카메라에 연결되어 선택된 데이터 부분을 다음 슬레이브 프레임 그래버로 전달합니다. 각 슬레이브 프레임 그래버는 자체 처리에 필요한 데이터를 추출한 후, 이미지 스트림 중 처리되지 않은 나머지 부분을 순서상 다음 슬레이브로 전달합니다. 체인의 마지막 프레임 그래버는 종단점 역할을 하며, 데이터를 더 이상 전달하지 않습니다.
위의 예시는 데이지 체인 토폴로지를 단순화하여 나타낸 것입니다. 보다 복잡한 구성에서는, 서로 연결된 두 프레임 그래버가 자유롭게 데이터를 교환할 수 있습니다. 즉, 서로 간에 1레인, 2레인, 3레인 또는 4레인 연결을 형성할 수 있습니다. RX 및 TX 방향은 서로 다른 수의 레인을 사용할 수 있습니다.
여러 광 레인을 가상 채널로 결합할 수 있어, 단일 QSFP28 커넥터를 통해 여러 데이터 채널을 전송할 수 있습니다. 이미지 데이터 전송 외에도, VisualApplets 는 각 광 레인마다 전용 메타 채널을 제공합니다. 이 메타 채널은 일반 이미지 데이터보다 우선 순위가 높으며, 지터와 지연 시간이 매우 낮게 전송되므로, 애플리케이션에서 타임스탬핑 및 보드 간 동기화를 구현할 수 있습니다. 메타 채널을 통해 소량의 사이드밴드 정보도 전송할 수 있으며, 예를 들어 광섬유 연결의 반대편 끝에 있는 슬레이브 파트너를 구성하는 데 사용할 수 있습니다. 파트너는 자체 메타 채널을 통해 제어 및 상태 정보를 마스터로 다시 전송할 수 있습니다. 또한 각 프레임 그래버는 처리된 이미지 데이터를 최대 100 Gb/s의 집계 대역폭으로 파트너에게 전송할 수 있습니다.
단일 QSFP28 인터페이스를 통해 두 프레임 그래버 사이에 최대 4개의 메타 채널을 TX 및 RX 방향별로 독립적으로 연결할 수 있습니다. 각 메타 채널은 25 Gb/s로 작동합니다. 이미지 데이터 채널은 1, 2, 3 또는 4개의 광 레인을 연결하여 가상 데이터 전송 채널을 형성할 수 있습니다.
QSFP28 데이터 전달 인터페이스는 다음과 같은 가상 데이터 채널 조합을 지원합니다:
-
1 x 4채널: 100 Gbit/s
-
1 x 3채널 75 Gbit/s로 작동하며 1 x1 채널 25 Gbit/s로 전송
-
2 x 2채널 각각 50 Gbit/s로 작동
-
1 x 2채널 50 Gbit/s로 작동하며 2 x 1 채널 25 Gbit/s로 동작
-
4개의 1채널 각 채널당 25 Gbit/s로 동작
RX 측과 TX 측은 완전히 독립적으로 작동합니다. 즉, 후진(RX) 방향은 필요에 따라 구현하거나 생략할 수 있습니다. 이를 구현하더라도 전진(TX) 방향과 대칭을 이룰 필요는 없습니다.
메타 채널과 데이터 채널은 독립적으로 작동합니다. 각 메타 채널은 정확히 하나의 광섬유 레인을 사용하며 25 Gb/s의 속도로 전송됩니다. 메타 채널은 소량의 데이터를 전송하도록 설계되었습니다. 메타 채널은 우선권을 가지기 때문에, 메타 채널 전송이 시작되면 동일한 광섬유 레인에서 진행되던 일반 데이터 전송이 일시적으로 중단됩니다.
데이터 전달 기능을 지원하기 위해, VisualApplets 는 다음과 같은 연산자를 제공합니다:
Basler는 데이터 전달 예제를 VisualApplets 형식의 설계와 C++
SDK 제어 애플리케이션 형태로 제공합니다. 이 예제들을 통해 해당 연산자를 사용하여
데이터를 전달하는 방법을 확인할 수 있습니다. 해당 예제는 VisualApplets 예제로 다음 주소에서 확인할 수 있습니다. Examples/Acquisition/DataForwarding. 이러한 데이터 전달 예제에 대한 설명서는 '광섬유 기반 CoaXPress 프레임 그래버를 위한 데이터 전달' 주제: 기본 사항 및 예제.
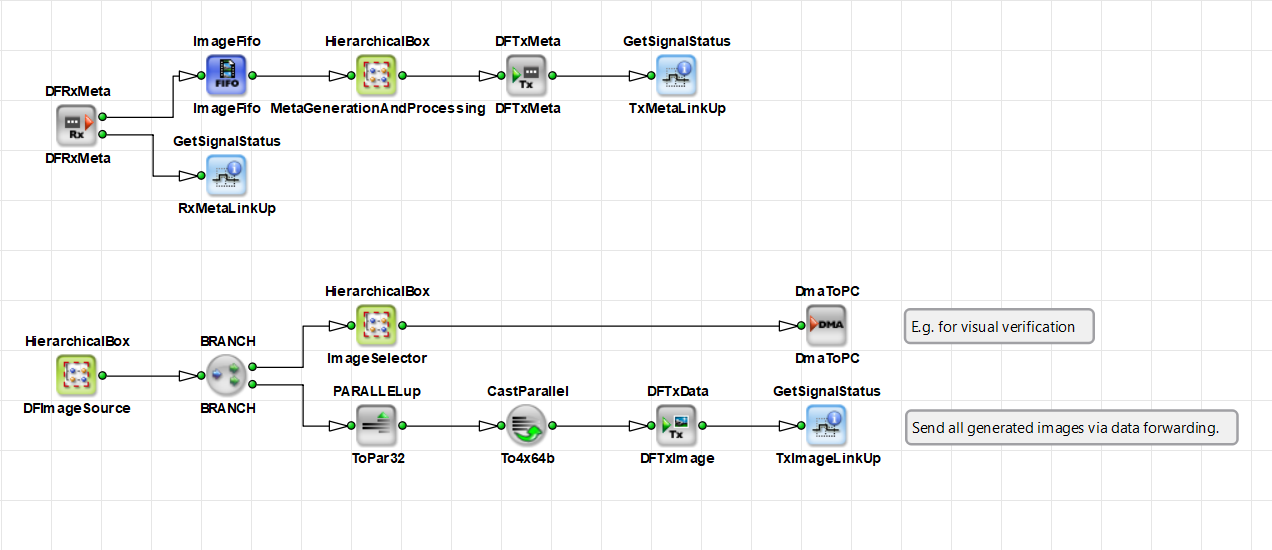
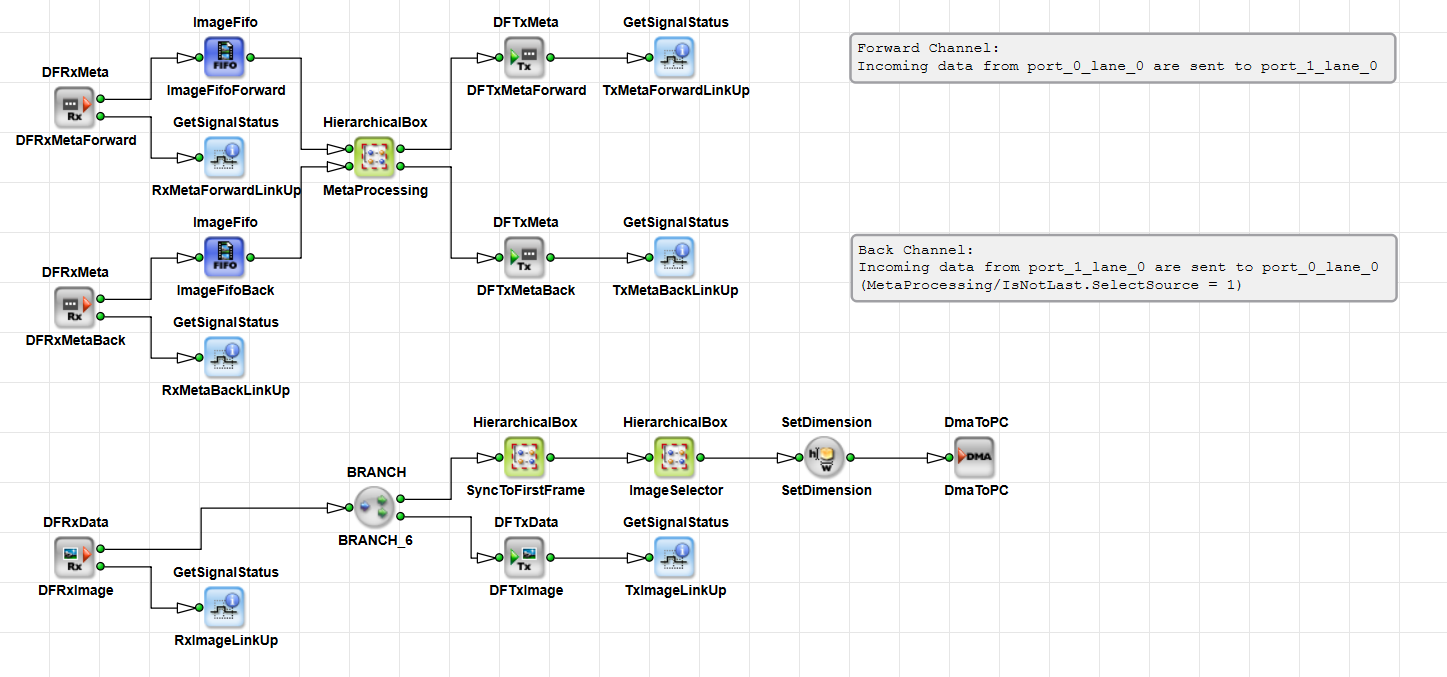
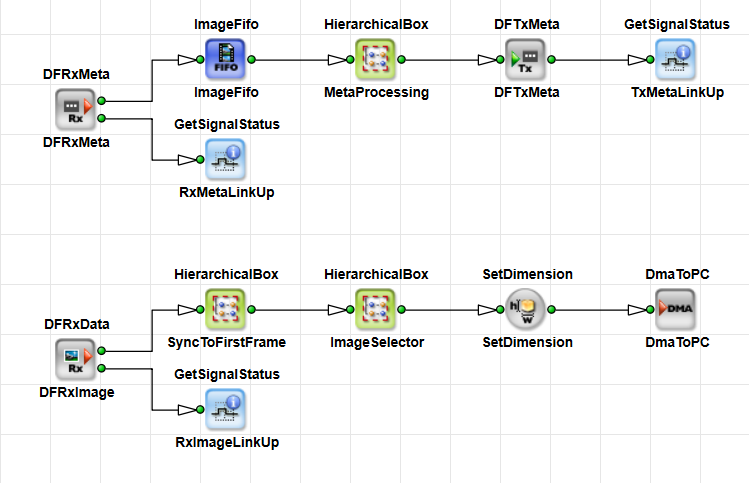
특정 제한 조건 하에서는 보다 복잡한 카메라-프레임 그래버 모델도 구현할 수 있습니다. 두 프레임 그래버 간의 광 전송 지연 시간은 매우 짧습니다. 한 프레임 그래버에서 다른 프레임 그래버로 데이터 워드가 이동하는 데 걸리는 시간은 약 120 ns입니다.
데이지 체인 토폴로지는 여러 CPU/GPU 클러스터에 걸쳐 처리 부하를 분산시키는 데 가장 일반적으로 사용되는 방식입니다:
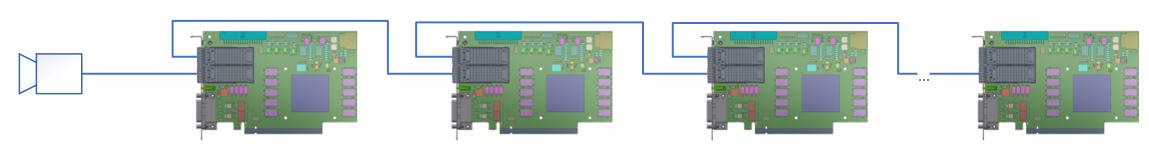
마스터 프레임 그래버는 카메라에 연결되며, 두 번째 QSFP28 포트는 다음 슬레이브에 연결됩니다. 각 슬레이브는 수신된 데이터의 일부를 처리하고 나머지 데이터를 다음 장치로 전달합니다. 체인의 마지막 프레임 그래버는 종단점 역할을 합니다. 마지막 프레임 그래버를 제외한 모든 프레임 그래버는 두 개의 QSFP28 포트를 모두 사용합니다.
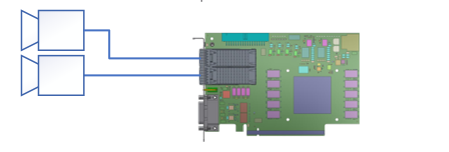
일부 응용 분야의 경우, 두 대의 100Gb/s 카메라를 단일 프레임 그래버에 연결할 수 있습니다. 이를 위해서는 카메라가 최대 대역폭으로 작동하지 않아야 하거나, 데이터를 RAM에 저장하기 전에 VisualApplets 에서 전처리를 수행하여 대역폭을 약간 줄여 두 카메라 스트림이 두 개의 RAM 인터페이스에 모두 들어갈 수 있도록 해야 합니다. 이러한 구성에서 프레임 그래버는 VisualApplets 에서 추가 처리를 수행하여 결과 데이터 전송 속도를 약 13 GB/s인 PCIe 의 제한된 처리량에 맞출 수 있도록 해야 합니다.
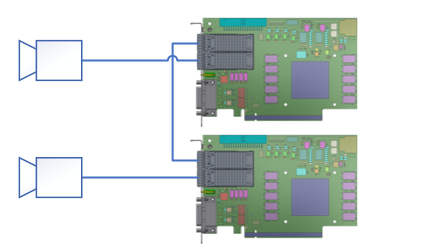
이 경우, 각 프레임 그래버는 각각의 카메라에 연결됩니다. 두 번째 QSFP28 포트는 프레임 그래버 간 통신에 사용되며, 이를 통해 복잡한 컴퓨팅 작업 및 동기화를 위해 양방향으로 최대 100 Gbit/s의 속도로 데이터를 교환할 수 있습니다.
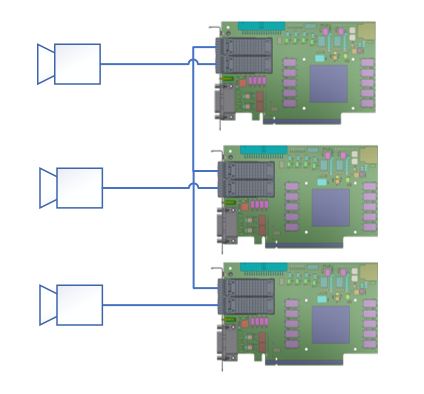
이 토폴로지에서는 각 프레임 그래버가 전용 카메라 하나에 연결됩니다. 중앙 프레임 그래버는 남은 QSFP28 포트를 사용하여, 4개의 레인을 각각 2개의 레인을 가진 두 개의 QSFP28 모듈로 분할하는 특수 광케이블을 통해 다른 두 대의 마스터 프레임 그래버에 연결됩니다. 두 개의 가장 바깥쪽 프레임 그래버에 대한 유일한 직접 연결은 각 카메라로 연결되는 4레인 전체 링크와 중앙 프레임 그래버로 연결되는 2레인 링크뿐입니다. 이 두 레인을 통해 프레임 그래버 간에 최대 50 Gbit/s의 속도로 통신이 가능합니다.
 이전

