Memory 요소#
이 토픽에서는 VisualApplets 디자인의 memory operators가 타겟 하드웨어의 물리적 메모리에 매핑되는 방식과 상황별 사용법을 설명합니다. 이 내용을 숙지하면 FPGA-internal memory(예: 블록 RAM)와 frame grabber DRAM의 차이, FIFO 스타일 버퍼와 임의 접근(random-access) 프레임 버퍼의 차이, 여러 RAM 연산자가 포함된 디자인에서 shared DRAM bandwidth가 제한되는 요인, 그리고 시뮬레이션 및 하드웨어에서 메모리 관련 문제를 파악하는 방법을 이해할 수 있습니다.
Key Terms
FillLevel은 microDisplay X 등에서 런타임 시 하드웨어 버퍼의 사용량을 백분율(%)로 보여줍니다. 버퍼가 100%에 가까운 상태를 유지한다면 병목 현상이나 교착 상태(deadlock)를 의미하는 경우가 많습니다. 시작 단계로 카메라 뒤에 버퍼를 배치해 보세요.
플랫폼 RAM 크기, 데이터 폭, 대역폭 값은 Device Resources를 참조하십시오.
FPGA Memory vs. Frame Grabber DRAM#
VisualApplets 메모리 연산자는 프레임 그래버에 데이터를 저장하는 위치에 따라 두 그룹으로 나뉩니다. 두 번째 구분 기준은 데이터에 접근하는 방식(FIFO 스타일 버퍼 대 임의 접근 또는 멀티 ROI 프레임 버퍼)입니다. 연산자 참조서의 Overview of the Memory Library에서는 각 메모리 연산자가 데이터를 저장하는 위치를 보여줍니다. VisualApplets의 RAM 리소스는 보드 DRAM에 매핑되는 디바이스 리소스 토큰입니다. VisualApplets 애플리케이션 내부의 메모리가 아닙니다.
| Property | FPGA 내부 메모리 | 프레임 그래버 DRAM |
|---|---|---|
| 주요 연산자 | ImageFifo; 소규모 임의 접근(random-access)의 경우, FrameMemoryRandomRd / LineMemoryRandomRd | ImageBuffer, LineBuffer, FrameBufferRandomRead, FrameBufferMultiRoi, FrameBufferMultiRoiDyn |
| 위치 | 보드 내부, FPGA 내부(imaFlex CXP-12 Quad/Penta의 BRAM, LUT RAM 또는 URAM) | 보드 상, FPGA 외부 |
| 용량 | 제한됨, 전체 해상도 프레임이 사용 가능한 FPGA 메모리를 초과하는 경우가 많음 | 높음, 많은 라인 또는 전체 프레임에 적합 |
| 지연 시간 | 낮음, 외장 DRAM 버스에 액세스할 수 없음 | 라인 지향 FIFO는 하나 이상의 라인을 추가함 |
| VisualApplets RAM 리소스 | 아니요 — RAM 디바이스 리소스를 예약하지 않음 | 예 — 인스턴스당 하나의 RAM 리소스가 보드 DRAM에 매핑됨 |
| Bandwidth | 로컬, 오퍼레이터가 프레임 그래버 RAM 인터페이스를 두고 경쟁하지 않음 | 동일한 물리적 인터페이스의 RAM 오퍼레이터 간에 공유됨 — Sharing DRAM Bandwidth 참고 |
Choosing a Memory Operator의 표를 사용하여 오퍼레이터를 선택한 다음, 매개변수 및 플랫폼 세부 정보에 대한 해당 오퍼레이터 섹션을 읽으십시오.
Choosing a Memory Operator#
| 사용 사례 | 선호 |
|---|---|
| 작은 버퍼, 낮은 지연 시간, DRAM 대역폭 비용 없음 | ImageFifo (FPGA 내부) |
| mE5의 Image FIFO, 피크 흡수, ROI | ImageBuffer (DRAM) |
| imaFlex CXP-12 Quad/Penta의 Line FIFO | LineBuffer (DRAM) |
이전 버퍼 SYNC 약간의 지연 시간 포함 | ImageFifo (지연이 큰 경우 더 큰 DRAM 버퍼) |
| 임의의 픽셀 읽기가 가능한 풀프레임 저장소 | FrameBufferRandomRead (DRAM) |
| 하나의 버퍼에서 여러 개 또는 동적 ROI | FrameBufferMultiRoi / FrameBufferMultiRoiDyn (DRAM) |
디자인 가이드라인
카메라에서 발생하는 데이터 버스트를 보정하기 위해 디자인에서 최소 하나 이상의 DRAM operator를 사용할 것을 권장합니다. 해당 DRAM 버퍼는 기본 카메라 디커플링 경로(LineBuffer 또는 ImageBuffer). ImageFifo 카메라 버스트를 흡수해야 할 때 해당 DRAM 버퍼를 대체할 수 없습니다.
ImageFifo#
이 ImageFifo 오퍼레이터가 이미지 데이터를 다음과 같이 대기열에 추가합니다. 선입선출(FIFO) FPGA 내부 메모리의 버퍼. 버퍼 크기는 다음을 통해 지정합니다. EntitiesToStore 및 EntityType 파라미터의 상태를 업데이트합니다. EntityType 값 포함 PIXEL, LINE, 또는 FRAME(으)로 설정합니다. 출력이 여유로울 때 데이터가 즉시 전달됩니다. 다운스트림 모듈이 차단되면 버퍼가 채워집니다.
다음 값 중 하나로 InfiniteSource parameter가 ImageFifo 오퍼레이터 대상 ENABLED 입력이 카메라와 같이 중단할 수 없는 소스에서 오는 경우
정보
이 ImageFifo 오퍼레이터는 상대적으로 적은 수의 픽셀만 버퍼링합니다. 따라서 오퍼레이터에 의해 내부적으로 항상 안정적으로 처리되지는 않는 FIFO 오버플로의 위험이 상당합니다. 중단할 수 없는 스트림의 경우 Basler는 다음 조합을 권장합니다. ImageFifo (이)가 선행되는 Overflow 오퍼레이터 또는 다음 사용 ImageFlowControl operator는 ImageFifo 연산자를 통해 간단히 수행됩니다. 이 ImageFlowControl 오퍼레이터는 FIFO 버퍼링과 통합 오버플로 처리를 결합합니다.
파라미터 ImplementationType 선택할 수 있습니다 AUTO (기본값)을 사용하면, BRAM, LUTRAM, 또는 imaFlex CXP-12 Quad/Penta의 경우 — URAM. Basler에서는 항상 다음을 사용할 것을 권장합니다. AUTO 특정 FPGA 리소스 유형이 부족해지는 경우가 아니라면.
오퍼레이터에 대한 자세한 내용은 Operator Reference의 ImageFifo를 참조하십시오.
ImageBuffer and LineBuffer#
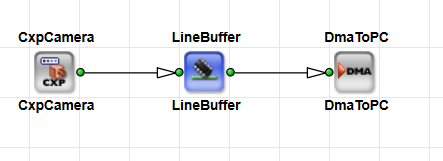
이 ImageBuffer (microEnable 5) 및 LineBuffer (imaFlex) 오퍼레이터는 다음과 같이 작동합니다. 라인 지향 FIFO: 선택된 ROI의 완료된 라인은 후속 모듈이 수용할 수 있게 되는 즉시 전달됩니다. 지연 시간은 최소 1라인입니다. 출력 차단으로 인해 버퍼가 차면 지연 시간이 증가합니다. 다음 내용도 참조하십시오. 지연 시간 Tutorial topic.
Platform Note: ImageBuffer vs. LineBuffer#
| 오퍼레이터 | 플랫폼 |
|---|---|
ImageBuffer | microEnable 5 (mE5) |
LineBuffer | imaFlex CXP-12 Quad / Penta |
imaFlex CXP-12 Quad 및 Penta 지원하지 않습니다 해당 ImageBuffer 연산자. mE5에서 imaFlex로 디자인을 변환할 때 VisualApplets는 대체합니다 각 ImageBuffer 다음이 포함된 operator: LineBuffer 연산자를 통해 간단히 수행됩니다. 이 LineBuffer operator는 imaFlex 플랫폼에 대해 동일한 핵심 버퍼링 및 ROI 기능을 제공합니다.
Defining Regions of Interest (ROI) with ImageBuffer and LineBuffer#
With the ImageBuffer 및 LineBuffer operator를 사용하여 관심 영역(ROI)을 정의할 수도 있습니다. 이는 다음을 설정하여 수행할 수 있습니다. XOffset, XLength, YOffset및 YLength parameters. Edge cases are documented in the Operator Reference: For example, if the input is smaller than the requested ROI, or if your design is in Line1D mode, or if you have undefined content for extra pixels.
이 연산자에 대한 자세한 내용은 ‘연산자 참조’의 LineBuffer 및 ‘연산자 참조’의 ImageBuffer를 참조하십시오.
Monitoring Buffer Usage and Overflow#
이 ImageBuffer 및 LineBuffer operators provide the following status parameters to monitor buffer usage and overflow:
| Parameter | 의미 |
|---|---|
FillLevel | 버퍼 RAM이 채워진 정도를 백분율로 정의합니다(다음 항목: ImageBuffer 25% 단위로). |
LineCount | Indicates the current number of lines stored. Only available for the LineBuffer operator. |
Overflow | 용량을 초과하지 않고는 버퍼가 더 이상 데이터를 수용할 수 없음을 나타냅니다. 이 상태 파라미터는 다음와 동일하지 않습니다. Overflow 동기화 라이브러리의 연산자이며, 산술 오버플로우와는 다릅니다. 참조: 중지 가능 및 중지 불가능 데이터 스트림 튜토리얼 주제 및 Bit Arithmetic Tutorial topic. |
오버플로가 발생하면 입력 데이터가 버려질 수 있으며, 실제 이미지 높이가 줄어들 수 있습니다. 불완전한 이미지는 운영자가 복구할 때까지 메모리에 남아 있을 수 있습니다. Overflow 소스가 중지 불가능한 경우에 적용되며, InfiniteSource 인 경우 ENABLED. 설정: InfiniteSource (으)로 ENABLED 버퍼가 카메라나 다른 무한 소스 바로 뒤에 위치할 때. 다음 항목도 참조하십시오. 중지 가능 및 중지 불가능 데이터 스트림 튜토리얼 주제. 디버깅 시 이러한 매개변수를 사용하는 방법에 대해서는 다음을 참조하십시오. Recognizing Memory-Related Errors.
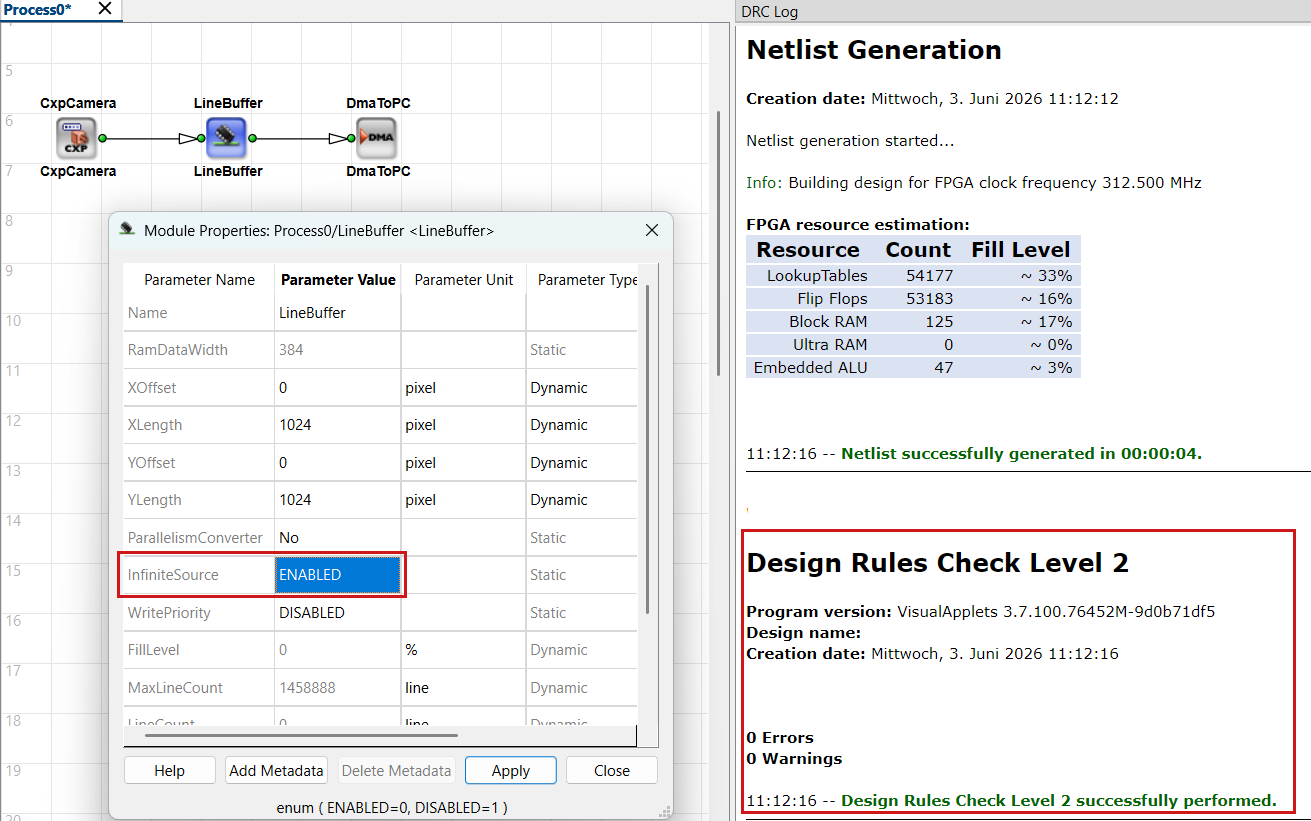
LineBuffer operator의 경우 Basler는 다음 활성화를 권장합니다. WritePriority parameter when InfiniteSource 인 경우 ENABLED. WritePriority 인 경우 ENABLED, 임시 쓰기 속도가 사용 가능한 DRAM 대역폭을 초과하는 동안에는 카메라의 쓰기 버스트가 읽기보다 선호됩니다. 이 평균 대역폭은 여전히 해당 사업자에게 할당된 할당량 범위 내에서 유지되어야 합니다.
이 LineBuffer operator는 모듈 파라미터를 사용하여 입력과 출력 간의 Parallelism을 변환할 수도 있습니다. ParallelismConverter, so you don't always need a separate PARALLELup / PARALLELdn. 또한 다음을 참조하십시오. Parallelism Tutorial topic.
Full Frames, Random Access, Multi-ROI with the FrameBuffer Operators#
이 FrameBufferRandomRead, FrameBufferMultiRoi및 FrameBufferMultiRoiDyn 운영자 스토어 전체 이미지 또는 넓은 영역 임의의 순서로 읽을 수 있는 포함되지 엄격한 라인 FIFO입니다. 임의 픽셀 액세스나 하나의 버퍼에서 여러 개의 ROI가 필요할 때 사용하세요.
FrameBufferRandomRead#
FrameBufferRandomRead 입력 이미지를 DRAM에 기록한 다음, 열 및 행 주소를 통해 픽셀을 읽습니다. 전용 어드레스 포트에서 작동합니다. 기하학적 변환, 리맵핑 및 기타 임의 액세스 패턴에 사용하세요.
소형 프레임이나 라인의 경우 다음과 같은 FPGA 내부 operator를 선호합니다. FrameMemoryRandomRd 또는 LineMemoryRandomRd instead of DRAM operators.
해당 오퍼레이터에 대한 자세한 내용은 오퍼레이터 레퍼런스의 FrameBufferRandomRead를 참조하세요.
FrameBufferMultiRoi and FrameBufferMultiRoiDyn#
이 FrameBufferMultiRoi 및 FrameBufferMultiRoiDyn 오퍼레이터는 이미지 데이터를 저장하고 여러 개의 관심 영역(ROI). FrameBufferMultiRoiDyn 을(를) 출력하며, 제어 링크를 통한 동적 ROI 크기 및 위치 지정을 허용합니다.
Sharing DRAM Bandwidth#
각 DRAM 오퍼레이터에는 RAM 유형의 VisualApplets 리소스가 하나 필요합니다. 해당 리소스는 VisualApplets 리소스 모델의 슬롯입니다. 프레임 그래버의 물리적 DRAM에 매핑됩니다. imaFlex 및 microEnable 5 marathon 플랫폼에서는 RAM 리소스를 예약하는 모든 오퍼레이터가 물리적 DRAM을 공유합니다. 각 오퍼레이터는 전용의 겹치지 않는 메모리 영역을 할당받지만, 크기 및 대역폭은 동일한 물리적 인터페이스에서 활성화된 RAM 오퍼레이터 간에 나뉩니다.
결과:
- 모든 읽기 및 쓰기 작업은 공유 인터페이스에서 대역폭을 소모합니다.
- 여러 DRAM 인스턴스 또는 높은 처리량의 경우 총 트래픽이 플랫폼 한도를 초과할 수 있습니다.
- Excess demand leads to blocking, rising
FillLevel, 오버플로 또는 더 낮은 지속 가능한 프레임 속도.
플랫폼의 RAM size, RAM data width 및 RAM bandwidth total (shared)은 Device Resources에서 확인하세요.
필요한 경우 Resources 대화 상자에서 리소스를 할당하십시오. Device Resources의 Allocation of Device Resources를 참조하십시오.
Bandwidth Calculation Notes#
Shared Memory 어플리케이션 노트에서는 RAM 크기와 RAM 데이터 너비를 효율적으로 사용하는 방법을 설명합니다.
Key points:
-
읽기와 쓰기는 인터페이스를 공유합니다. 단일 DRAM 오퍼레이터의 경우, 사용 가능한 이미지 데이터 속도를 추정할 때 플랫폼 최대 대역폭을 2로 나누고(쓰기용 절반, 읽기용 절반), 효율성 계수를 적용하십시오. 문서화된 대역폭 값은 이론적 최댓값이며 실제 효율성은 그보다 낮습니다.
-
RAM 데이터 너비를 최대한 실용적으로 활용하십시오. 링크의 유효 RAM 데이터 너비는 다음과 같습니다.
bit width × Parallelism × kernel elements
해당 곱은 각 DRAM 액세스의 유효 너비입니다. 이는 Parallelism × Base Design Clock의 픽셀 레이트 대역폭과 혼동해서는 안 됩니다. 최대 DRAM 처리량은 보드에 따라 256비트, 384비트 또는 640비트 등 플랫폼의 RAM data width를 초과하지 않고 일치할 때 달성됩니다. 곱을 최대 RAM 데이터 너비에 맞추면 DRAM의 전체 쓰기 및 읽기 대역폭이 사용되며, 값이 너무 낮으면 DRAM 액세스가 병목 현상이 될 수 있습니다. 8비트 × Parallelism 4로 구성된 디자인은 256비트 인터페이스 중 32비트만 사용하므로 대역폭 여유 공간이 낭비됩니다.
-
여러 DRAM 오퍼레이터가 대역폭을 공유합니다. 공유 메모리 플랫폼에서 하나의 오퍼레이터가 사용할 수 있는 대역폭은 해당 인터페이스의 1 / (RAM 오퍼레이터 수)에 비례하여 조정됩니다. 세부 사항은 Device Resources 및 어플리케이션 노트: Shared Memory(Related Topics 참조)에 문서화된 바와 같이 플랫폼에 따라 다릅니다.
-
imaFlex 2 Dual 100과 같이 플랫폼이 둘 이상의 물리적 인터페이스를 제공하는 경우 독립적인 RAM 뱅크 간에 오퍼레이터의 균형을 맞추십시오. 대역폭은 동일한 물리적 뱅크에 있는 오퍼레이터 간에만 공유됩니다.
디자인 가이드라인
RAM 사용량을 미리 계획하십시오. DRAM 오퍼레이터가 추가될 때마다 동일한 물리적 Memory 인터페이스에서 다른 오퍼레이터들이 사용할 수 있는 대역폭이 줄어듭니다. 다른 DRAM 버퍼를 추가하기 전에 결합된 읽기/쓰기 트래픽을 계산하고 플랫폼에서 사용할 수 있는 공유 대역폭과 비교하십시오(Device Resources 참조). 선호하는 대상: ImageFifo (FPGA 메모리) 불필요하게 DRAM 대역폭을 낭비하지 않도록 소규모 디커플링 작업에 사용합니다.
Recognizing Memory-Related Errors#
VisualApplets은 모든 런타임 시나리오에 대해 디자인에 적절한 유형과 크기의 메모리가 충분한지 항상 검증할 수는 없습니다. 사용자는 이미지 크기, 속도 및 동기화 요구 사항에 맞는 오퍼레이터와 버퍼 크기를 선택해야 합니다.
버퍼가 하드웨어에 비해 너무 작더라도 시뮬레이션은 성공적으로 실행될 수 있습니다. 오류는 시뮬레이션에서는 문제가 없어 보였더라도 SDK에서 이미지가 출력되지 않는 등 프레임 그래버에서만 나타나는 경우가 많습니다.
일반적인 원인은 다음과 같습니다. SYNC 교착 상태 및 불충분하거나 잘못된 메모리.
이러한 문제를 방지하려면 다음 사항을 확인하십시오.
- 버퍼 및 DMA 경로를 배선한 후 Design Rules Check Level 1 and Level 2를 실행합니다.
- 하드웨어에서 다음 사항을 모니터링하십시오.
FillLevel(및Overflow(사용 가능한 경우) 예를 들어 microDisplay X에서 확인할 수 있습니다. 100% Fill이 지속되면 보통 데드락이나 대역폭 병목 현상이 발생했음을 나타냅니다. - 여러 DRAM 오퍼레이터가 있는 경우 Design → Device Resources를 열고 RAM 할당 및 예상 대역폭 점유율을 확인합니다.
- 무한 소스의 경우 다음을 확인하십시오.
InfiniteSource인 경우ENABLED중단할 수 없는 스트림을 수신하는 모든 버퍼에서 수행합니다.
일반적인 파이프라인 예시#
Camera to DMA Through a DRAM Line Buffer#
가장 작은 디자인에는 카메라 오퍼레이터 1개, 그리고 다음 항목이 포함된 DRAM 버퍼 1개가 있습니다. InfiniteSource 로 설정된 ENABLED, 그리고 하나 DmaToPC operator:
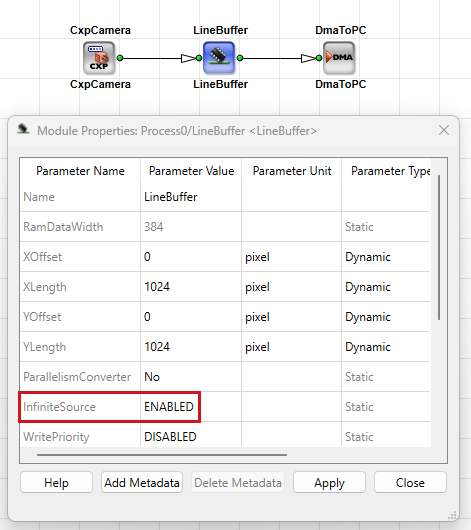
이 버퍼를 사용하여 피크를 흡수하고 라인 기반 처리에 데이터를 공급하십시오. 주의할 점: FillLevel 하드웨어에서 100%에 가까운 값은 병목 현상이나 데드락을 나타내는 경우가 많습니다. 참조: Recognizing Memory-Related Errors.
Camera Through LineBuffer into a 3×3 Kernel#
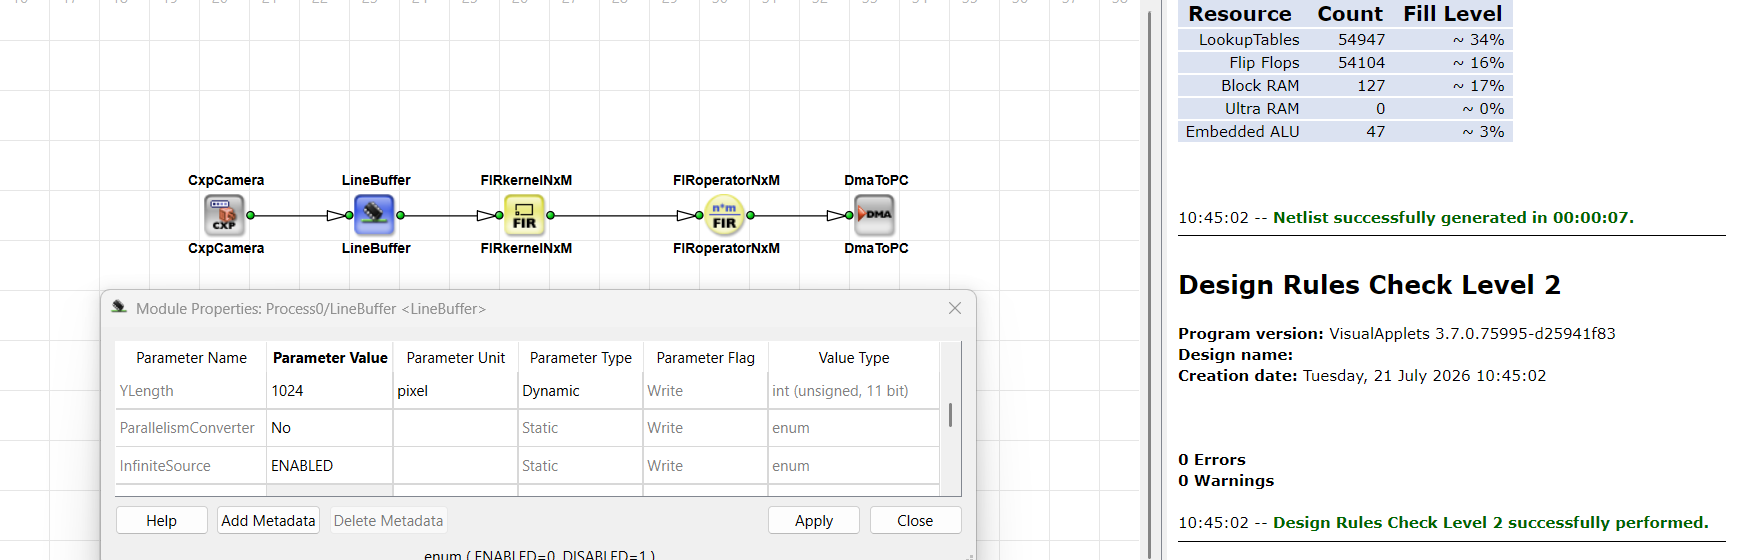
다음 디자인에서 DRAM 버퍼는 커널(예: 3×3)을 생성하는 인접 오퍼레이터에 라인을 공급합니다. 버퍼는 최소 1라인의 지연 시간을 추가하며, 필터 경로가 차단되어 버퍼가 채워질 경우 지연 시간이 더 늘어납니다. 다음 항목의 공유 DRAM 대역폭을 고려하십시오. LineBuffer 오퍼레이터에도 적용됩니다. 스크린샷의 Design Rules Check는 빌드하기 전에 링크 형식과 버퍼 설정이 일치하는지 확인해 줍니다.
관련 항목#
- 중지 가능 및 중지 불가능 데이터 스트림 튜토리얼 주제 —
InfiniteSource, 오버플로, 카메라 디커플링 - Parallelism 튜토리얼 주제 — 대역폭, RAM 데이터 폭,
LineBufferParallelism 변환 - Latency 튜토리얼 주제 — 버퍼 오퍼레이터의 라인 레이턴시
- Operator 유형 및 동기화 튜토리얼 주제 — 이전 버퍼
SYNC - Device Resources — 플랫폼 RAM 및 Shared Memory 개념
- Shared Memory 애플리케이션 노트 — 효율적인 DRAM 사용 및 대역폭 예제
- 오퍼레이터 레퍼런스의 Memory Library — 메모리 유형별 오퍼레이터 개요