
목차
다음 목록은 이 VisualApplets 버전에서 지원되는 모든 하드웨어 플랫폼의 주요 하드웨어 세부 정보를 보여줍니다. 자세한 목록은 개별 제품의 데이터 시트를 참조하십시오.
| Resource | imaFlex CXP-12 Quad | imaFlex CXP-12 Penta | imaFlex 2 Dual 100 | ||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Vision Processor | Xilinx UltraScale+ XCKU3P-FFVD900-1-E | Xilinx UltraScale+ XCKU3P-FFVB676-1-E | Xilinx UltraScale+ XCKU15P-FFVE1517-1-E | ||||||||||
| LUT | 160679 | 161049 | 447992 | ||||||||||
| Flip-Flop | 323224 | 323216 | 895984 | ||||||||||
| Block RAM (18k) | 720 | 720 | 1776 | ||||||||||
| URAM Blocks (288k) | 48 | 48 | 128 | ||||||||||
| Embedded Arithmetic Logic Unit (DSP48) | 1368 | 1368 | 1800 | ||||||||||
| RAM size | 3 x 512 MiB DDR4 | 5 x 512 MiB DDR4 | 2 @ 5 x 1024 MiB DDR4 | ||||||||||
| RAM Data Width | 384 Bit | 640 Bit | 640 Bit | ||||||||||
| RAM Bandwidth total (shared) | 14.4 GB/ |
24.0 GB/s |
2 @ 24.0 GB/s |
||||||||||
| Base Design Clock (default) | 312.5 MHz |
312.5 MHz |
391.5 MHz |
||||||||||
| Base Design Clock (최대) | 400.0 MHz | 400.0 MHz | 420.0 MHz | ||||||||||
| 호스트 인터페이스 | PCIe x 8 Gen 3 (직접 메모리 액세스) | PCIe x 8 Gen 3 (직접 메모리 액세스) | PCIe x 16 Gen 3 (직접 메모리 액세스) | ||||||||||
| 호스트 인터페이스(PCIe x 8 Gen 3) 대역폭(이론값) | 8000 MB/s | 8000 MB/s | 16000 MB/s | ||||||||||
| 호스트 인터페이스(PCIe x 8 Gen 3) 대역폭(일반/최대) | 7200 MB/s 지속 데이터 대역폭 | 7200 MB/s 지속 데이터 대역폭 | 13000 MB/s 지속 데이터 대역폭 |
||||||||||
|
|||||||||||||
표 68. imaFlex 플랫폼 하드웨어 구성
| Resource | mE5 marathon VCX-QP | mE5 marathon VCL | mE5 marathon VCLx | ||||
|---|---|---|---|---|---|---|---|
| Vision Processor | Xilinx Kintex7 XC7K160T - 2FFG676C FPGA | Xilinx Kintex7 XC7K160T - 1FBG676C FPGA | Xilinx Kintex7 XC7K410T - 1FBG676C FPGA | ||||
| LUT | 101400 | 101400 | 254200 | ||||
| Flip-Flop | 202800 | 202800 | 508400 | ||||
| Block RAM (18k) | 650 | 650 | 1590 | ||||
| Embedded Arithmetic Logic Unit (DSP48) | 600 | 600 | 1540 | ||||
| RAM size | 4 x 512MiB DDR3 | 4 x 512MiB DDR3 | 4 x 512MiB DDR3 | ||||
| RAM Data Width | 512 Bit | 256 Bit | 256 Bit | ||||
| RAM Bandwidth total (shared) | 12.8 GB/s |
6.4 GB/s |
6.4 GB/s |
||||
| Base Design Clock (default) | 125MHz | 125MHz | 125MHz | ||||
| Base Design Clock (최대) | 312.5 MHz |
312.5 MHz |
312.5 MHz |
||||
| 호스트 인터페이스 | PCIe x 4 Gen 2 (Direct Memory Access) | PCIe x 4 Gen 2 (Direct Memory Access) | PCIe x 4 Gen 2 (Direct Memory Access) | ||||
| Host Interface (PCIe x 4 Gen 2) Bandwidth (theor.) | 1x2000 MB/s | 1x2000 MB/s | 1x2000 MB/s | ||||
| Host Interface (PCIe x 4 Gen 2) Bandwidth (typ./max.) | Up 1800 MB/s sustainable data bandwidth | Up to 1800 MB/s sustainable data bandwidth | Up to 1800 MB/s sustainable data bandwidth | ||||
|
|
|||||||
Table 69. Hardware Configuration microEnable 5 marathon
각 하드웨어 플랫폼에서 디바이스 리소스는 제한되어 있습니다. 아래 목록은 지원되는 모든 플랫폼에서 사용 가능한 리소스를 보여줍니다. 오퍼레이터는 디바이스 리소스를 소비하며, 대부분의 리소스 인스턴스는 한 번만 사용할 수 있습니다. GPI 오퍼레이터와 같이 이 규칙에 예외가되는 경우도 있습니다. 이러한 경우 리소스 소비량은 오퍼레이터 참조 문서에 설명되어 있습니다.
디바이스 리소스 할당 방식:
-
자동
-
오퍼레이터 파라미터 사용, 또는
-
Resources 대화상자.
자세한 내용은 'Allocation of Device Resources'를 참조하십시오.
| Resource | imaFlex 2 Dual 100 | ||||||||
|---|---|---|---|---|---|---|---|---|---|
| Port[0] CoF Lane |
4 | ||||||||
| Port[1] CoF Lane |
4 | ||||||||
| Port[0] CoF RX Trigger Lane |
4 | ||||||||
| Port[1] CoF RX Trigger Lane |
4 | ||||||||
| Port[0] CoF TX Trigger Lane |
4 | ||||||||
| Port[1] CoF TX Trigger Lane |
4 | ||||||||
| Port[0] CoF Status Lane |
4 | ||||||||
| Port[1] CoF Status Lane |
4 | ||||||||
| Port[0] DF RX Data Lane |
4 | ||||||||
| Port[1] DF RX Data Lane |
4 | ||||||||
| Port[0] DF RX Meta Lane |
4 | ||||||||
| Port[1] DF RX Meta Lane |
4 | ||||||||
| Port[0] DF TX Data Lane |
4 | ||||||||
| Port[1] DF TX Data Lane |
4 | ||||||||
| Port[0] DF TX Meta Lane |
4 | ||||||||
| Port[1] DF TX Meta Lane |
4 | ||||||||
| Port[0] DF Green LED Lane |
4 | ||||||||
| Port[0] DF Red LED Lane |
4 | ||||||||
| Port[1] DF Green LED |
1 | ||||||||
| Port[1] DF Red LED |
1 | ||||||||
| DmaToHostPort |
5 | ||||||||
| DmaFromHostPort |
1 | ||||||||
| GPI |
16 | ||||||||
| GPO |
16 | ||||||||
| EventPort |
31 | ||||||||
| EventID |
64 | ||||||||
| User LED |
6 | ||||||||
| ImageChannel |
1024 | ||||||||
| RAM |
2 @ from 1 x 5 GiB to 8 x 625 MiB | ||||||||
|
|||||||||
Table 70. List of Device Resources imaFlex 2 Dual 100
| Resource | imaFlex CXP-12 Quad | imaFlex CXP-12 Penta | ||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Camera Port | 4 | 5 | ||||||||||||
| CxpStatusPort | 4 | 5 | ||||||||||||
| CxpRxTriggerPort | 4 | 5 | ||||||||||||
| CxpTxTriggerPort | 4 | 5 | ||||||||||||
| DMA | 4 | 5 | ||||||||||||
| DmaFromHostPort | 1 | 1 | ||||||||||||
| GPO |
10 OUT | 12 OUT | ||||||||||||
| GPI |
12 IN | 12 IN | ||||||||||||
| LED Ports |
6 | 6 | ||||||||||||
| SignalChannel |
4000 | 4000 | ||||||||||||
| EventPort |
32 | 32 | ||||||||||||
| EventID |
64 | 64 | ||||||||||||
| ImageChannel |
1024 | 1024 | ||||||||||||
RAM |
1 x 1.5 GiB ~ 8 x 192 MiB | 1 x 2.5 GiB ~ 8 x 320 MiB | ||||||||||||
|
||||||||||||||
Table 71. List of Device Resources imaFlex CXP-12 Quad and imaFlex CXP-12 Penta
Table 72. List of Device Resources microEnable 5 marathon
imaFlex 2 Dual 100 플랫폼에는 각각 5 GiB 용량을 가진 두 개의 개별 물리적 RAM 뱅크가 포함되어 있습니다. 이 물리적 뱅크는 애플릿에 사용되는 RAM 기반 VisualApplets 오퍼레이터의 수에 따라 필요에 따라 겹치지 않는 메모리 영역으로 나뉩니다. VisualApplets 내에서 이러한 영역은 가상 RAM 뱅크로 표시됩니다. 오퍼레이터에 RAM이 필요하면 물리적 RAM 내의 전용의 겹치지 않는 영역에 해당하는 가상 RAM 뱅크를 예약합니다.
VisualApplets 메모리 오퍼레이터에 대한 실용적인 지침은 Memory Elements 튜토리얼 항목을 참조하세요.
imaFlex 2 Dual 100 플랫폼에서는 물리적 RAM 뱅크당 최대 8개의 겹치지 않는 메모리 영역을 정의할 수 있으며, 이는 두 RAM 인터페이스에 걸쳐 총 16개의 영역을 의미합니다. 물리적 인터페이스에 하나의 RAM 오퍼레이터만 할당된 경우, 해당 인터페이스의 전체 5 GiB 용량에 액세스할 수 있습니다. 여러 오퍼레이터가 동일한 물리적 인터페이스를 공유하는 경우, 사용 가능한 메모리는 이들 간에 비례하여 나뉩니다. 예를 들어 8개의 오퍼레이터가 동일한 인터페이스에 할당된 경우 각 오퍼레이터는 5 GiB 메모리의 1/8을 받게 되며, 이는 오퍼레이터당 약 0.625 GiB가 됩니다.
imaFlex 2 Dual 100의 RAM 대역폭은 동일한 물리적 인터페이스에 연결된 모든 오퍼레이터 간에 균등하게 공유되며, 단일 오퍼레이터 전용이 아닙니다.
-
한 인터페이스에서 디자인이 8개의 RAM 리소스를 모두 사용하는 경우, 각 RAM 기반 오퍼레이터는 오퍼레이터의 효율성 계수에 따라 조정되어 총 인터페이스 대역폭의 약 1/8을 받게 됩니다.
-
RAM 기반 오퍼레이터를 하나만 사용하는 경우, 해당 인터페이스의 최대 대역폭을 온전히 활용할 수 있습니다.
-
두 오퍼레이터가 동일한 인터페이스를 공유하는 경우 각각 전체 대역폭의 절반을 받게 되며, 이런 식으로 배분됩니다.
플랫폼의 물리적 RAM 인터페이스 2개는 VisualApplets에서 16개의 가상 RAM 포트에 매핑됩니다. 첫 번째 RAM 인터페이스는 RAM 리소스 인덱스 0~7에 매핑되고, 두 번째는 RAM 리소스 인덱스 8~15에 매핑됩니다.
할당되지 않은(따라서 사용되지 않는) RAM 포트는 항상 0%의 Memory 용량을 받습니다. 즉, 사용 가능한 전체 Memory는 RAM 포트를 적극적으로 사용하는 오퍼레이터 간에만 나뉘어 배분됩니다.
-
포트 1개를 사용하는 경우: 해당 포트가 사용 가능한 Memory의 100%를 받습니다.
-
포트 2개를 사용하는 경우: 각 포트가 사용 가능한 Memory의 50%를 받습니다.
-
포트 3개를 사용하는 경우: 리소스 ID가 가장 낮은 포트가 50%를 받고, 나머지 포트 2개는 각각 25%씩 받습니다.
-
포트 4개를 사용하는 경우: 4개 포트 모두 각각 25%씩 받습니다.
-
포트 5개를 사용하는 경우: 처음 3개 포트(리소스 ID가 가장 낮은 포트)가 각각 25%씩 받고, 나머지 2개 포트는 각각 12.5%씩 받습니다.
-
포트 6개를 사용하는 경우: 리소스 ID가 가장 낮은 포트 2개가 각각 25%씩 받고, 나머지 4개 포트는 각각 12.5%씩 받습니다.
-
포트 7개를 사용하는 경우: 리소스 ID가 가장 낮은 포트가 25%를 받고, 나머지 6개 포트는 각각 12.5%씩 받습니다.
-
포트 8개를 사용하는 경우: 모든 포트가 각각 12.5%씩 받습니다.
 |
비대칭 Memory 할당 |
|---|---|
|
동일한 물리적 뱅크 내에서 RAM 인덱스가 가장 낮은 포트는 비대칭 크기 분할 시 더 큰 할당량을 받습니다. 예를 들어, 3개의 RAM 포트(0, 1, 2)를 사용하는 경우 포트 0은 RAM 크기의 50%를 받고, 포트 1과 2는 각각 25%를 받습니다. 포트가 8, 9, 10인 경우에도 마찬가지입니다. 두 번째 RAM 인터페이스에 매핑되지만 여전히 동일한 물리적 RAM 뱅크에 속하기 때문입니다. |
RAM 인덱스가 연속될 필요는 없으며, 절대적인 순서에 따라 할당이 결정됩니다. RAM 인덱스는 가상 식별자이며 시퀀스에 간격이 있더라도 FPGA 리소스 사용량에는 영향을 미치지 않습니다. 예를 들어 3개의 RAM 포트(1, 5, 7)를 사용하는 경우 포트 1은 RAM 크기의 50%를 받고, 포트 5와 7은 각각 25%를 받습니다.
모든 리소스가 동일한 물리적 뱅크에 매핑되는 경우 RAM 인덱스 할당 방식에 따른 유리함이나 불리함은 없습니다. VisualApplets에서 제공하는 자동 할당을 사용하거나 특정 디자인 오퍼레이터가 다른 오퍼레이터보다 더 많은 RAM을 필요로 하는 경우 수동으로 조정할 수 있습니다.
|
독립적인 RAM 인터페이스 |
|---|---|
|
두 물리적 RAM 인터페이스는 완전히 독립적입니다. 예를 들어 두 개의 오퍼레이터를 사용하는 상태에서 하나는 첫 번째 RAM 인터페이스에 할당하고 다른 하나는 두 번째에 할당하는 경우, 각 오퍼레이터는 각 인터페이스의 최대 RAM 크기를 온전히 활용할 수 있습니다. |
공유 Memory 컨트롤러는 라운드 로빈(Round-robin) 알고리즘을 사용하여 물리적 RAM 인터페이스 내의 모든 할당된 포트에 대역폭을 고르게 분산시킵니다. 이 알고리즘은 크레디트 기반 중재 체계를 기반으로 합니다. 포트가 활성화되면 새로운 RAM 작업을 계속 제공하는 한 설정된 크레디트 클록 사이클 동안 활성 상태를 유지합니다. 활성 포트에 더 이상 작업이 없으면 비활성화되며, 활성화 토큰은 대기 중인 요청이 있는 다음 포트로 이동합니다. 이를 통해 유휴 포트에 대역폭이 낭비되는 것을 방지합니다.
크레디트 값은 사용된 RAM 오퍼레이터 수를 기반으로 앱릿 합성 중에 펌웨어에 의해 프로그래밍됩니다. 런타임이나 Framegrabber SDK를 통해 변경할 수 없습니다. 사용자는 크레디트 구성에 접근할 수 없습니다.
포트가 활성화되어 있는 동안에는 Memory 컨트롤러 대역폭의 100%를 가집니다. 물리적 뱅크의 8개 포트가 모두 고르게 활성화된 경우 각 포트는 시간에 따라 전체 대역폭의 약 1/8을 받습니다. 그 외의 경우 실제 평균 대역폭은 각 포트의 부하에 따라 달라집니다.
물리적 RAM 인터페이스는 완전히 독립적입니다. RAM 기반 오퍼레이터를 서로 다른 인터페이스에 할당하면 대역폭 효율성을 극대화할 수 있습니다. 대역폭은 동일한 물리적 RAM 인터페이스에 연결된 오퍼레이터 간에만 공유됩니다.
imaFlex CXP-12 Quad 및 imaFlex CXP-12 Penta 플랫폼에는 단 하나의 물리적 RAM 뱅크만 장착되어 있습니다(크기는 플랫폼별로 다름). 이 단일 물리적 뱅크는 앱릿 내부에서 사용되는 RAM 기반 VisualApplets 오퍼레이터의 양에 따라 겹치지 않는 영역으로 동적으로 포맷됩니다. 이 영역은 VisualApplets 내에서 가상 RAM 뱅크로 표시됩니다. 오퍼레이터가 RAM 리소스를 예약하면, 이는 물리적 RAM 내부의 배타적이고 겹치지 않는 Memory 영역에 매핑되는 가상 RAM 뱅크를 사용하는 것입니다. imaFlex 플랫폼에서는 겹치지 않는 영역을 최대 8개까지 정의할 수 있습니다. RAM 오퍼레이터를 1개만 사용하는 경우, 해당 오퍼레이터는 플랫폼의 전체 RAM 크기를 갖게 됩니다. 추가 오퍼레이터마다 할당된 크기는 동일한 물리적 인터페이스에 도킹되는 오퍼레이터의 양에 비례하여 오퍼레이터가 소유한 크기를 줄입니다. 8개의 오퍼레이터를 사용하는 경우 각 오퍼레이터는 플랫폼 Memory 크기의 1/8을 할당받습니다.
그러나 RAM 대역폭은 디자인 내의 모든 RAM 기반 오퍼레이터 간에 공유됩니다. 디자인이 8개의 RAM 리소스를 모두 활용하는 경우, 8개의 RAM 기반 오퍼레이터 각각은 해당 특정 오퍼레이터의 효율성 계수를 뺀 최대 1/8 GB/s의 전용 대역폭을 가질 수 있습니다. 디자인에서 RAM 기반 오퍼레이터를 하나만 사용하는 경우 이 오퍼레이터는 플랫폼의 전체 대역폭을 얻습니다. 2개의 오퍼레이터를 사용하는 경우 두 오퍼레이터 각각이 전체 대역폭의 절반을 얻는 식입니다.
할당되지 않아 사용되지 않는 RAM 포트에는 항상 메모리 크기의 0%가 부여됩니다.
-
1개의 포트가 사용되는 경우: 사용되는 포트에 100%가 부여됩니다.
-
2개의 포트가 사용되는 경우: 사용되는 두 포트에 각각 50%가 부여됩니다.
-
3개의 포트가 사용되는 경우: 리소스 ID 번호가 가장 낮은 포트에 50%가 부여되고, 나머지 2개의 사용되는 포트에는 각각 25%가 부여됩니다.
-
4개의 포트가 사용되는 경우: 4개 포트 모두에 25%가 부여됩니다.
-
5개의 포트가 사용되는 경우: 리소스 ID 번호가 가장 낮은 3개의 포트에 각각 25%가 부여됩니다. 나머지 2개 포트에는 각각 12.5%가 부여됩니다.
-
6개의 포트가 사용되는 경우: 리소스 ID 번호가 가장 낮은 2개의 포트에 각각 25%가 부여됩니다. 나머지 4개 포트에는 각각 12.5%가 부여됩니다.
-
7개의 포트가 사용되는 경우: 리소스 ID 번호가 가장 낮은 포트에 25%가 부여됩니다. 나머지 6개 포트에는 각각 12.5%가 부여됩니다.
-
8개의 포트가 사용되는 경우: 모든 포트에 12.5%가 부여됩니다.
|
|
|
비대칭 크기 분할의 경우 RAM 인덱스가 낮은 포트에 더 큰 할당이 부여됩니다. 예를 들어 3개의 RAM 포트(0, 1, 2)가 사용되는 경우 포트 0에는 RAM 크기 할당의 50%가 부여됩니다. 포트 1과 2에는 각각 25%가 부여됩니다. RAM 인덱스는 연속될 필요가 없으며, 절대적인 순서에 따라 할당이 결정됩니다. RAM 인덱스는 가상 번호이며 순서에 간격이 있더라도 FPGA 리소스 사용량에 영향을 미치지 않습니다. 예를 들어 3개의 RAM 포트(1, 5, 7)가 사용되는 경우 포트 1에는 RAM 크기 할당의 50%가 부여됩니다. 포트 5와 7에는 각각 25%가 부여됩니다. operators의 RAM 인덱스를 할당할 때 특별한 장점이나 단점은 없습니다. 특정 디자인 operator가 다른 operator보다 더 큰 RAM 크기를 필요로 하는 경우, VisualApplets의 자동 할당을 사용하거나 수동으로 조정하십시오. |
공유 메모리 컨트롤러는 라운드 로빈(Round-robin) 알고리즘을 적용하여 모든 할당된 포트에 대역폭을 균등하게 분배합니다. 이 알고리즘은 크레딧(credit) 중재 체계를 사용합니다. 포트가 활성화되면 포트가 새로운 RAM 작업을 제공하는 한 크레딧의 클럭 주기 동안 활성 상태를 유지할 수 있습니다. 포트가 활성화되었지만 더 이상 작업이 없는 경우 해당 포트는 비활성화되고 활성화 토큰은 대기 중인 요청 작업이 있는 라인의 다음 포트로 이동합니다. 이렇게 하면 유휴 상태로 인해 대역폭이 낭비되는 일이 발생하지 않습니다. 크레딧은 사용된 RAM operators의 양에 따라 앱릿 합성 중에만 펌웨어에 의해 독점적으로 프로그래밍되며 Framegrabber SDK에서/런타임 중에 변경할 수 없습니다. 사용자는 크레딧 프로그래밍에 접근할 수 없습니다. 활성 포트가 RAM 인터페이스를 소유하고 있는 동안 메모리 컨트롤러의 100% 대역폭에 접근할 수 있습니다. 8개의 포트 모두가 사용되고 균등하게 활성화된 경우 시간에 따른 결과 대역폭은 각 포트에 대해 1/8입니다. 그 밖의 모든 경우에는 포트의 부하에 따라 각 포트의 실제 평균 대역폭이 결정됩니다.
microEnable 5 marathon 플랫폼은 하나의 물리적 RAM 뱅크(크기는 플랫폼별로 다름)로만 조립됩니다. 이 단일 물리적 뱅크는 겹치지 않는 4개의 메모리 영역으로 포맷됩니다. 이 4개의 영역은 VisualApplets 내에서 4개의 가상 RAM 뱅크로 표현됩니다. operator가 RAM 리소스를 예약하면 물리적 RAM 내의 독점적인 비중첩 메모리 영역에 매핑되는 가상 RAM 뱅크를 사용합니다.
그러나 RAM 대역폭은 디자인 내의 모든 RAM 기반 operators 간에 공유됩니다. 디자인이 4개의 RAM 리소스를 모두 활용하는 경우, 4개의 RAM 기반 operators 각각은 해당 operator의 효율성 요소를 뺀 최대 1.6 GB/s의 배타적 대역폭을 가질 수 있습니다. 디자인에서 단 하나의 RAM 기반 operator만 사용되는 경우 이 operator는 총 대역폭인 6.4 GB/s를 갖습니다. 2개의 operator가 사용되는 경우 두 operator 각각에 총 대역폭의 절반이 부여되는 식입니다.
|
Operator별 대역폭 |
|---|---|
|
온보드 RAM은 총 6.4 GB/s의 대역폭을 제공합니다. 개별 RAM 기반 operator에 사용할 수 있는 대역폭은 총 대역폭을 디자인에 인스턴스화된 모든 RAM 기반 operators의 수로 나눈 값입니다. |
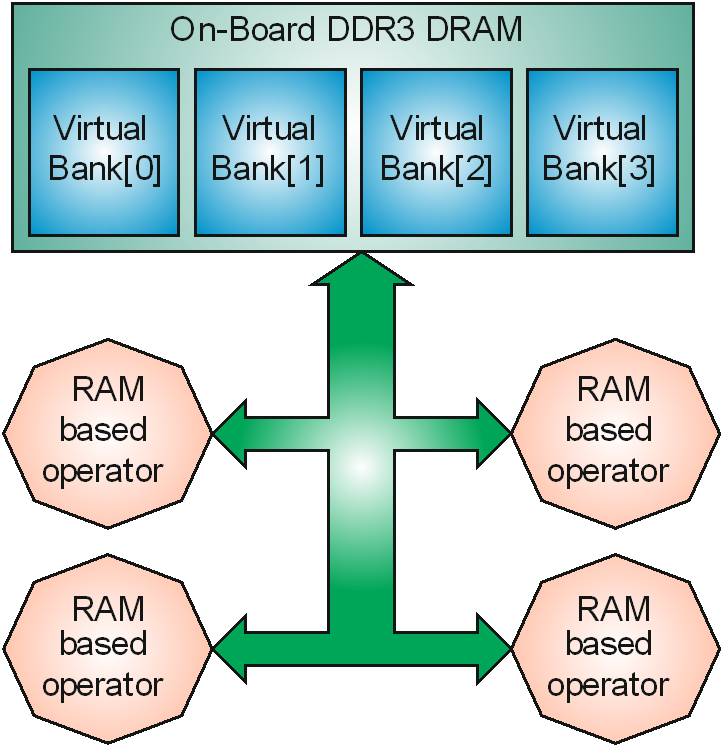
RAM 기반 operators를 사용하여 디자인할 때는 이 RAM 아키텍처를 고려해야 합니다.
공유 대역폭 아키텍처로 인해, 앱릿 개발자는 단일 RAM operator가 입력에서 더 적은 대역폭을 필요로 하더라도 여러 RAM 기반 operators를 사용할 때 메모리 인터페이스를 통한 최대 처리량을 달성하기 위해 operator의 메모리 인터페이스(RAM Data Width)의 256비트 전체를 활용해야 합니다.
imaFlex 2 Dual 100은 C0과 C1의 2가지 광섬유 QSFP28 커넥터를 제공합니다.
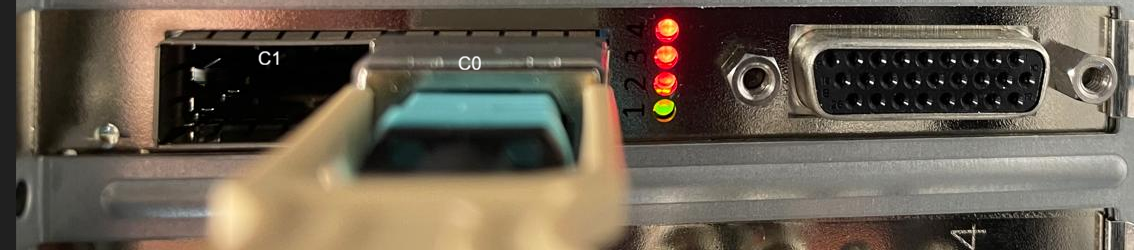
두 커넥터 모두 CoF (CXP over Fiber) 및 데이터 포워딩 프로토콜을 지원합니다. 각 광섬유 커넥터에는 자체 LED가 있습니다. 4개의 LED는 커넥터 C0에 할당되고 1개의 LED는 커넥터 C1에 할당됩니다.
각 커넥터는 QSFP28 광 모듈을 지원합니다. QSFP28 인터페이스는 양방향으로 4개의 광섬유 연결, 즉 4개의 RX 및 4개의 TX 연결을 제공합니다. 광섬유 연결은 연산자 문서에서 lane으로 지칭됩니다. 각 QSFP28 포트는 RX 및 TX 방향 모두에 0부터 3까지 레이블이 지정된 4개의 광섬유 lane을 가지고 있습니다. 각 lane은 25 Gbit/s로 작동합니다. 따라서 단일 QSFP28 커넥터는 TX 및 RX 방향으로 총 100 Gbit/s의 누적 대역폭을 전송할 수 있습니다.
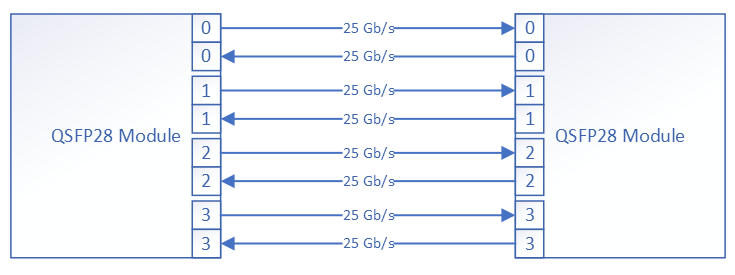
imaFlex 2 Dual 100은 여러 프레임 그래버 간에 데이터를 양방향으로 전송할 수 있는 데이터 포워딩 기능을 제공합니다. VisualApplets의 데이터 포워딩은 데이지 체인 및 보다 발전된 모델을 포함하여 데이터 및 메타데이터를 전송하기 위한 다양한 토폴로지를 지원합니다. 데이터 포워딩 동작은 VisualApplets 연산자를 통해 사용자가 완전히 제어합니다. 카메라 데이터, 앱릿 생성 데이터 및 메타데이터는 TX 및 RX 방향으로 각각 독립적으로 전송될 수 있습니다. 또한 VisualApplets는 lane을 멀티플렉싱하여 두 개의 분리된 가상 채널을 사용하여 단일 광섬유 lane을 통해 메타데이터와 일반 이미지 데이터를 동시에 보낼 수 있도록 합니다. 메타데이터는 적시 전달을 보장하기 위해 우선순위가 부여됩니다.
광섬유 기술은 양방향 통신을 지원하므로, 고급 마스터-슬레이브 애플리케이션을 통해 마스터가 슬레이브 장치가 수신하는 데이터를 제어하고 이들로부터 처리 결과를 수집할 수 있습니다. 슬레이브 GPU 또는 CPU에서 생성된 처리 결과는 DmaFromPC를 통해 다시 전송된 후 데이터 포워딩 데이터 연산자를 거쳐 마스터 프레임 그래버로 전달될 수 있습니다.
일반적인 데이터 포워딩 데이지 체인 구성에서는 선택된 카메라 데이터가 여러 프레임 그래버로 전달됩니다. 그런 다음 이 프레임 그래버들은 매우 낮은 지연 시간으로 PCIe를 통해 외부 GPU로 데이터를 전송합니다.
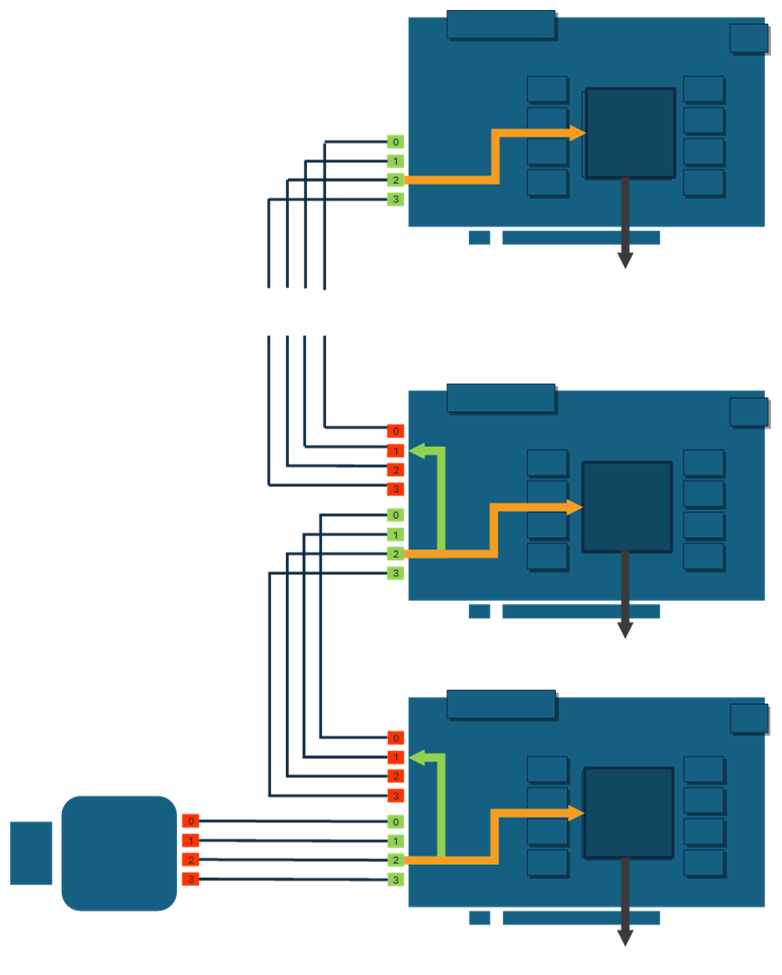
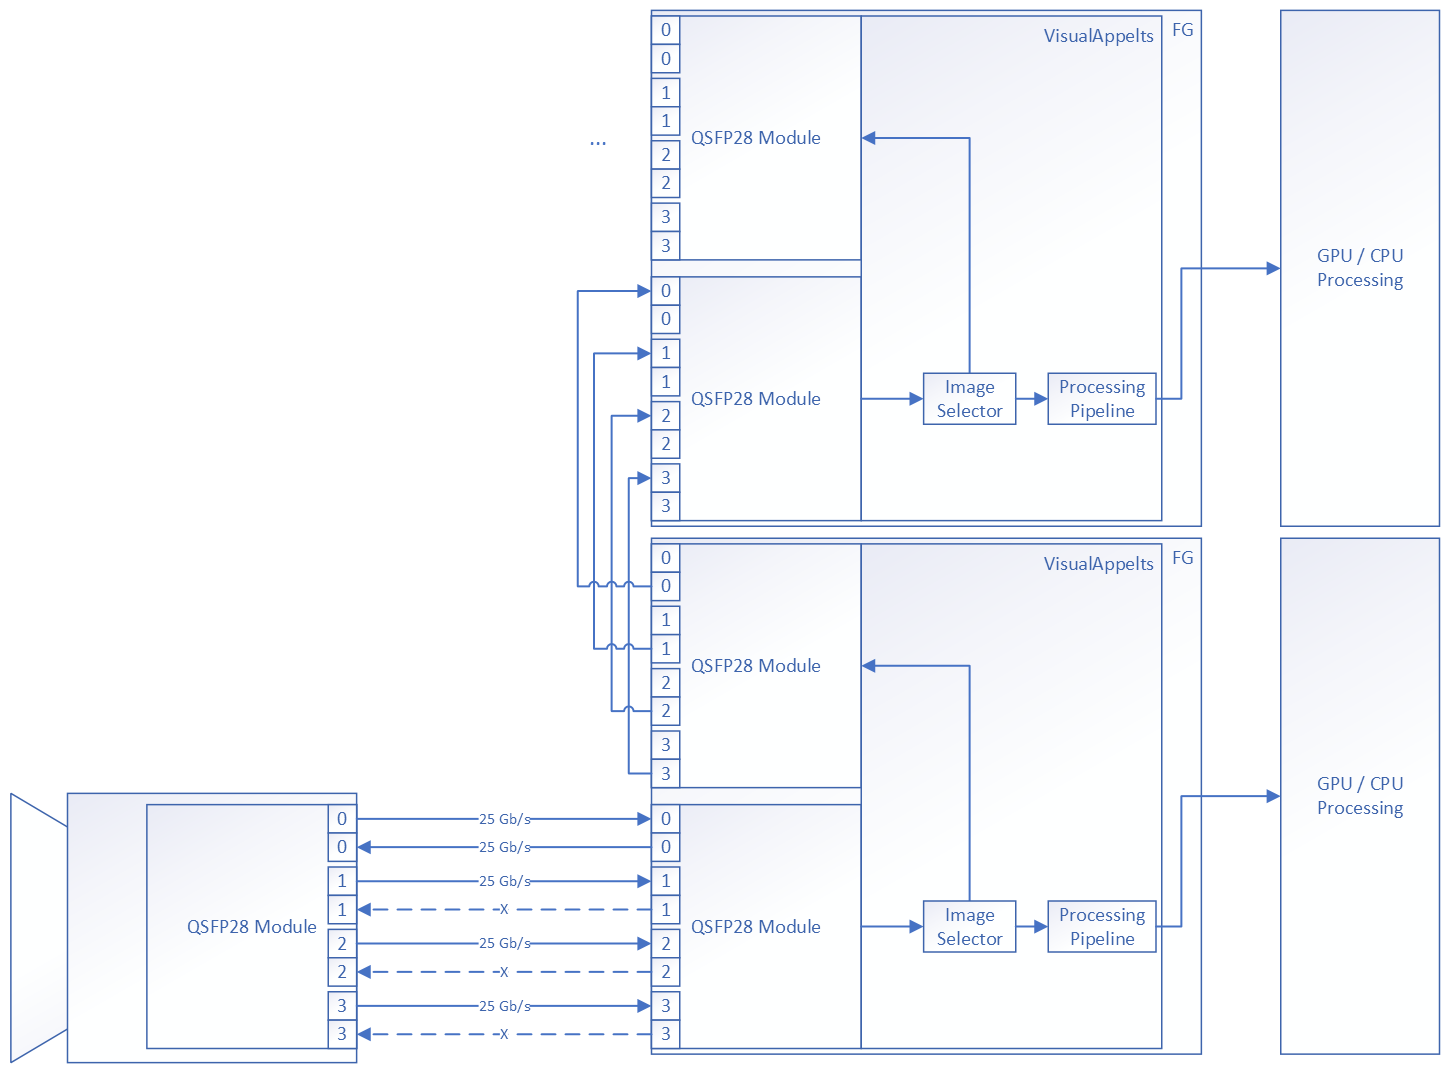
CoF (CXP over Fiber)는 4개의 다운스트림 연결과 1개의 업스트림 연결을 사용합니다. 두 프레임 그래버 간의 데이터 포워딩 링크는 필요한 페이로드 데이터만 전송하도록 구성되며, 기본 CoF 트래픽을 전송하는 대신 VisualApplets 데이터 및 메타데이터 스트림을 운반합니다. CoF와 데이터 포워딩 모두 전방 오류 정정(FEC)으로 보호됩니다.
마스터 프레임 그래버는 카메라에 연결되어 선택된 데이터 부분을 다음 슬레이브 프레임 그래버로 전달합니다. 각 슬레이브 프레임 그래버는 자체 처리에 필요한 데이터를 추출하고 이미지 스트림의 나머지 처리되지 않은 부분을 시퀀스의 다음 슬레이브로 전달합니다. 체인의 마지막 프레임 그래버는 엔드포인트 역할을 하며 데이터를 더 이상 전달하지 않습니다.
위의 예시는 데이지 체인 토폴로지를 단순화하여 표현한 것입니다. 보다 발전된 구성에서는 연결된 두 프레임 그래버가 데이터를 자유롭게 교환할 수 있으며, 상호 간에 1개, 2개, 3개 또는 4개 lane의 연결을 확장할 수 있습니다. RX 및 TX 방향은 서로 다른 수의 lane을 사용할 수 있습니다.
여러 개의 광섬유 lane을 결합하여 가상 채널을 형성함으로써 단일 QSFP28 커넥터를 통해 여러 데이터 채널을 전송할 수 있습니다. 이미지 데이터 전송 외에도 VisualApplets는 각 광섬유 lane에 대해 전용 메타 채널을 제공합니다. 이 메타 채널은 일반 이미지 데이터보다 우선순위가 높으며 매우 낮은 지터와 지연 시간으로 전송되므로 응용 프로그램에서 타임스탬핑과 보드 간 동기화를 구현할 수 있습니다. 또한 광섬유 연결 반대편에 있는 슬레이브 파트너를 구성하기 위한 용도 등으로 메타 채널을 통해 작은 사이드밴드 정보를 전송할 수 있습니다. 파트너는 자체 메타 채널을 통해 제어 및 상태 정보를 마스터에게 다시 보낼 수 있습니다. 각 프레임 그래버는 또한 최대 100 Gb/s의 집계 대역폭으로 처리된 이미지 데이터를 파트너에게 전송할 수 있습니다.
단일 QSFP28 인터페이스를 통해 TX 및 RX 방향으로 각각 독립적으로 두 프레임 그래버 간에 최대 4개의 메타 채널을 확장할 수 있습니다. 각 메타 채널은 25 Gb/s로 작동합니다. 이미지 데이터 채널은 1개, 2개, 3개 또는 4개의 광섬유 lane을 확장하여 가상 데이터 전송 채널을 형성할 수 있습니다.
QSFP28 데이터 포워딩 인터페이스는 다음과 같은 가상 데이터 채널 조합을 허용합니다.
-
1 x4 채널: 100 Gbit/s
-
75 Gbit/s로 실행되는 1 x3 채널 및 25 Gbit/s로 실행되는 1 x1 채널
-
각각 50 Gbit/s로 실행되는 2 x2 채널
-
50 Gbit/s로 실행되는 1 x2 채널 및 각각 25 Gbit/s로 실행되는 2 x1 채널
-
각각 25 Gbit/s로 실행되는 4 x1 채널
RX 및 TX 측은 완전히 독립적으로 작동합니다. 즉, 역방향(RX) 방향은 필요에 따라 구현하거나 생략할 수 있습니다. 구현되는 경우에도 전방(TX) 방향과 대칭일 필요는 없습니다.
메타 채널과 데이터 채널은 독립적으로 작동합니다. 각 메타 채널은 정확히 하나의 광섬유 lane을 사용하며 25 Gb/s로 실행됩니다. 메타 채널은 소량의 데이터를 전송하도록 설계되었습니다. 우선순위가 높기 때문에 메타 채널 전송은 동일한 광섬유 lane에서 일반 데이터 전송을 일시적으로 중단시킵니다.
데이터 포워딩 기능을 지원하기 위해 VisualApplets는 다음과 같은 연산자를 제공합니다.
Basler는 VisualApplets 디자인과 C++ SDK 제어 애플리케이션과 함께 데이터 포워딩 예제를 제공합니다. 이 예제에서 이러한 오퍼레이터를 데이터 포워딩에 사용하는 방법을 확인할 수 있습니다. 예제는 VisualApplets 예제로 다음에서 제공됩니다. Examples/Acquisition/DataForwarding이러한 데이터 포워딩 예제에 대한 문서는 다음에서 확인할 수 있습니다. 'Data Forwarding for CoaXPress over Fiber Frame Grabber' 토픽: 기본 사항 및 예제.
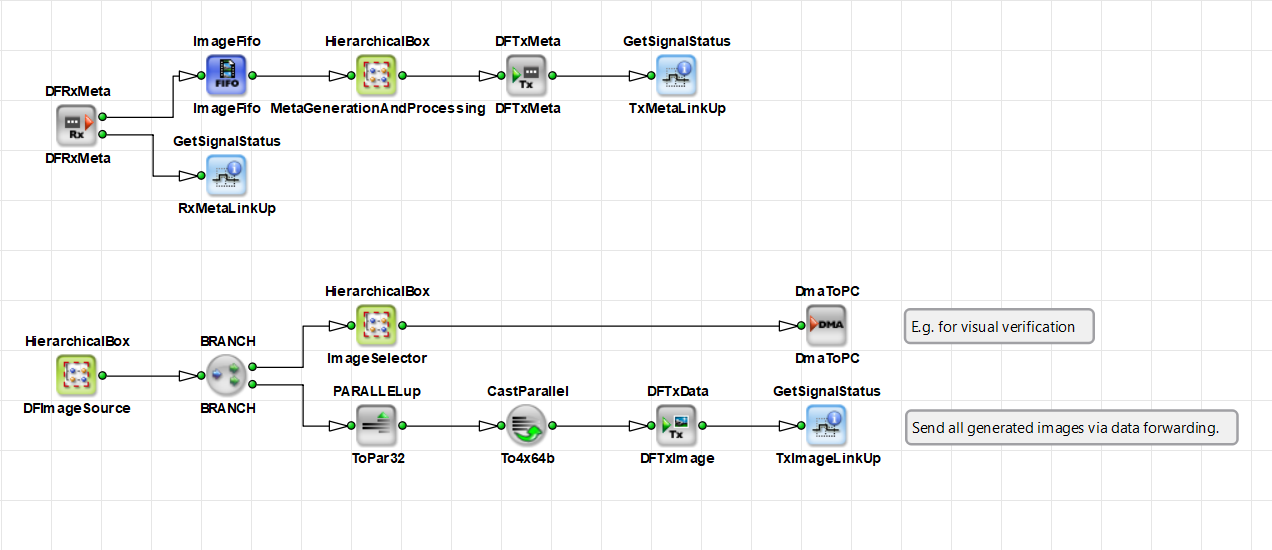
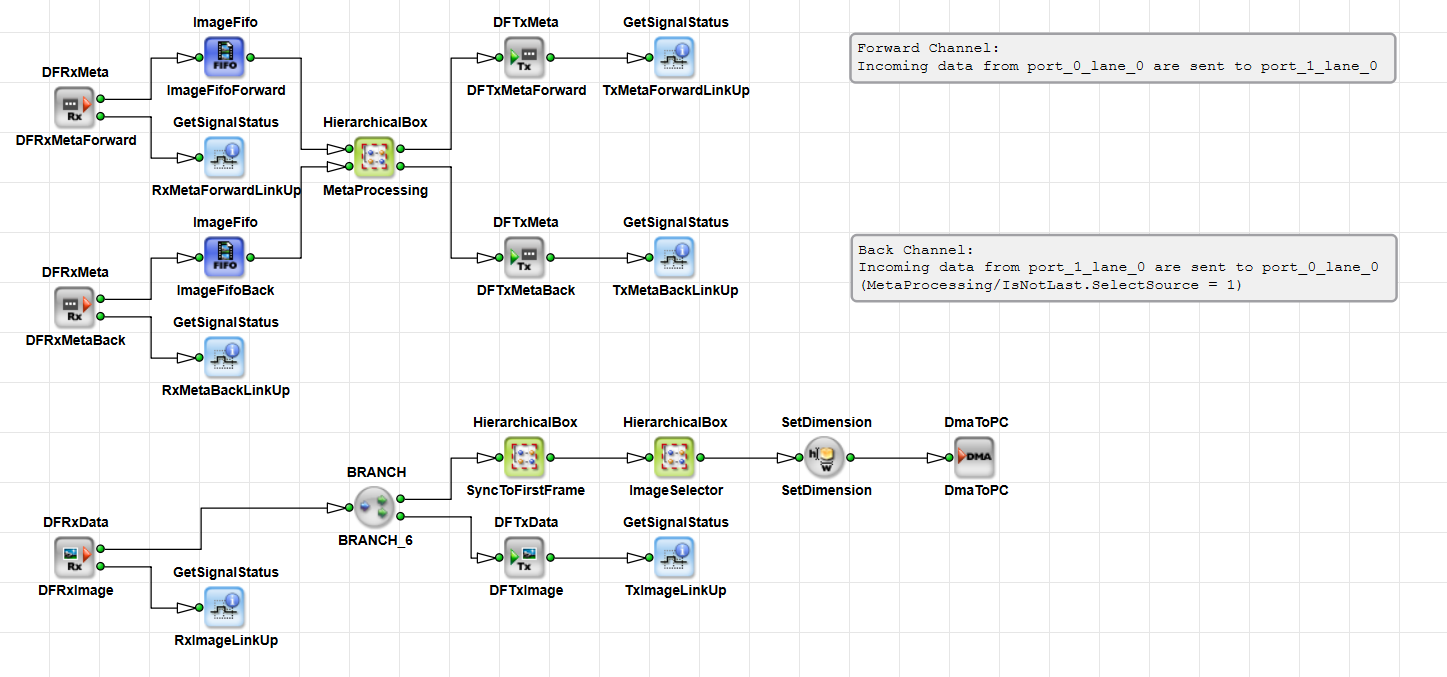
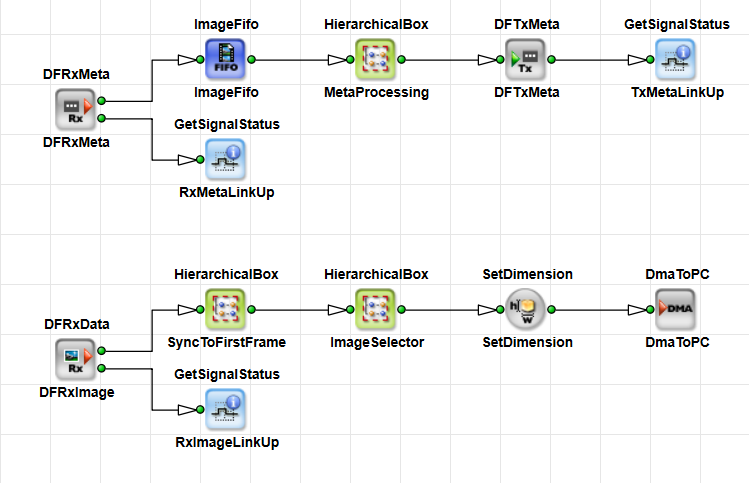
특정 제약 조건 하에서 더 복잡한 카메라-프레임 그래버 모델을 구성할 수 있습니다. 두 프레임 그래버 간의 광학 전송 지연 시간은 약 120 ns로 매우 짧으며, 데이터 워드가 한 프레임 그래버에서 다른 프레임 그래버로 이동하는 데 소요되는 시간입니다.
데이지 체인(daisy-chain) 토폴로지는 여러 CPU/GPU 클러스터에 걸쳐 처리 부하를 분산하는 가장 일반적인 방법입니다.
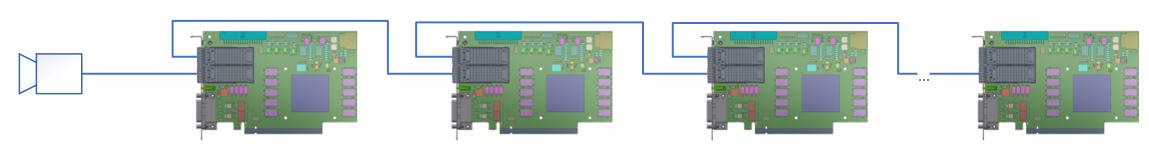
마스터 프레임 그래버는 카메라에 연결되고, 두 번째 QSFP28 포트는 다음 슬레이브에 연결됩니다. 각 슬레이브는 수신된 데이터의 일부를 처리하고 나머지 데이터는 다음 장치로 전달합니다. 체인의 마지막 프레임 그래버는 엔드포인트 역할을 합니다. 마지막 프레임 그래버를 제외한 모든 프레임 그래버는 두 개의 QSFP28 포트를 모두 사용합니다.
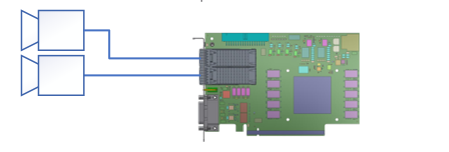
일부 애플리케이션에서는 두 개의 100 Gb/s 카메라를 단일 프레임 그래버에 연결할 수 있습니다. 이를 위해서는 카메라가 최대 대역폭으로 작동하지 않거나, 데이터를 RAM에 저장하기 전에 VisualApplets에서 전처리를 수행하여 대역폭을 약간 줄임으로써 두 카메라 스트림이 두 RAM 인터페이스에 모두 맞도록 해야 합니다. 이 구성에서 프레임 그래버는 VisualApplets에서 추가 처리를 수행하여 결과 데이터 속도를 줄임으로써 약 13 GB/s의 제한된 PCIe 처리량에 맞추어야 합니다.
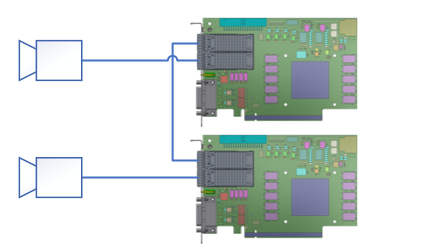
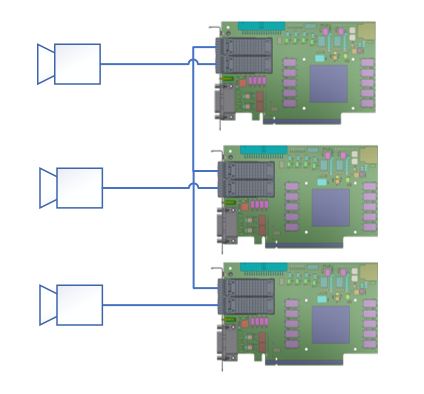
이 경우 각 프레임 그래버는 자체 카메라에 연결됩니다. 두 번째 QSFP28 포트는 프레임 그래버 간 통신에 사용되어, 복잡한 연산 작업 및 동기화를 위해 양방향으로 최대 100 Gbit/s의 데이터 교환을 지원합니다.
 이전

