
머신 비전에서 기본적인 요구 사항은 서로 다른 이미지에서 색상 요소를 분리하는 것입니다. 예를 들어 RGB를 각 요소로 분리하거나 HSL, XYZ 등을 분리하는 작업일 수 있습니다. 다음은 색상 분리의 몇 가지 예시입니다. 모든 예시는 입력으로 RGB 영역 스캔 카메라를 사용합니다. 물론 이 예시들은 라인 스캔 카메라에도 동일하게 적용할 수 있습니다. 또한, 이전 단계의 Bayer De-Mosaicing 또는 색 공간 변환이 수행될 가능성이 높으며 예시에 쉽게 추가할 수 있습니다.
이 예시들은 호스트 PC에서 후처리를 위해 색상 분리가 필요하다고 가정합니다. 따라서 색상별로 분리된 DMA 전송에 초점을 맞춥니다. FPGA에서 색상별로 분리된 데이터 처리가 필요한 경우, 이 예시들을 요구 사항에 맞춰 적용할 수 있습니다.
여러 예시가 제공됩니다. 모든 예시의 결과는 동일합니다. 그러나 구현 방식은 완전히 다르며 각각 장단점이 있습니다. 요구 사항에 가장 잘 맞는 예시를 선택해야 합니다. 다음 표에는 모든 예시와 일부 Property들이 나열되어 있습니다.
| 예제 이름 | 지연 시간 | DRAM | No. of Block RAM | DMA Output |
|---|---|---|---|---|
| Three DMAs | 추가 지연 없음 | 1 DRAM buffer | low | 3 DMA. 각 색상 요소마다 하나씩 할당됩니다. |
| Sequential with 3 buffers | 지연 시간이 이론적 최솟값으로 최소화됩니다. | 3 DRAM buffers | low | 1 DMA. 순차적인 색상 요소 출력. |
| Sequential with MultiROI Buffer | 1프레임 지연 시간 및 대역폭 제한. | 1 DRAM buffer | normal | 1 DMA. 순차적인 색상 요소 출력. |
| Sequential with pre-sorted MultiROI Buffer | 1프레임 지연 시간 | 1 DRAM buffer | high | 1 DMA. 순차적인 색상 요소 출력. |
| Sequential with advanced buffer usage | 1프레임 지연 시간 | 1 DRAM buffer | low | 1 DMA. 순차적인 색상 요소 출력. |
Table 20. 색상 분리 예시 개요
이전 표에 표시된 Property에 대한 전체 설명과 다양한 방법에 대한 상세한 설명은 다음 섹션에 설명되어 있습니다.
| 간략한 설명 | |
|---|---|
|
File: \examples\Processing\Color\ColorPlaneSeparation\ColorPlaneSeparation_Option1_ThreeDMA.va |
 |
|
Default Platform: mE5-MA-VCL |
|
|
간단한 설명 RGB color plane separation examples. The components are split into three DMA output channels. |
|
이 예시는 매우 간단합니다. 입력 RGB 이미지가 버퍼링된 후 색상 평면이 세 개의 출력 링크로 분할됩니다. 이 세 개의 링크는 세 개의 DmaToPC operator를 사용하여 PC로 전송됩니다. 이 솔루션의 장점은 지연 시간이 최소화된다는 것입니다. 이미지가 프레임 그래버에서 버퍼링되지 않습니다. 호스트 PC가 충분히 빠른 경우 ImageBuffer operator는 이미지를 단 한 라인만 지연시킵니다. 추가적인 지연이 발생하지 않습니다. 또 다른 장점은 하나의 DRAM operator만 필요하다는 것입니다.
이 구현 방식의 단점은 3개의 DMA 출력 연산자가 필요하다는 점입니다. 이러한 연산자는 프레임 그래버의 많은 FPGA 로직 리소스를 소비합니다. 이러한 최소화된 지연 시간이 필요하지 않은 경우, 다음 장에 소개된 솔루션 중 하나를 고려해야 합니다.
| 간략한 설명 | |
|---|---|
|
File: \examples\Processing\Color\ColorPlaneSeparation\ColorPlaneSeparation_Option2_ThreeBuffersOneDMA.va |
 |
|
Default Platform: mE5-MA-VCL |
|
|
간단한 설명 RGB 컬러 플레인 분리 예제. 컴포넌트가 분할되어 3개의 프레임 그래버 버퍼에 버퍼링됩니다. 그 후, 하나의 DMA 채널을 사용하여 컬러 플레인이 순차적으로 출력됩니다. |
|
RGB 컬러 플레인 분리를 위한 이 솔루션에서는 컬러 플레인이 DMA 채널을 통해 순차적인 순서로 출력됩니다. 이는 RGB 입력을 각 컴포넌트로 분할하고 3개의 ImageBuffer 모듈에 색상을 각각 버퍼링하여 수행됩니다. InsertImage 연산자를 사용하여 ImageBuffer에서 컬러 플레인을 차례대로 읽어옵니다.
이 예제에서는 데이터를 ImageBuffer에 쓰기 전에 Parallelism을 높이는 것이 중요합니다. 그렇지 않으면 InsertImage 모듈 이후에 병목 현상이 발생하게 됩니다.
이 접근 방식의 장점은 필요한 리소스를 줄여주는 단 하나의 DMA 채널만 필요하다는 것입니다. 또한, 지연 시간은 순차 출력을 위한 이론적 최솟값에 도달합니다. 빨간색 채널에 대한 DMA 전송은 지연 없이 즉시 시작됩니다. 이 솔루션의 단점은 3개의 프레임 그래버 메모리 연산자가 필요하다는 점입니다. 이러한 연산자는 제한되어 있으므로, 이 버퍼가 더 이상 필요하지 않은 경우에만 이 솔루션이 유용합니다.
| 간략한 설명 | |
|---|---|
|
파일: \examples\Processing\Color\ColorPlaneSeparation\ColorPlaneSeparation_Option3_SequentialMultiROI.va |
 |
|
Default Platform: mE5-MA-VCL |
|
|
간단한 설명 RGB 컬러 플레인 분리 예제. 3개의 RGB 컬러 플레인의 순차적인 DMA 출력이 수행됩니다. 시퀀스는 ImageBufferMultiRoI에 의해 생성됩니다. 이 솔루션은 대역폭을 제한하므로 좋지 않습니다. 최적화된 솔루션은 다음 예제를 참조하십시오. |
|
이 솔루션은 이전 예제와 다음 예제 사이의 중간 단계입니다. 대역폭 제한으로 인해 이 솔루션을 구현하는 것은 권장되지 않습니다. 그러나 단 하나의 프레임 그래버 RAM만 요구하면서 이전 예제와 동일한 출력을 얻는 방법을 간단한 방식으로 설명합니다. 영상을 순차화하기 위해 ImageBufferMultiRoI 연산자를 사용합니다. 이 연산자에서는 동일한 영상을 단순히 세 번 읽습니다. 그 후, 첫 번째 영상에는 빨간색 컴포넌트를, 두 번째 영상에는 초록색을, 세 번째 영상에는 파란색 컴포넌트를 선택합니다. 이는 ModuloCount 및 CASE 연산자를 사용하여 쉽게 수행할 수 있습니다. ModuloCount는 프레임 번호 모듈로 3(즉, {0, 1, 2, 0, 1, 2, ...})을 카운트하도록 매개변수화됩니다.
앞서 언급했듯이, 이 솔루션은 대역폭을 줄이기 때문에 최적의 상태가 아닙니다. 그 이유는 동일한 입력 영상을 세 번 읽으면서도 세 가지 컴포넌트 중 하나만 사용하기 때문입니다. 따라서 모든 읽기 주기마다 데이터의 3분의 2가 폐기됩니다. 다음 예제에서는 이 제한을 극복하는 유사한 솔루션을 보여줍니다.
| 간략한 설명 | |
|---|---|
|
파일: \examples\Processing\Color\ColorPlaneSeparation\ColorPlaneSeparation_Option4_SequentialPreSortMultiROI.va |
 |
|
Default Platform: mE5-MA-VCL |
|
|
간단한 설명 RGB 컬러 플레인 분리 예제. 3개의 RGB 컬러 플레인의 순차적인 DMA 출력이 수행됩니다. 시퀀스는 ImageBufferMultiRoI에 의해 생성됩니다. 추가적인 사전 정렬(pre-sorting)을 통해 대역폭을 최적화하고 이전 예제에 제시된 문제를 해결합니다. |
|
이 예제는 이전 예제와 유사합니다. 대조적으로, 이 경우 대역폭 제한이 없습니다. 개념은 동일합니다. ImageBufferMultiRoI 연산자를 사용하여 세 가지 컬러 컴포넌트를 순차화합니다. 이전 예제와 달리, 버퍼 이후에 색상을 분리하지 않습니다. 대신 색상을 버퍼에 쓰기 전에 분리합니다. 이는 다음 그림에 내용이 표시된 HierarchicalBox PreSort에서 수행됩니다.

이 접근 방식의 개념은 버퍼에 쓰기 전에 컬러 컴포넌트를 분리하는 것입니다. 이는 모든 영상 라인에 대해 수행됩니다. 따라서 컬러 컴포넌트를 세 개의 링크로 분할합니다. 이 결과 그레이스케일 링크에는 이제 입력 영상의 영상 라인이 포함됩니다. 다음으로, 라인들이 멀티플렉싱되고 추가됩니다. 그 결과 하나의 큰 영상 안에 세 개의 그레이스케일 영상이 생깁니다. 빨간색 컴포넌트는 왼쪽에, 초록색은 가운데에, 파란색은 오른쪽에 위치합니다. 구현을 이해하려면 다음 그림의 시뮬레이션 결과를 살펴보십시오.
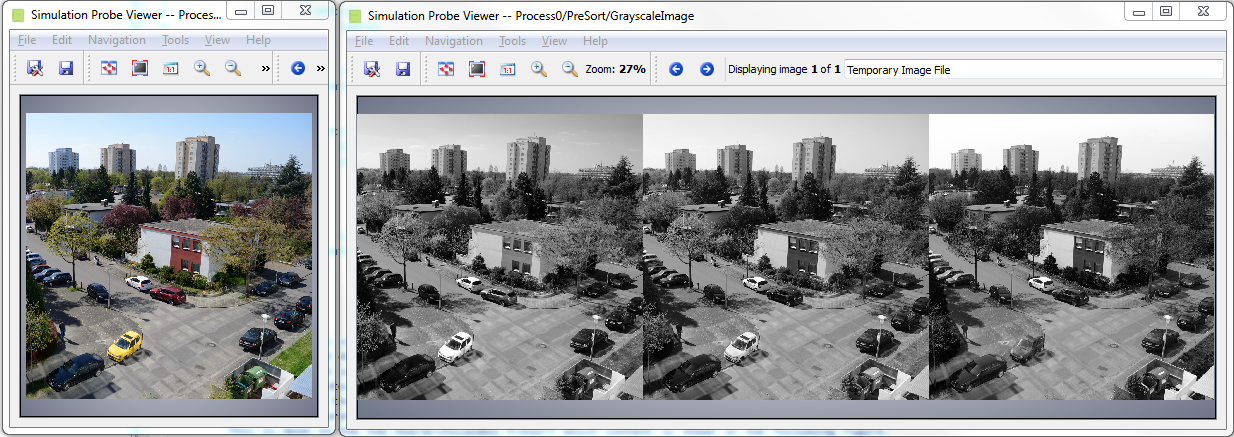
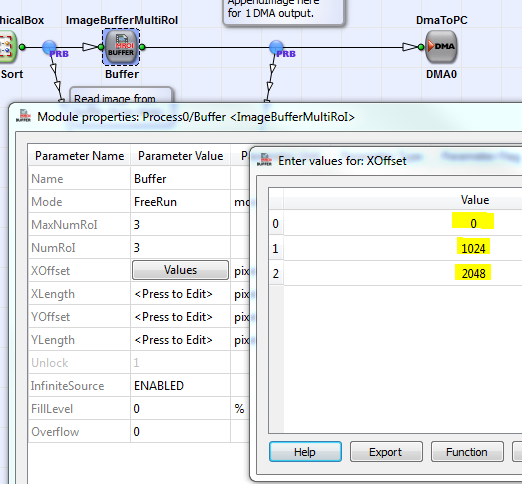
ImageBufferMultiRoI에서는 이제 왼쪽 부분을 먼저 읽어야 합니다. 그 후 중간 부분을, 마지막으로 오른쪽 부분을 읽습니다. 따라서 다음과 같이 각 ROI에 대해 서로 다른 XOffset을 설정해야 합니다.
사용 시 예제에 표시된 대로 컴포넌트를 분리하기 전에 Parallelism을 높이는 것을 잊지 마십시오. 이는 InsertLine 모듈 이후의 병목 현상을 방지하는 데 필요합니다. 더 이상 24비트 RGB 영상이 아닌 8비트 그레이스케일 영상을 전송하므로 입력보다 최소 세 배 더 높은 Parallelism이 필요합니다.
이 솔루션은 단 하나의 DRAM 연산자만 필요로 하며 대역폭을 제한하지 않습니다. 이것이 최적화된 솔루션입니다. 그러나 FIFO에서 분리된 컴포넌트 라인을 버퍼링하기 위해 일부 블록 RAM이 필요합니다. 작은 영상의 경우 이는 문제가 되지 않습니다. 그러나 라인당 16384픽셀과 같은 넓은 영상 너비를 가질 경우 많은 블록 RAM이 필요합니다. 이 마지막 단점은 다음 예제로 해결됩니다.
| 간략한 설명 | |
|---|---|
|
File: \examples\Processing\Color\ColorPlaneSeparation\ColorPlaneSeparation_Option5_SequentialAdvanced.va |
 |
|
Default Platform: mE5-MA-VCL |
|
|
간단한 설명 컬러 플레인 분리 예제. RGB 입력이 컴포넌트로 분할되어 하나의 DMA 채널을 통해 순차적으로 출력됩니다. 분할은 병렬 단어에서 동일한 컴포넌트를 수집하고 FrameBufferRandomRead로 읽어와서 수행됩니다. |
|
이 예제는 VisualApplets 에서 소개된 색상 플레인 분리 방식 중 가장 진보된 예시입니다. 이 예제는 리소스 사용량을 최소화하고 대역폭을 극대화하는 데 중점을 둡니다. 이전 예제에서는 색상 구성 요소를 분리하기 위해 사전 정렬을 사용하여 버퍼에서 각 구성 요소를 개별적으로 읽을 수 있도록 했습니다. 그러나 사전 정렬 과정의 FIFO를 위해 일정량의 블록 RAM이 필요합니다. 이 접근 방식에서도 사전 정렬을 사용합니다. 다만, 각 색상 성분별로 8개의 연속된 픽셀을 수집한 후에만 다음 성분으로 전환합니다. 이전 예제에서는 한 성분의 전체 라인을 수집한 후 다음 라인으로 전환했습니다. 이러한 수정으로 인해 더 이상 FIFO가 필요하지 않게 되었습니다. 다만, 이 경우에는 ImageBufferMultiRoI 를 사용할 수 없습니다. 대신 FrameBufferRandomRead를 사용해야 합니다.
사전 정렬 과정은 간단합니다. 먼저, 병렬 처리 수준을 8로 늘립니다. 다음으로, 구성 요소를 분할합니다. 그 결과, 각각 8개의 병렬 처리가 이루어지는 세 개의 링크가 생성됩니다. 이제 MergeParallel이 각 구성 요소의 8개 픽셀을 시퀀스로 배열합니다. 따라서 다음과 같은 시퀀스를 얻게 됩니다: R0부터 R7, G0부터 G7, B0부터 B7, R8부터 R15, G8부터 G15, B8부터 B15, ...

16에서 8로 병렬 처리 ( PARALLELdn )가 이루어지기 때문에 입력 측에 FIFO가 필요합니다. 이 FIFO는 DRC 레벨 2 오류를 방지하기 위해서만 필요합니다. 실제로 데이터를 버퍼링할 필요가 없으므로, 크기를 2픽셀로 매우 작게 설정했습니다.
픽셀을 미리 정렬한 후, FrameBufferRandomRead 연산자에 버퍼링됩니다. 이 연산자는 행 및 열 주소 입력을 받으며, 데이터를 무작위로 읽을 수 있게 해줍니다.
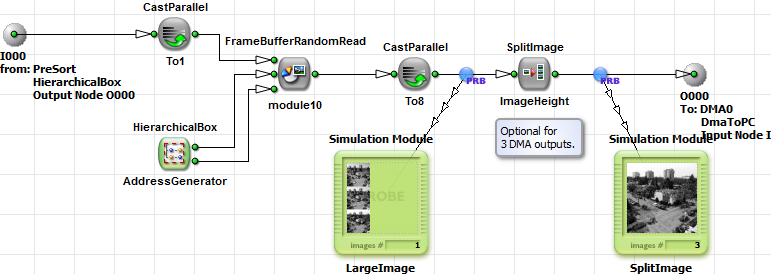
이 연산자는 병렬도 1일 때만 사용할 수 있습니다. 따라서 CastParallel을 사용하여 픽셀당 8비트인 병렬도 8에서 픽셀당 64비트인 병렬도 1로 형변환합니다. 이것이 바로 이전 단계에서 연속된 8개의 픽셀을 수집한 이유입니다.
색상 성분을 분리하려면 원치 않는 색상을 건너뛰기 위해 주소를 2씩 늘려야 합니다. 따라서 적색 성분의 읽기 주소는 다음과 같습니다: RColA(0) = 0, RColA(1) = 2, RColA(2) = 5, ... 녹색 성분의 경우, 읽기 주소는 다음과 같습니다: RColA(0) = 1, RColA(1) = 3, RColA(2) = 6, ... 계층적 박스(Hierarchical box)인 AdressGenerator는 이러한 읽기 주소를 생성합니다. CreateBlankImage 연산자는 필요한 이미지 크기를 정의합니다. 앞서 8에서 1로 CastParallel을 사용했으므로, 이미지 너비를 8로 나눈 값을 사용해야 합니다.

열 주소는 Coordinate_X 출력을 3으로 곱하여 간단히 생성됩니다. 현재 컴포넌트에 따라 값에 0, 1 또는 2를 오프셋으로 더합니다.
AppendImage를 사용하여 세 개의 주소 이미지를 하나의 더 큰 이미지로 병합합니다. 행 주소는 0부터 이미지 높이까지의 카운터를 사용하여 간단히 생성됩니다. 이 경우, 이 작업을 위해 ModuloCount 연산자를 사용합니다. 이제 이 주소들을 FrameBufferRandomRead 연산자에 입력할 수 있습니다. FrameBufferRandomRead의 성능을 극대화하기 위해 CreatBlankImage 출력에서 병렬도 2를 설정하는 것을 잊지 마십시오.
버퍼 처리 후, 첫 번째 줄에 빨간색 이미지가 포함되고, 그 다음 줄에는 녹색 이미지가, 마지막 줄에는 파란색 이미지가 포함된 큰 이미지를 얻게 됩니다. 이 큰 이미지를 세 개의 별도 DMA 출력으로 분할하기 위해 SplitImage를 사용하고 이미지 높이를 설정합니다.
구현 방식을 이해하는 가장 쉬운 방법은 중간 결과를 단계별로 살펴보는 것입니다. 하나의 결과 이미지를 얻기 위해서는 세 단계를 시뮬레이션해야 한다는 점에 유의하십시오. 이는 연산자에 의해 3개의 이미지가 생성되어야 하기 때문입니다 CreateBlankImage에 의해 3개의 이미지가 생성되어야 하기 때문입니다.
이 솔루션은 필요한 블록 RAM 리소스가 적기 때문에 리소스 효율이 높습니다. 또한, FPGA 로직 리소스도 효율적으로 활용됩니다. 주소 생성에 필요한 리소스도 적습니다.
 이전

