
Operator Library: Memory
LineMemoryRandomRd(라인 메모리 임의 읽기) 연산자는 임의 읽기 액세스를 지원하는 소형 메모리 블록입니다. 데이터의 임의 읽기는 RColA(읽기 열 주소) 포트로 주소를 전송하여 수행할 수 있습니다. 연산자는 이 주소를 사용하여 지정된 좌표의라인 데이터를 읽습니다. 결과 출력 프레임의 이미지 폭은 주소 입력의 이미지 폭과 동일합니다.
Operator 레이턴시에 대한 정보는 Table 46, 'Individual Latencies of the Operators in Library Memory'를 참조하십시오.
LineMemoryRandomRd 연산자는 수신되는 이미지 라인을 저장하고 임의 읽기 액세스를 허용합니다. 라인 데이터는 링크 I를 통해 연산자로 전송됩니다.
필요한 memory 크기는 입력 프레임의 이미지 폭(Max. Img Width)에 따라 정의됩니다.
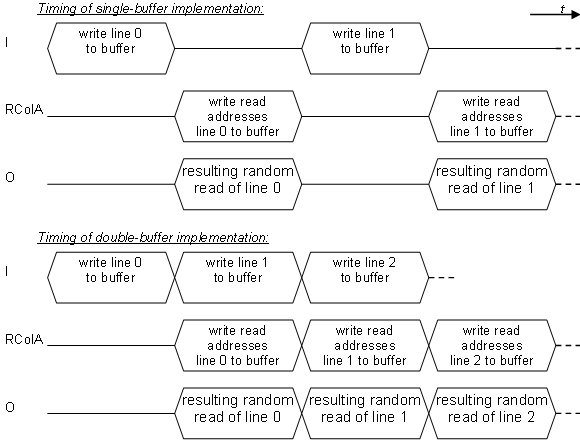
이 연산자는 단일 버퍼 구현과 이중 버퍼 구현의 두 가지 변형으로 구현할 수 있습니다. 첫 번째 구현은 RAM을 절약하지만 쓰기와 읽기의 시간적 중첩을 허용하지 않습니다. 따라서 쓰기 상태에서는 주소 입력 링크 RColA 및 RRowA가 중지됩니다. 후자의 구현은 RAM을 두 배로 늘리고, 입력 링크 I에서 다음 프레임을 수용하는 동시에 마지막 프레임을 임의 읽기할 수 있도록 합니다.
오퍼레이터에는 두 가지 상태가 있습니다.
-
쓰기 상태: 링크 I의 픽셀이 버퍼에 선형으로 저장됩니다. 즉, 픽셀의 좌표가 버퍼의 주소를 구성합니다.
-
읽기 상태: 입력 RColA에 지정된 주소를 사용하여 memory를 읽습니다. 주소의 수와 주소 링크 이미지 폭이 이미지 출력 폭을 정의합니다. 예를 들어 주소 입력에 단일 픽셀로 구성된 라인이 입력되면 출력 프레임 폭은 단일 픽셀로만 구성됩니다. 입력 라인의 다른 픽셀들은 폐기됩니다.
이미지 데이터 입력과 주소 입력은 서로 동기화되지 않습니다. 서로 다른 이미지 크기를 가질 수 있습니다.
입력 링크의 타이밍에 주의하시기 바랍니다. 주소 입력은 버퍼링 없이 데이터 링크 입력 I와 동일한 연산자로부터 소스를 공급받아서는 안 됩니다. 이미지 데이터를 연산자에 쓰는 동안에는 현재 프레임을 읽기 위한 주소를 수용할 수 없기 때문입니다. 프레임이 버퍼에 완전히 저장된 경우에만 주소를 수용할 수 있습니다. 많은 응용 분야에서는 연산자를 사용하여 주소용 이미지를 생성합니다.
타이밍은 다음 그림에 시각화되어 있습니다.
이 연산자는 FPGA 내부 블록 RAM memory를 사용합니다. 따라서 RAM 유형의 비 VisualApplets 프레임 그래버 리소스가 사용됩니다. FPGA 내부 블록 RAM은 제한되어 있습니다. 전체 해상도 프레임이 FPGA 내부 블록 RAM에 맞지 않을 수 있습니다. 대신 FrameBufferRandomRead 연산자 사용을 고려해 보세요.
Operator 제한 사항
-
빈 프레임은 지원되지 않습니다.
-
라인 길이가 다른 이미지는 지원되지 않습니다.
LineMemoryRandomRd 시뮬레이션
VisualApplets 시뮬레이션을 실행하는 방법에는 이미지 기반 시뮬레이션(시스템 설정에서 활성화)과 라인별 시뮬레이션(시스템 설정에서 활성화)의 두 가지가 있습니다. 일반적인 시뮬레이션에 대한 자세한 내용은 'Simulation'을 참조하세요.
-
라인별 시뮬레이션
라인별 시뮬레이션에서는 라인이 개별적으로 처리됩니다. 출력 라인 수는 입력 링크 I 및 RColA 모두의 입력 라인 수와 입력 I의 이미지 프로토콜에 따라 달라집니다.
-
I.Img Protocol = VALT_IMAGE2D:
입력 이미지 I의 전체 데이터 이미지를 처리하기에 충분한 라인이 주소 입력 RColA에 있는 경우에만 입력 이미지가 처리됩니다. 주소 입력 RColA의 이미지 프로토콜은 이 시뮬레이션에서 무시됩니다. 사용 가능한 주소 라인이 충분하지 않은 경우, 시뮬레이션에서 불완전한 프레임이 생성되는 것을 방지하기 위해 해당 입력 이미지가 처리되지 않으며 출력 이미지도 생성되지 않습니다. 이 시뮬레이션 동작은 하드웨어에서의 실제 LineMemoryRandomRd 동작과 다릅니다. 위의 이미지에서 볼 수 있듯이, 하드웨어의 연산자는 들어오는 데이터를 라인별로 처리합니다. 결과적으로 하드웨어에서는 전체 입력 이미지를 처리할 수 있는 주소 라인이 충분히 사용 가능한지와 관계없이 들어오는 모든 라인을 가능한 한 빨리 처리합니다.

-
I.Img Protocol = VALT_LINE1D:
입력 I의 들어오는 데이터 라인은 해당 주소 라인(입력 RColA)을 사용할 수 있게 되는 즉시 처리됩니다. 주소 입력 RColA의 이미지 프로토콜은 이 시뮬레이션에서 무시됩니다.

-
-
이미지 기반 시뮬레이션
입력 I의 들어오는 데이터 이미지 높이와 입력 RColA의 들어오는 주소 이미지 높이는 동일해야 합니다. 일차원 링크의 라인 시퀀스는 2차원 이미지로 처리되므로 이 시뮬레이션에서는 이미지 프로토콜이 무시됩니다.

| Property | Value |
|---|---|
| Operator Type | M |
| Input Links | I, 이미지 데이터 입력 RColA, I에서의 픽셀에 대한 읽기 열 주소 |
| Output Link | O, 데이터 입력 |
동기식 및 비동기식 입력
- 모든 입력은 서로 비동기식입니다.


|
|
부호 없는 입력의 Bit Width 범위는 [1, 64]입니다. 부호 있는 입력의 경우 범위는 [2, 64]입니다. 부호 없는 컬러 입력의 경우 범위는 [3, 63]이고, 부호 있는 컬러의 경우 범위는 [6, 63]입니다. |
|
|
행 주소의 Bit Width는 다음과 같습니다: 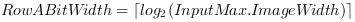 |
| 구현 | |
|---|---|
| Type | static parameter |
| Default | SingleBuffer |
| Range | {SingleBuffer, DoubleBuffer} |
|
이 파라미터는 FrameMemoryRandomRd의 구현을 선택합니다(위 참조). |
|
LineMemoryRandomRd 연산자의 사용법은 다음 예제에 나와 있습니다.
-
예시 - Logic Analyzer: 오실로스코프와 같은 신호 측정 및 분석을 수행하는 편리한 방법입니다.
-
'Functional Example for Specific Operators of Library Memory and Library Signal'
Examples - Demonstration of how to use the operator
 이전

