OCR vTool#
광학 문자 인식(OCR)의 주요 목적은 이미지 속의 물체를 식별하거나, 해당 물체에 표시된 특정 정보(예: 유통기한, 일련번호, 제품 라벨 등)를 읽어내는 것입니다.
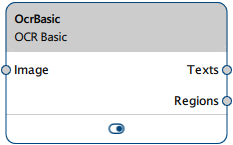
OCR vTool 는 Image 입력 핀을 통해 이미지를 수신합니다. 텍스트와 인식된 단어의 분할 영역은 Texts 및 Regions 출력 핀을 통해 출력됩니다.
OCR vTool 의 라이선스를 구매하려면 Basler 웹사이트를 방문하십시오.
작동 방식#
지정된 관심 영역 내에서, 자동 텍스트 인식( OCR vTool )은 텍스트를 단어와 개별 문자로 분할하고, 각 문자를 알파벳, 숫자 또는 특수 문자(예: 구두점)로 분류합니다.
이름과는 달리, ‘ OCR vTool ’는 단일 문자를 읽는 것이 아니라 단어를 읽습니다. 단어의 최소 길이는 2자입니다.
텍스트가 여러 줄에 걸쳐 있는 경우, 각 줄은 최소한 하나의 단어로 간주됩니다. 한 줄 내에서 단어 사이에 큰 간격이 있는 경우, 알고리즘은 해당 단어들을 서로 다른 단위로 간주합니다.
4단계로 구성된 마법사가 vTool 설정 과정을 안내합니다. 이 마법사는 설정이 미치는 영향에 대해 즉시 피드백을 제공합니다. 각 단계에 대한 자세한 내용은 다음 섹션을 참조하십시오.
미리보기 영역#
미리보기 영역은 vTool 설정에서 변경한 내용을 즉시 확인할 수 있게 해주는 유용한 도구입니다.
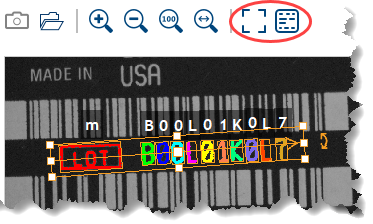
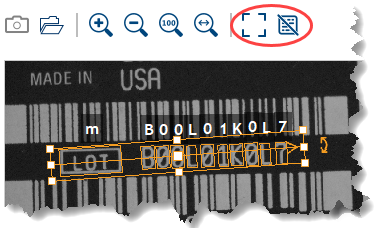
미리보기 영역 위에는 두 개의 버튼이 있는데, 하나는 분할된 영역과 인식된 문자의 경계 상자 표시 여부를 전환하는 버튼이고, 다른 하나는 영역을 강조 표시하는 버튼입니다.
바운딩 박스 및 인식된 문자 표시#
이 버튼을 사용하면 분할된 영역 주위의 경계 상자를 표시하거나 숨길 수 있습니다:

인식된 각 문자 위에는 인식 결과 문자가 표시됩니다. 이를 통해 인식이 올바르게 이루어졌는지 빠르게 확인할 수 있습니다.
지역 강조 표시#
이 버튼을 사용하면 분할된 영역을 강조 표시할 수 있습니다:

이를 통해 문자가 완전히 인식되었는지, 아니면 부분적으로만 인식되었는지 더 쉽게 파악할 수 있습니다. 이는 대비와 같은 분할 설정을 미세 조정하는 데 도움이 됩니다.
1단계: 초기 설정#
먼저 디스크에서 또는 실시간 카메라 영상을 사용하여 적절한 학습 이미지를 불러옵니다. 학습 이미지는 다음 측면에서 검사 이미지를 대표해야 합니다:
- 텍스트의 위치와 방향
- 문자 크기 ( 문자 크기를 수동으로 지정하는 경우)
자동 모드에서는 문자 크기가 달라질 수 있습니다.
Basler는 ‘ OCR vTool ’을 구성할 때 다양한 샘플 이미지를 사용할 것을 권장합니다. 이렇게 하면 텍스트의 화질을 더 정확하게 평가하고, 분할 결과와 후보 항목의 신뢰도를 확인할 수 있습니다. 이러한 샘플 이미지는 이상적으로 해당 애플리케이션에서 나타날 것으로 예상되는 전체 문자 집합을 포괄해야 합니다.
직사각형 설정#
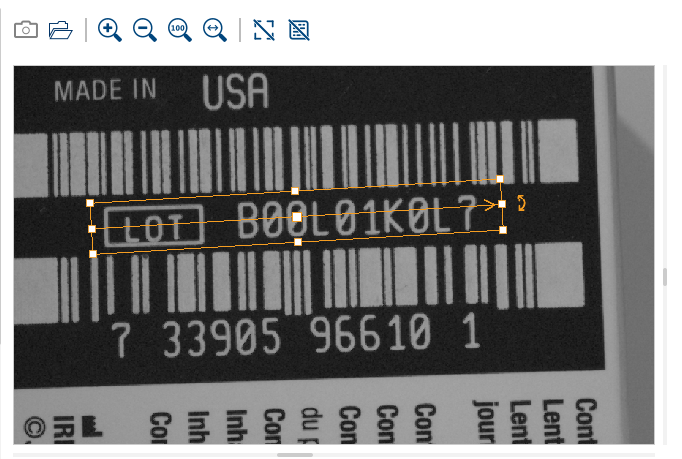
이미지를 불러오면 이미지 내에 사각형이 표시됩니다. 이 사각형은 텍스트가 위치한 영역을 표시하는 데 사용됩니다. 사각형의 핸들을 드래그하거나 미리보기 영역 왼쪽에 있는 입력란에 수치를 직접 입력하여 사각형의 위치, 방향 및 크기를 조정할 수 있습니다.
OCR 알고리즘은 문자와 원치 않는 이미지 요소(잡다한 요소) 또는 노이즈를 구분할 수 없으므로, 해당 영역에는 읽고자 하는 텍스트만 포함되어야 합니다. 잡다한 요소나 노이즈를 완전히 피할 수 없는 경우, 후처리 단계를 추가하거나 다른 OCR 도구를 활용하여 여러 텍스트 영역을 정의하는 등 적절한 조치를 취해야 합니다. 또한, 이미지마다 텍스트가 모든 방향으로 약간씩 이동할 수 있으므로, 텍스트 주위에 사각형을 너무 꽉 끼우지 마십시오.
영역을 지정할 때는 영역 사각형을 가로지르는 화살표를 확인하십시오. 이는 읽기 방향을 나타냅니다. 다른 방향으로 쓰인 텍스트는 읽을 수 없습니다.
OCR vTool 가 안정적으로 작동하려면, 처리하려는 모든 이미지에서 텍스트의 방향이 대체로 동일해야 합니다. 몇 도 정도의 사소한 편차는 허용됩니다. Basler는 텍스트를 왼쪽에서 오른쪽으로 읽을 수 있도록 카메라를 배치할 것을 권장합니다. 텍스트의 방향이 이와 다르지만(일정한) 경우, 화살표가 텍스트의 읽는 방향을 가리키도록 하면서 해당 영역 사각형을 적절히 배치하십시오.
텍스트의 위치가 크게 달라지고 텍스트 주변의 여백이 제한적인 경우, 텍스트의 방향과 위치를 안정적으로 유지하기 위해 전처리 단계에서 이미지 정렬을 추가해야 합니다.
이 이미지는 텍스트의 흐름을 따라 사각형을 약간 회전시킨 예시 이미지입니다.
글꼴 설정#
이미지 내의 텍스트에 어울리는 글꼴과 해당 문자 집합을 선택하십시오. 일반적으로 이는 응용 프로그램의 사양이나 인쇄 공정에 따라 결정됩니다.
다음 표에는 사용 가능한 글꼴 목록과 각 글꼴의 표시 예시가 나와 있습니다:
| 글꼴 이름 | 설명 | 외관 |
|---|---|---|
| 표준 혼합형 | 문서에서 흔히 사용되는, 세리프가 있거나 없는 다양한 글꼴 | 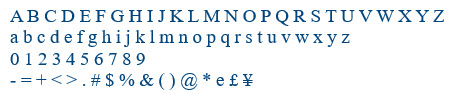 |
| 표준 산세리프 | 문서에서 흔히 사용되는, 세리프가 없는 다양한 사무용 서체 | 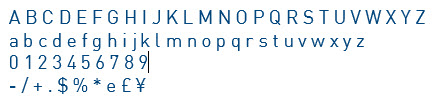 |
| OCR-A | OCR-A 표준에 정의된 바와 같이 | 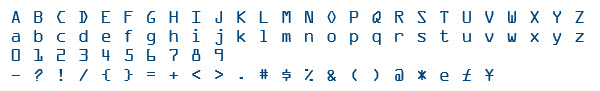 |
| OCR-B | OCR-B 표준에 정의된 바와 같이 | 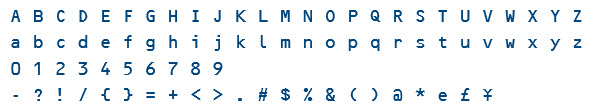 |
| 도트 프린트 | 도트 프린터로 출력된 다양한 도트 프린트 글꼴 | 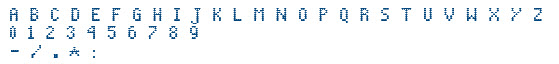 |
| 제약 | 제약 업계에서 사용되는 세리프가 없는 서체 | 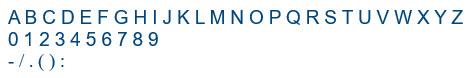 |
| SEMI | SEMI 표준에 정의된 바와 같이 반도체 산업에서 사용되는 서체 | 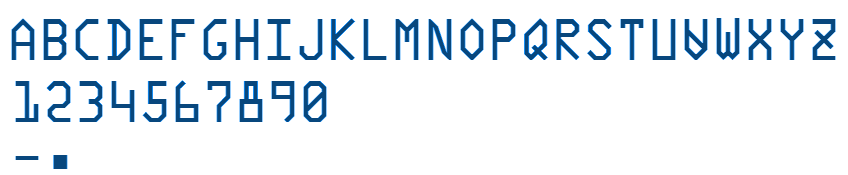 |
| 손글씨 | 손으로 쓴 숫자 | 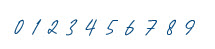 |
글꼴에 따라 사용 가능한 문자 집합이 다릅니다. 문자 집합은 다음 하위 집합 중 일부 또는 전부를 포함할 수 있습니다:
- 대문자
- 소문자
- 숫자
- 특수 문자
인식 가능한 특수 문자는 글꼴에 따라 다릅니다.
다음 표에는 각 글꼴로 인식할 수 있는 문자들이 나열되어 있습니다:
| 글꼴 이름 | 대문자 | 소문자 | 숫자 | 특수 문자 |
|---|---|---|---|---|
| 표준 혼합형 | 예 | 예 | 예 | - = + < > . # $ % & ( ) @ * e £ ¥ |
| 표준 산세리프 | 예 | 예 | 예 | - / + . $ % * e £ ¥ |
| OCR-A | 예 | 예 | 예 | - ? ! / { } = + < > . # $ % & ( ) @ * e £ ¥ |
| OCR-B | 예 | 예 | 예 | - ? ! / { } = + < > . # $ % & ( ) @ * e £ ¥ |
| 도트 프린트 | 예 | 아니요 | 예 | - / . * : |
| 제약 | 예 | 아니요 | 예 | - / . ( ) : |
| SEMI | 예 | 아니요 | 예 | - . |
| 손글씨 | 아니요 | 아니요 | 예 | 해당 없음 |
거절 수업#
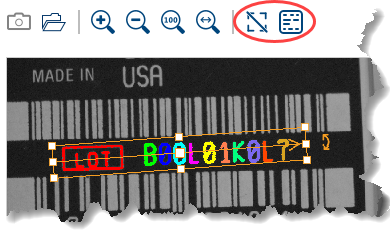
‘거부 클래스’를 사용하면 모호한 결과, 즉 vTool이 인식하지 못한 문자를 처리할 수 있습니다. 이러한 문자는 ‘거부된 문자’로 분류되며, ‘ pylon Viewer ’ 내에서 나타나는 위치에 따라 서로 다른 물음표 아이콘으로 표시됩니다.
이 아이콘은 설정 대화 상자에서 사용됩니다:

이 아이콘은 핀 데이터 보기에서 사용됩니다:
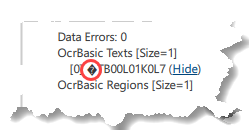
거절 클래스를 사용하여 결과의 신뢰도를 더 정확하게 평가하십시오. 신뢰도는 특히, 해당 문자가 훈련된 글꼴에 얼마나 잘 부합하는지뿐만 아니라, 문자의 인쇄 또는 이미지 품질을 반영합니다.
신뢰도 값이 가장 높은 결과가 ‘거부’ 클래스에 속하는 경우, 이미지의 해당 부분은 특정 문자로 명확하게 판별할 수 없습니다. 이는 이미지의 번짐 현상이나 문자가 불완전하게 인쇄된 데 기인할 수 있습니다. 이러한 현상이 자주 발생한다면, 이는 이미지 품질이 좋지 않음을 나타냅니다. 이 경우, 이미지 품질을 개선하거나 후처리 단계에서 해당 문자를 판독 불가능한 것으로 처리할 수 있습니다. 이 방법을 사용하면 신뢰도가 더 낮은 문자를 대신 선택할 수 있으므로, 보다 안전한 접근 방식이 됩니다.
분류 결과가 종종 모호한 경우, 정규식을 사용하여 단어 수정을 수행하는 것을 고려해 볼 수 있습니다.
항상 문자를 반환하려면 ‘거부 허용’ 옵션을 비활성화하십시오.
자신에게 적합한 설정을 찾으려면, 해당 옵션을 켜고 끄면서 4단계에서 후보 목록과 인식된 단어의 결과가 어떻게 달라지는지 확인해 보세요.
2단계: 캐릭터 크기#
문자 분할은 문자의 치수, 즉 너비, 높이, 획 두께에 관한 몇 가지 가정을 바탕으로 이루어집니다. OCR vTool 는 이미지 데이터에서 이러한 치수를 직접 도출하는 자동 알고리즘을 지원합니다. 또는 원하는 치수 범위를 수동으로 지정할 수도 있습니다. 문자 높이는 20~30픽셀 범위가 적당하지만, 더 큰 문자 크기도 지정할 수 있습니다. 20픽셀 미만의 문자는 더 이상 안정적으로 인식할 수 없습니다.
정보
텍스트 내에서 또는 서로 다른 이미지 간에 글자 크기가 제각각인 경우 자동 모드를 사용하십시오. 그러면 크기에 상관없이 모든 글자를 읽을 수 있습니다.
치수를 수동으로 지정하는 대표적인 경우는 자동 모드에서 분할 시 잡음을 제거하지 못한 경우입니다. 이 경우, 치수를 수동으로 지정하면 원치 않는 이미지 요소를 제거할 수 있습니다.
3단계: 세분화 설정#
Contrast#
이미지 내 객체의 분할은 지정된 최소 명암비 값을 임계값으로 하는 임계값 처리 기법을 기반으로 합니다. 최소 명암비를 조정하고 미리보기 영역에서 분할 결과를 확인하십시오. 더 명확한 시각화를 위해 미리보기 영역 상단의 토글 버튼을 사용하여 영역 분할 보기를 활성화하십시오.
모든 문자가 올바르게 분할되고 인식될 수 있는 최소 명암비 설정을 선택하십시오. 최소 명암비를 너무 낮게 설정하지 마십시오. 그렇지 않으면 원치 않는 잡음이 감지될 수 있습니다.
제공되는 글꼴은 밝은 배경에 어두운 글자를 표시하도록 훈련되었으며, 이러한 용도로만 사용하도록 설계되었습니다. 이 ‘극성’ 설정이 사용 중인 애플리케이션에 적합하다면 ‘밝은 배경에 어두운 글자’ 옵션을 사용하십시오.
어두운 배경에 밝은 색상의 문자가 포함된 애플리케이션의 경우, ‘밝은 색상/어두운 배경’ 옵션을 사용해야 합니다. 이 경우, 전처리 단계에서 이미지가 내부적으로 반전됩니다.
응용 프로그램에 배경보다 밝거나 어두운 텍스트가 포함된 경우, ‘Both’ 옵션을 선택하십시오. 단, ‘ OCR vTool ’는 극성이 혼합된 텍스트는 읽을 수 없습니다. 텍스트 영역 내에서는 극성이 동일해야 합니다.
간격#
단어에는 점, 쉼표, 하이픈 등과 같은 특수 문자도 포함될 수 있습니다. 이들 중 대부분은 문장 부호입니다. 그러나 하이픈과 등호는 구분 기호로 간주됩니다.
일부 응용 프로그램에서는 이러한 문자를 읽어야 할 수도 있습니다. 이 경우 특수 문자가 포함된 문자 집합을 선택하고 ‘구두점 및 구분 기호’ 옵션을 활성화하십시오.
다른 용도의 경우, 구두점이나 구분 기호 없이 단어를 읽는 것이 더 나을 수도 있습니다. 예를 들어, 날짜를 읽을 때 숫자만 확인하고자 하는 경우 등이 있습니다. 따라서 숫자 전용 문자 세트를 선택하고 ‘구두점’ 및 ‘구분 기호’ 옵션을 비활성화하십시오.
간격과 관련해서는 개별 문자 간의 거리도 고려해야 합니다. 텍스트를 개별 영역으로 성공적으로 분할하려면 문자 사이에 충분한 간격이 있어야 합니다. 하지만 실제로는 문자가 너무 밀착되어 있어 서로 구별하기 어려운 경우가 많습니다. 애플리케이션에서 이러한 현상이 발생한다면 ‘접해 있는 문자 분리’ 옵션을 활성화하십시오.
도트 프린트#
닷 프린트(Dot Print) 글꼴은 글자가 연속적인 획이 아닌 개별 점들로만 구성되어 있다는 점에서 다른 모든 글꼴 유형과 다릅니다. 닷 프린트 텍스트를 읽기 위해, OCR vTool 에서는 전용 분할 및 분류 옵션을 제공합니다. 이러한 옵션을 사용하려면 마법사의 1단계에서 닷 프린트 글꼴을 선택해야 합니다. 글자 간 간격이 충분히 넓고 닷 프린트 배열이 조밀한 일반적인 닷 프린트 글자는 바로 읽을 수 있습니다.
문자 내 점들 사이의 간격에 비해 문자 간의 간격이 비슷하거나 더 좁은 도트 인쇄 텍스트의 경우, Basler는 ‘문자 간격 좁히기’ 옵션을 활성화할 것을 권장합니다.
성공적인 분할을 위해서는 문자의 점들 사이의 간격도 고려해야 합니다. 조밀한 점 인쇄 방식에서는 점들이 서로 매우 가깝게 배열되어 있으며, 간격의 크기에 변동이 없습니다. 이러한 문자는 기본 설정인 ‘자동’ 옵션을 활성화하면 잘 인식할 수 있습니다. 이 경우 내부 자동 모드가 사용됩니다.
그러나 일부 간격이 다른 간격보다 더 큰 경우, 단일 문자의 분할이 실패하여 해당 문자가 두 개 이상의 영역으로 나뉘어질 수 있습니다. 이러한 상황에서는 ‘최대 점 간격(Max. dot gap )’ 옵션을 사용하여 점 사이의 최대 허용 간격을 수동으로 지정하는 것이 도움이 될 수 있습니다. 다만, 이렇게 하면 처리 시간이 늘어날 수 있습니다.
4단계: 결과#
마법사의 마지막 단계에서는 단어 내 각 문자 위치에 해당하는 후보 목록과 신뢰도 값이 표 형태로 표시됩니다. 표에서 항목을 클릭하면 미리보기 영역에서 해당 바운딩 박스가 선택되며, 그 반대의 경우도 마찬가지입니다.
드롭다운 목록을 펼치면 모든 후보 항목을 확인할 수 있습니다. 후보 항목은 신뢰도 순으로 내림차순으로 정렬되어 있습니다. 이를 통해 캐릭터 분류의 전반적인 신뢰도를 평가할 수 있으며, 가능한 대안도 확인할 수 있습니다.
정보
신뢰도는 0에서 1 사이의 값입니다. 이는 문자 인식이 얼마나 정확하게 이루어졌는지를 나타냅니다. 분류 결과가 매우 우수할 경우 신뢰도 값이 0.99를 넘는 경우가 많습니다. 신뢰도 값이 0.9 또는 0.8 미만일 경우, 분류 결과가 신뢰할 수 없음을 나타낼 수 있습니다.
표 아래에는 ‘인식된 텍스트’ 영역이 있습니다. 여기에는 인식된 전체 텍스트가 간결한 형태로 표시됩니다.
정규 표현식#
OCR에서 흔히 직면하는 문제 중 하나는 숫자 0, 대문자 O, 소문자 o 간의 모호성입니다. OCR-A나 SEMI와 같은 전용 OCR 글꼴은 0과 O를 구분하도록 설계되었지만, 다른 글꼴들은 그렇지 않습니다. 정규식을 활용하면 이 문제를 해결할 수 있습니다.
정규식을 사용하면 단어 보정을 수행할 수 있습니다. 단어 보정이란, 단순히 신뢰도가 가장 높은 후보들만 선택하는 대신 다른 후보들도 함께 고려하여 정규식에 부합하는 후보들의 조합을 찾으려는 것을 의미합니다.
이를 위해 결과 표 위의 입력란에 텍스트에 포함된 단어 수만큼 정규식을 입력하십시오. 정규식 사이에는 공백 하나씩을 넣어 구분하십시오.
예시: “03/2026”과 같은 유통기한을 읽어야 한다고 가정해 봅시다. 주요 목적은 날짜나 시간의 숫자를 읽는 것입니다. 또한 특수 문자나 알파벳도 함께 읽어야 한다고 가정합니다. 이 경우, 숫자, 알파벳, 특수 문자가 모두 포함된 문자 집합을 선택해야 합니다. 정규 표현식 "(0[1-9]|10|11|12)/202[4-9]"를 사용하면 MM/YYYY 형식의 날짜 구조를 유지하면서 슬래시(/)도 함께 읽어낼 수 있습니다.
정보
정규 표현식은 문자를 추가하거나 제거하여 단어 길이를 수정할 수 없습니다. 정규 표현식은 단어 길이에 맞춰야 하며, 모든 이미지에서 단어 길이는 동일해야 합니다.
긴 단어의 철자 교정을 수행하면 처리 시간이 늘어날 수 있습니다.
vTool 구성#
OCR Basic vTool을 구성하려면:
-
vTool 설정 영역의 레시피 관리 창에서 ‘설정 열기’를 클릭하거나 vTool을 두 번 클릭합니다.
‘OCR 기본’ 대화 상자가 열립니다. -
이미지를 캡처하거나 엽니다.
다음 중 하나를 사용하십시오. 단일 촬영 버튼을 눌러 실시간 이미지를 캡처하거나 다음을 클릭하세요. 이미지 열기 기존 이미지를 열려면 이 버튼을 클릭하세요.
이미지가 불러오면 즉시 텍스트 인식 처리가 시작되며, 그 결과가 미리보기 영역에 표시됩니다.
창 하단에는 인식된 문자가 공백으로 구분된 단어 단위로 표시됩니다. 여기에는 공간이 제한되어 있어 전체 텍스트가 표시되지 않을 수 있습니다. 이는 단순히 몇 개의 문자가 인식되었는지를 나타내는 것일 뿐입니다. 전체 텍스트는 마법사의 4단계에서 표시됩니다.
자세한 내용은 다음을 참조하십시오. 1단계: 초기 설정.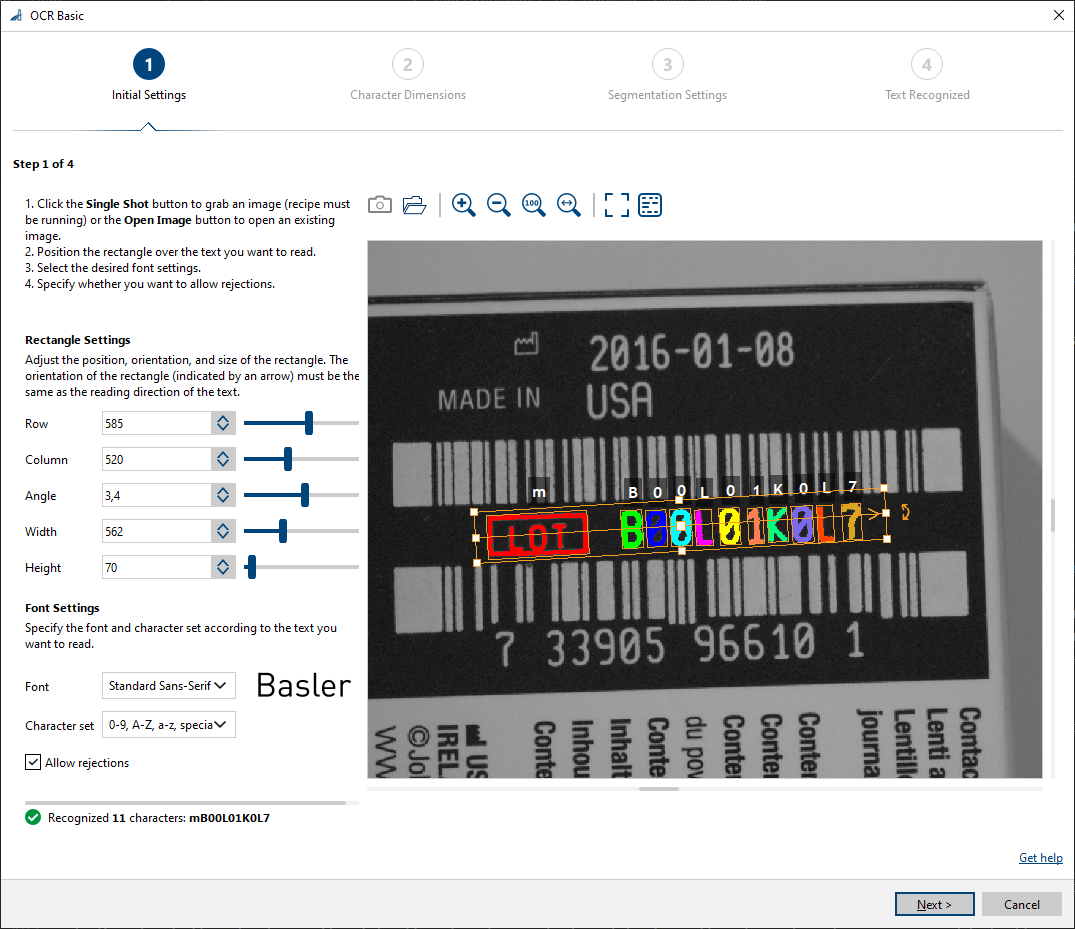
-
‘사각형 설정’ 영역에서 값을 직접 입력하여 텍스트 영역을 정의하십시오.
또는 미리보기 영역에 있는 영역 사각형의 핸들을 사용하여, 텍스트를 읽으려는 이미지 부분에 맞게 사각형을 이동, 크기 조정 및 회전할 수 있습니다.
사각형 내의 화살표는 텍스트의 읽기 방향을 가리켜야 합니다. -
‘글꼴 설정’ 영역에서 다음 옵션을 구성하십시오:
- 글꼴 종류
- 문자 집합
- 거절 클래스
-
클릭 다음.
의 2단계 OCR 기본 대화 상자가 열립니다.
자세한 내용은 다음을 참조하십시오. 2단계: 캐릭터 크기.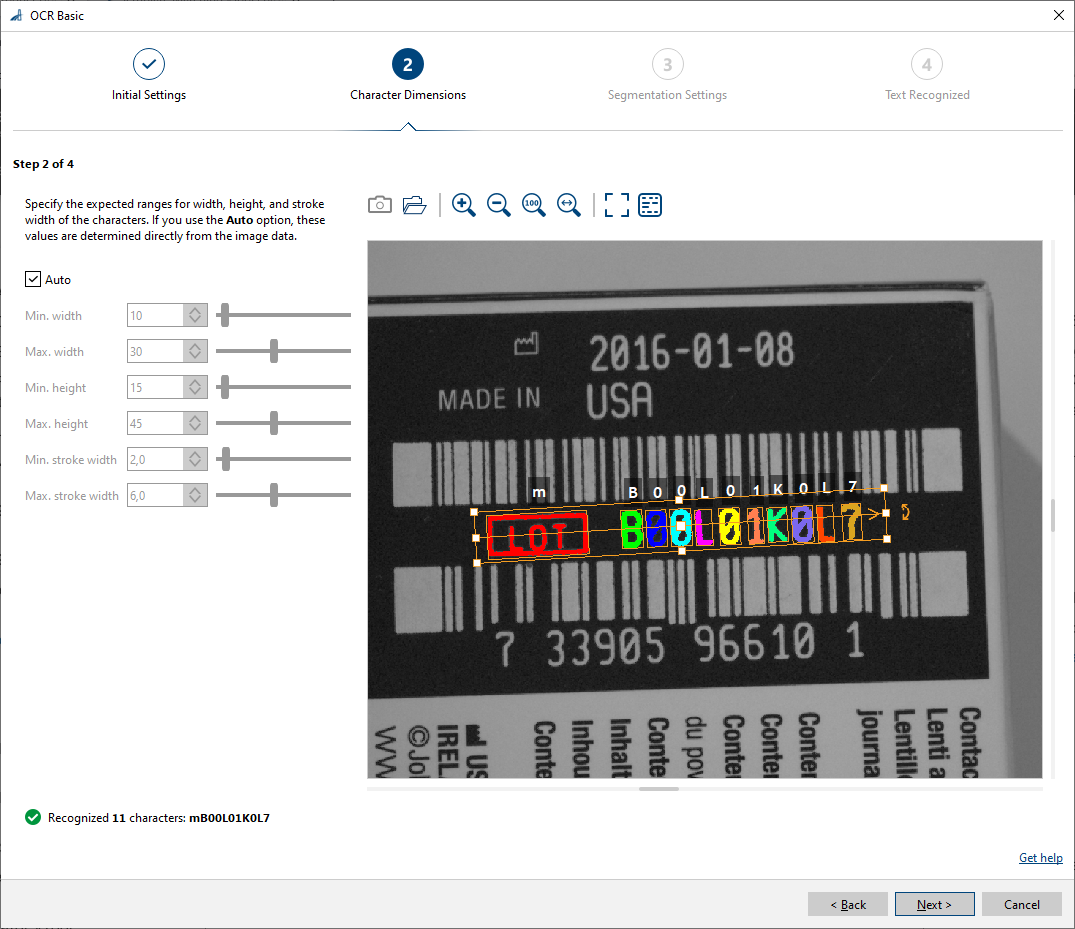
-
문자 크기를 감지하는 기본 자동 모드를 계속 사용할지 여부를 결정하십시오. 크기를 수동으로 지정하려면 ‘자동’ 옵션을 선택 해제하고, 문자 너비, 높이 및 획 두께에 대한 원하는 범위를 입력하십시오.
-
클릭 다음.
의 3단계 OCR 기본 대화 상자가 열립니다.
자세한 내용은 다음을 참조하십시오. 3단계: 세분화 설정.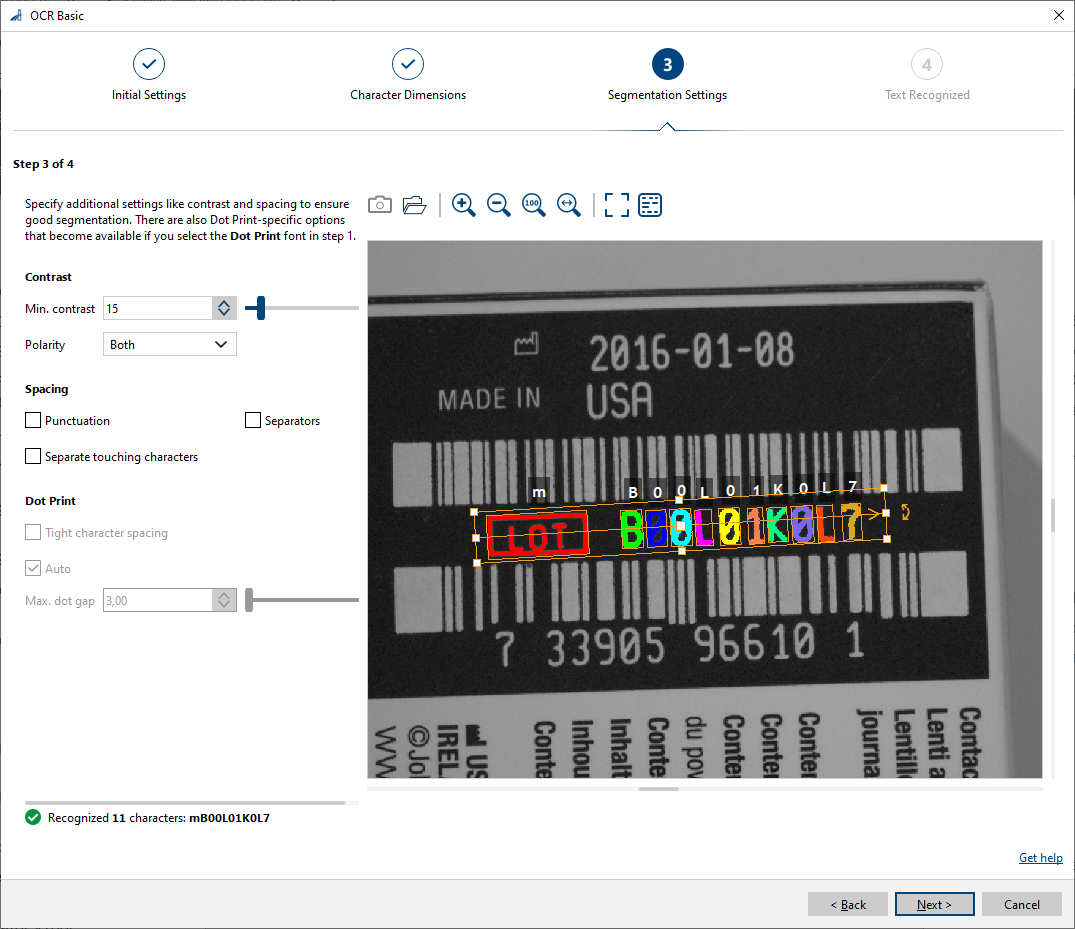
-
사용 용도에 따라 명암비와 극성을 조정하십시오.
-
사용 목적에 따라 간격 옵션을 선택하십시오.
-
Dot Print 글꼴을 선택한 경우, 필요에 따라 옵션을 지정하십시오.
-
클릭 다음.
의 4단계 OCR 기본 대화 상자가 열립니다.
자세한 내용은 다음을 참조하십시오. 4단계: 결과.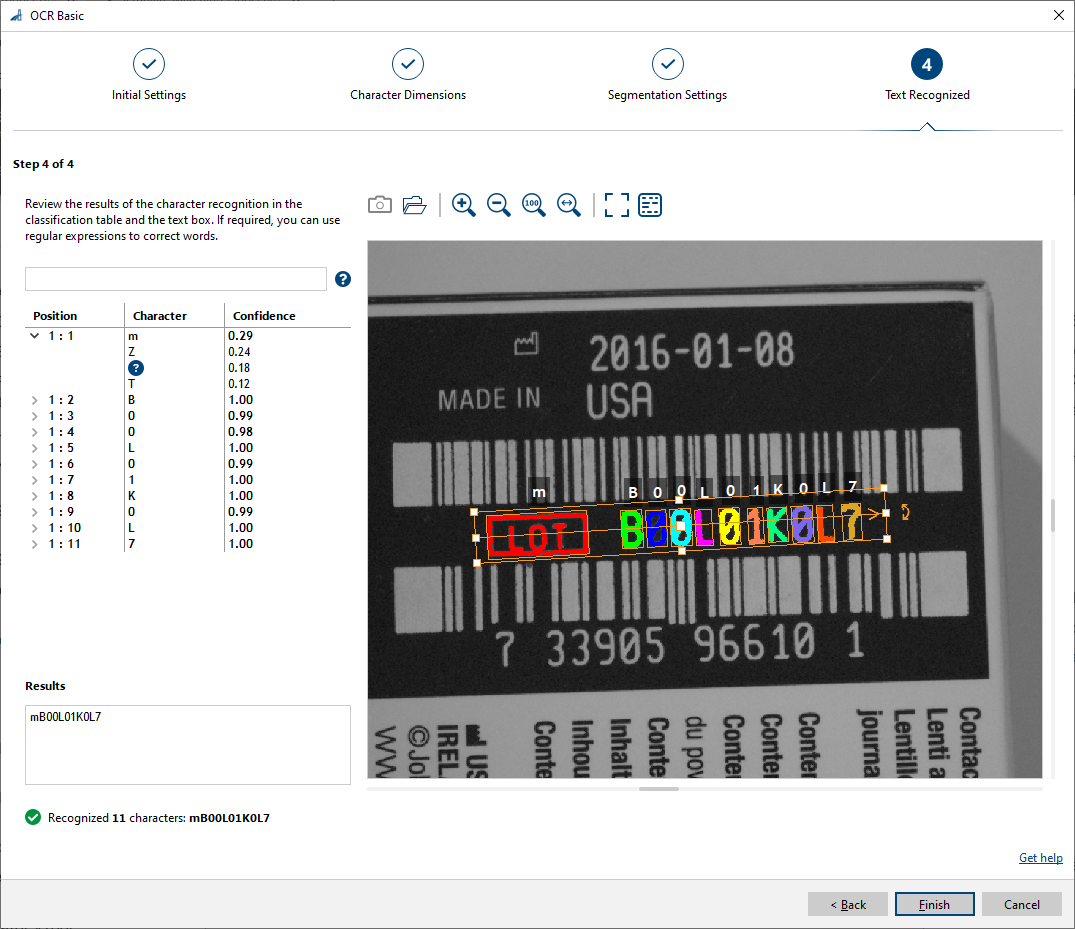
-
분류 테이블과 텍스트 필드에서 문자 인식 결과를 확인하십시오.
테이블에서 각 위치를 확장하면 대체 분류 결과를 볼 수 있습니다. 분류된 문자와 해당 신뢰도 값을 확인할 수 있습니다.
세부 보기 옵션이 활성화되어 있는 경우, 테이블에서 문자를 선택하면 미리보기 영역에서 해당 문자의 경계 상자가 강조 표시됩니다. 반대로, 미리보기 영역에서 문자 영역을 클릭하면 테이블에서 해당 문자를 확인할 수 있습니다. -
필요한 경우, 단어 수정을 수행할 정규식을 입력하십시오.
단어 하나당 하나의 정규식을 입력하십시오. 정규식 사이에는 공백 하나를 넣어 구분하십시오. -
‘인식된 텍스트’ 필드에 표시된 단어를 확인하십시오.
-
'마침'을 클릭하여 설치 과정을 완료하십시오.
OCR Basic vTool의 결과는 핀 데이터 보기에서 확인할 수 있습니다. 여기에서 표시할 출력 항목을 선택할 수 있습니다.
Inputs#
Image#
Camera vTool 또는 이미지를 출력하는 vTool(예: Image Format Converter vTool)로부터 직접 이미지를 수신합니다.
- Data type: Image
- 이미지 형식: 8비트~16비트 흑백 또는 컬러 이미지. 컬러 이미지는 내부적으로 흑백 이미지로 변환됩니다.
Outputs#
Texts#
인식된 텍스트 문자열을 반환합니다.
- 데이터 유형: String Array
Regions#
인식된 텍스트의 영역을 반환합니다.
- Data type: Region Array