pylon AI Platform#
각 AI vTool에 적합한 다양한 머신 비전 프로젝트를 제공하며, 사용자가 직접 프로젝트를 생성할 수도 있습니다. 개발부터 배포에 이르는 모델 라이프사이클 관리의 모든 단계를 지원하며, 다양한 하드웨어 환경에 최적화된 모델 최적화 기능도 포함되어 있습니다.
pylon AI Platform에 대한 액세스 권한을 얻으려면 Basler Sales에 문의하세요.
작동 원리#
소개로서, 다음 섹션에서는 pylon AI Platform을 이용한 프로젝트 생성에 대한 배경 정보와 주요 측면을 설명합니다.
개념 및 용어#
모델: 모델은 샘플 이미지를 사용하여 학습할 수 있는 알고리즘입니다. 학습을 기반으로 모델은 이미지 콘텐츠를 "예측"할 수 있게 됩니다.
아키텍처: 모델의 아키텍처는 모델의 작동 방식을 결정합니다. 다양한 머신 비전 작업에 따라 다양한 아키텍처를 사용할 수 있습니다.
데이터 세트: 데이터 세트는 특정 문제나 작업과 관련된 데이터의 모음입니다. 문제와 관련된 모든 시각적 속성이 포함됩니다.
예를 들어, 고양이와 개를 구분하는 분류 모델의 경우 고양이와 개 이미지로 데이터 세트를 구성할 수 있습니다. 모델이 고양이와 개뿐만 아니라 생쥐까지 구별해야 하는 경우, 생쥐 이미지 데이터를 데이터 세트에 추가해야 합니다.
일반적으로 데이터 세트는 세 부분으로 나뉩니다:
- 학습 데이터: 학습 데이터는 딥러닝 모델이 학습을 위해 사용하는 데이터 세트 중 가장 큰 부분을 차지합니다. 모델은 학습 데이터 내의 패턴을 인식하도록 가중치를 조정합니다.
- 검증 데이터: 검증 데이터는 DL 모델이 학습 과정에서의 성능을 평가하는 데 사용됩니다. 학습 데이터와는 독립적으로 유지되며 최적화에는 사용되지 않습니다.
- 테스트 데이터: 학습이 완료된 후, 테스트 데이터를 사용하여 모델의 성능을 평가합니다. 테스트 데이터는 새롭고 한 번도 보지 못한 예제를 나타내며 모델이 실제 데이터에 얼마나 잘 일반화되는지 보여줍니다.
pylon Viewer의 Recording 기능을 사용하여 자신만의 데이터 세트를 생성할 수 있습니다. 데이터 세트를 완성하려면 이미지 주석(Annotation)도 추가해야 합니다. 자세한 내용은 아래의 Annotations/Labels 섹션을 참조하세요. 데이터 세트가 완료되면 pylon AI Platform의 프로젝트에 추가할 수 있습니다.
현재 데이터 세트는 CVAT for images 형식의 버전 1.1만 지원됩니다. CVAT Server를 사용하여 데이터를 주석 처리하거나 기존 데이터 세트를 CVAT for images 1.1 형식으로 변환할 수 있습니다.
후자의 경우, 학습 환경에서 데이터 세트를 CVAT 형식으로 내보내거나 서드파티 도구를 사용하여 기존 데이터 세트를 변환하십시오. 이를 위해 Basler에서는 Datumaro 사용을 권장합니다.
Annotations/Labels: 레이블이라고도 하는 Annotation은 데이터 세트에 추가되어 모델에 데이터에서 중요한 부분이 무엇인지 알려줍니다. 학습 중에 모델은 이 정보를 사용하여 예측 결과와 예상/정답을 비교합니다. 위에서 언급한 분류 작업의 경우, 이 정보는 이미지가 개를 나타내는지 고양이를 나타내는지 나타냅니다.
pylon AI에서 사용할 이미지를 Annotation하려면 외부 학습 플랫폼을 사용하거나 오픈소스 도구인 CVAT를 사용할 수 있습니다. 이 동영상에서는 CVAT를 사용하여 Object Detection용 바운딩 박스로 이미지를 Annotation하는 방법을 보여줍니다.
Training: 딥러닝 맥락에서 Training은 신경망(모델)이 학습 데이터로부터 학습하는 프로세스입니다. 모델은 모든 학습 데이터에 대한 예측을 수행합니다(위의 "Data sets" 참조). 편차를 계산하기 위해 예측 결과와 정답 데이터(Annotation/Label)를 비교합니다. 편차를 바탕으로 편차가 최소화되도록 모델의 가중치가 조정됩니다. 이 프로세스는 오차가 최대한 줄어들 때까지 반복됩니다. 모델이 잘 작동하는지 확인하기 위해 검증 데이터에 모델을 적용합니다.
Inference: 딥러닝 맥락에서 Inference는 학습된 모델을 새롭고 이전에 보지 못한 데이터에 적용하여 콘텐츠에 대한 예측을 수행하는 것을 의미합니다.
pylon AI Platform 사용#
이 섹션에서는 머신 비전 프로젝트를 생성하는 다양한 단계에 대해 설명합니다.
pylon AI Platform은 직관적으로 사용할 수 있도록 설계되었습니다. pylon AI Platform에 로그인하면 Dashboard 뷰가 표시됩니다.
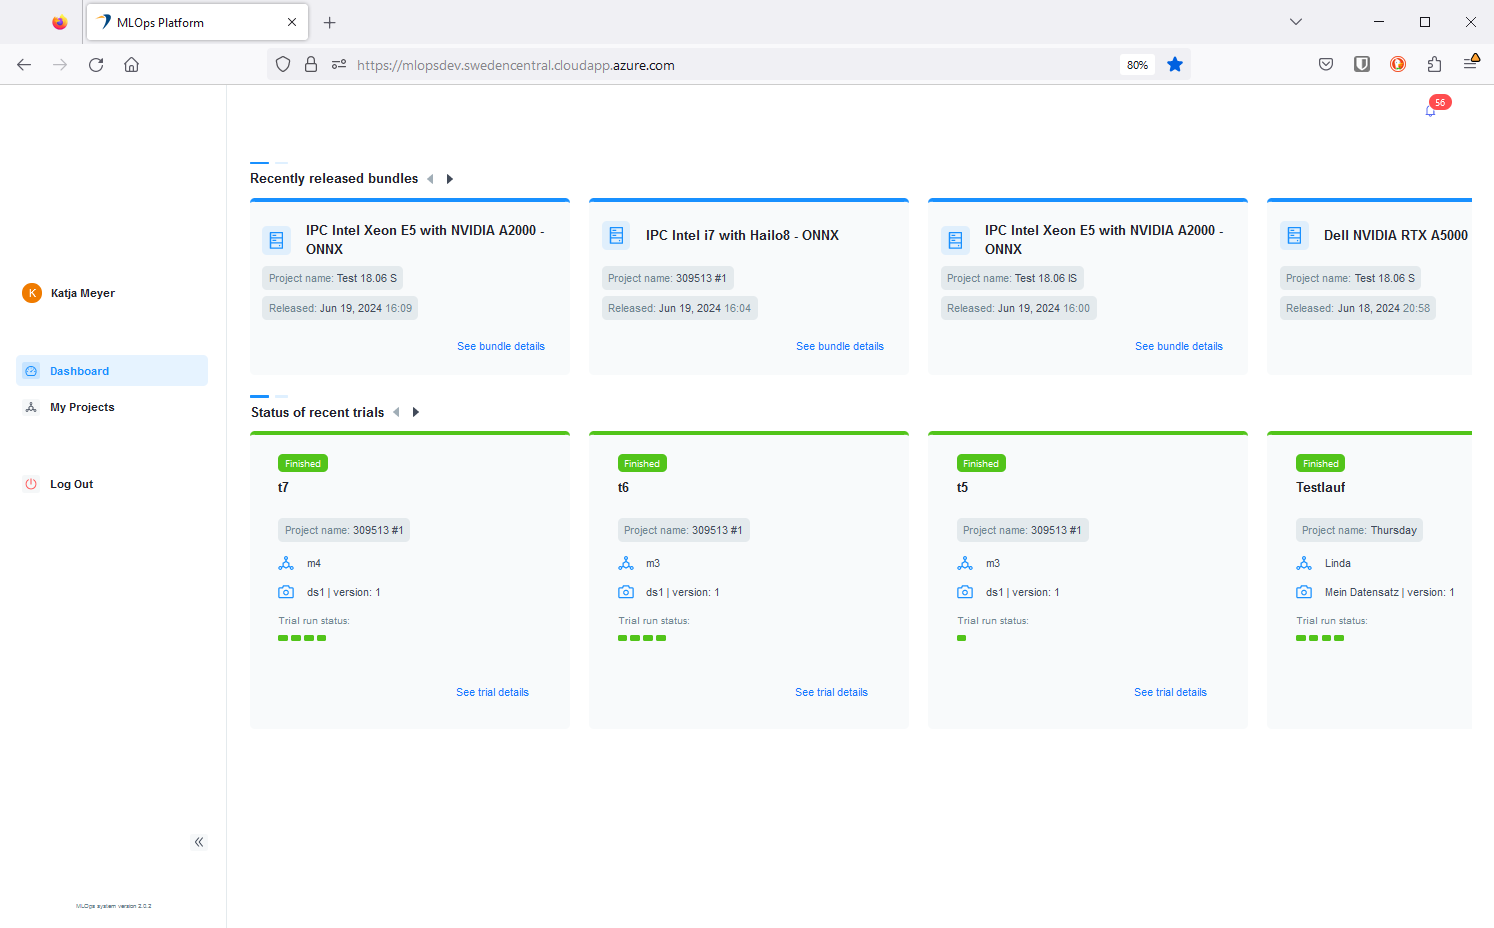
여기에는 가장 최근에 출시된 5개의 번들과 가장 최근에 실행된 5개의 평가판이 표시됩니다.
프로젝트 생성을 시작하려면 왼쪽에 있는 탐색 트리의 My Projects를 클릭하세요.
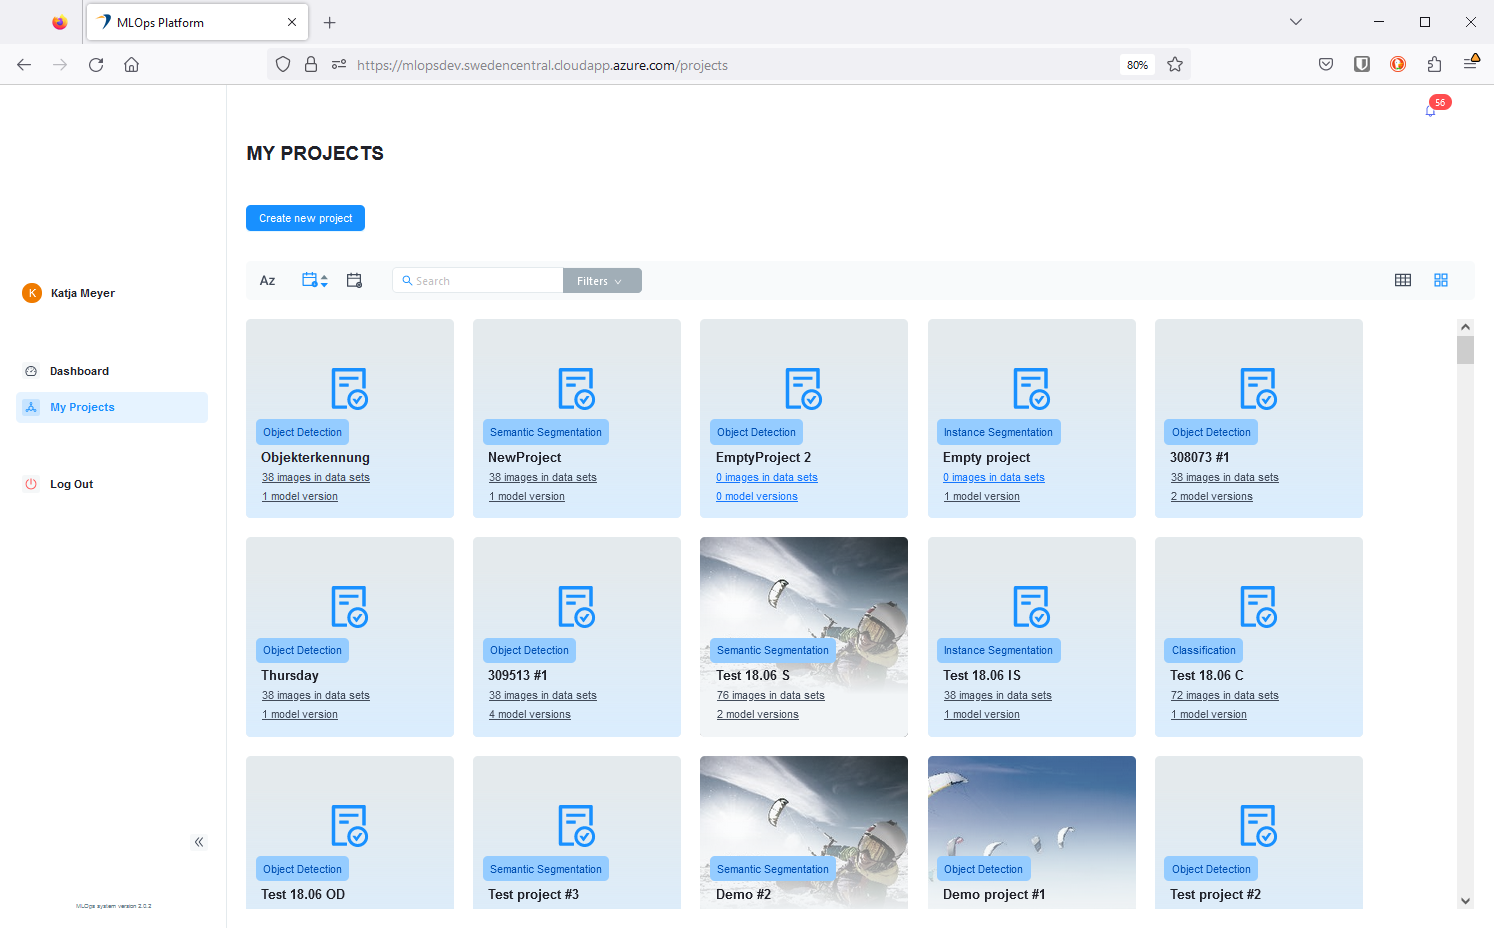
My Projects 뷰에서는 귀하 또는 AI Platform에 액세스할 수 있는 다른 사용자가 생성한 모든 프로젝트를 볼 수 있습니다. 프로젝트를 목록 뷰 또는 타일 뷰로 표시하도록 선택할 수 있습니다.
프로젝트 생성#
프로젝트를 생성하는 것부터 시작합니다.
- pylon AI Platform에 로그인합니다.
- 왼쪽에 있는 탐색 트리의 My Projects를 클릭하세요.
- My Projects 페이지에서 Create new project를 클릭합니다.
- Create New Project 페이지에서 생성하려는 프로젝트 유형을 지정하고 이름과 간단한 설명(선택 사항)을 입력합니다.
프로젝트 개요 페이지가 열립니다.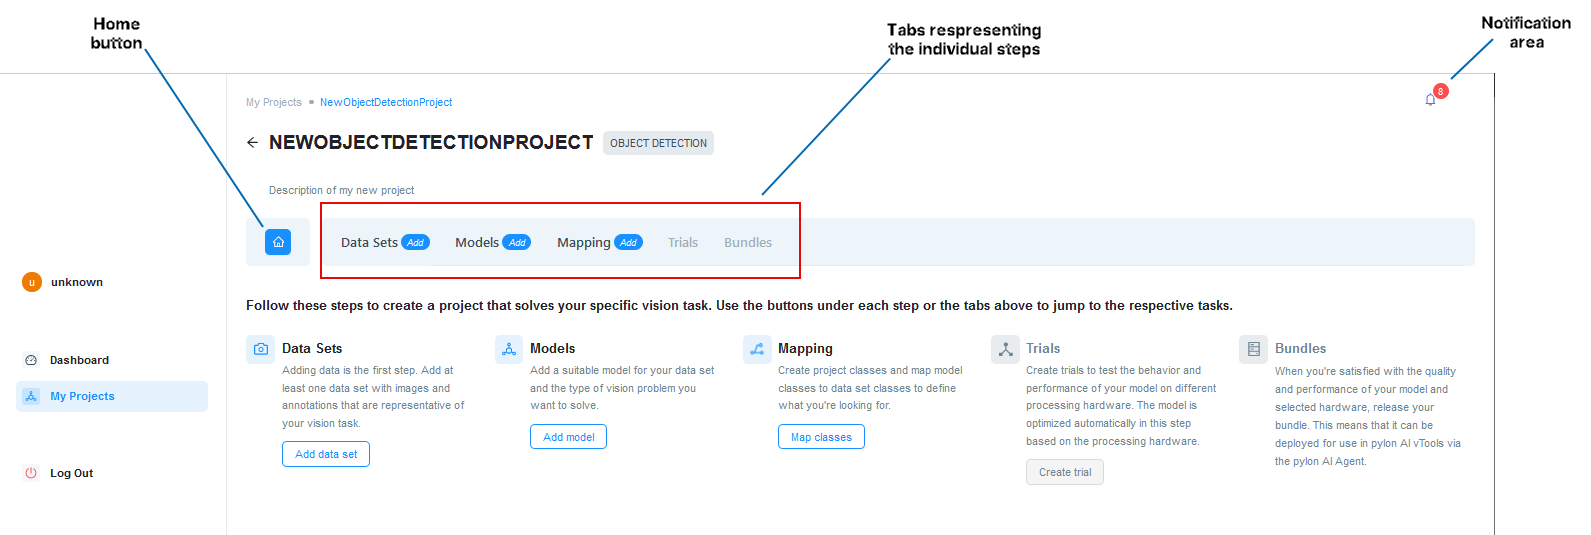
상단의 탭 탐색 영역에는 현재 수행할 수 있는 모든 단계가 표시됩니다. 일부 단계는 이전 단계를 완료한 후에만 활성화됩니다.
알림 영역에서는 AI Platform에서 수행하는 모든 작업에 대해 새 메시지가 팝업으로 표시됩니다. 모든 메시지는 사용자가 삭제할 때까지 저장됩니다.
홈 버튼을 누르면 프로젝트의 개요 페이지로 돌아갑니다.
데이터 세트#
-
Add data set 버튼을 클릭하거나 상단의 탭 목록에서 Data Sets를 클릭하세요.
-
Add Data Set 페이지에서 추가하려는 데이터 세트의 이름과 간단한 설명(선택 사항)을 입력합니다.
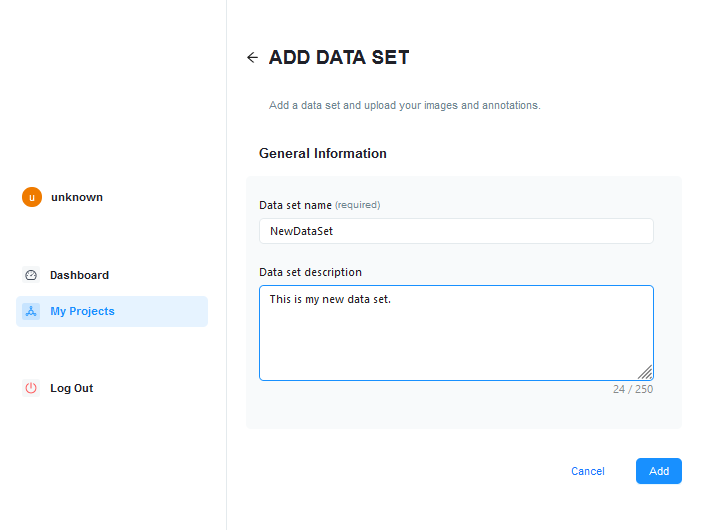
-
Add를 클릭합니다.
-
Upload Data 페이지에서 업로드할 데이터의 형식을 지정하고 데이터를 추가합니다.
현재 데이터 세트는 CVAT for images 형식의 버전 1.1만 지원됩니다. CVAT Server를 사용하여 데이터를 주석 처리하거나 기존 데이터 세트를 CVAT for images 1.1 형식으로 변환할 수 있습니다.
후자의 경우, 학습 환경에서 데이터 세트를 CVAT 형식으로 내보내거나 서드파티 도구를 사용하여 기존 데이터 세트를 변환하십시오. 이를 위해 Basler에서는 Datumaro 사용을 권장합니다.
데이터 검증이 즉시 시작됩니다. 검증이 성공적으로 완료되면 어노테이션을 확인하고 데이터 세트 클래스 생성을 계속 진행할 수 있습니다.
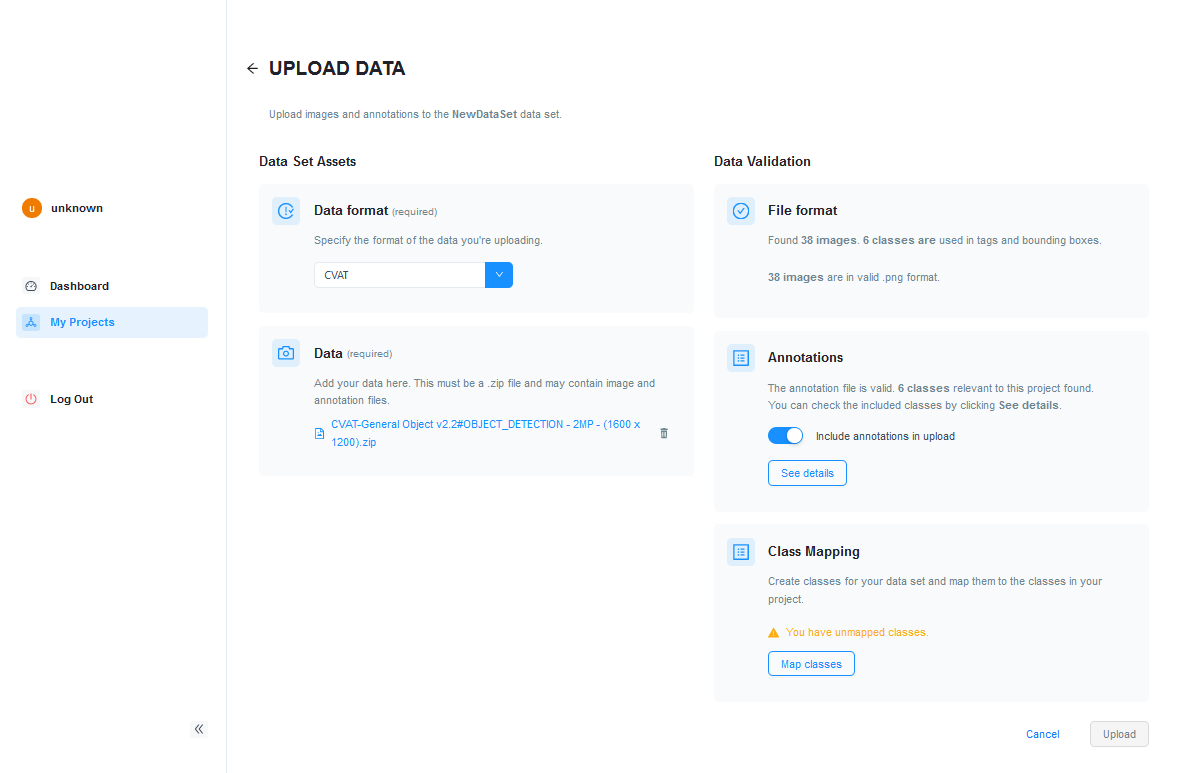
-
Map classes를 클릭합니다.
-
다음에서 Class Mapping 대화 상자에서 다음을 클릭합니다. Autocreate classes 이미지의 어노테이션을 기반으로 데이터 세트 클래스를 자동으로 생성합니다.
또는 다음을 클릭합니다. Add new class 다음에 있는 드롭다운 목록에서 Data Set Class.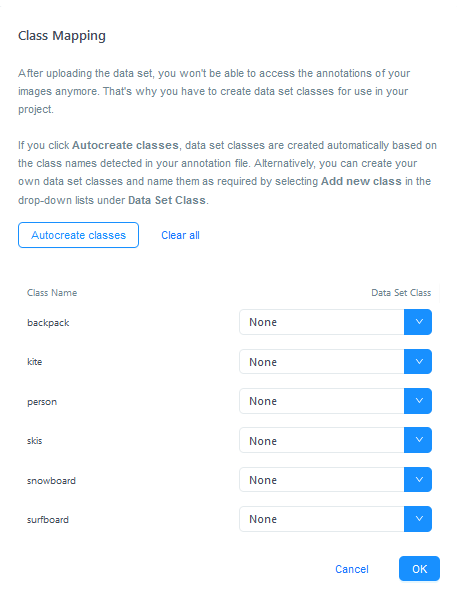
-
OK를 클릭합니다.
-
Upload Data 페이지에서 Upload를 클릭합니다.
데이터 세트를 확인할 수 있는 Data Sets 탭이 열립니다. -
데이터 세트를 클릭하여 콘텐츠를 확인하고, 이미지를 추가하고, Property를 편집합니다. 데이터 세트 상태가 만족스러우면 다음을 클릭합니다. Publish.
트라이얼에서 사용하려면 데이터 세트를 게시(Publish)해야 합니다.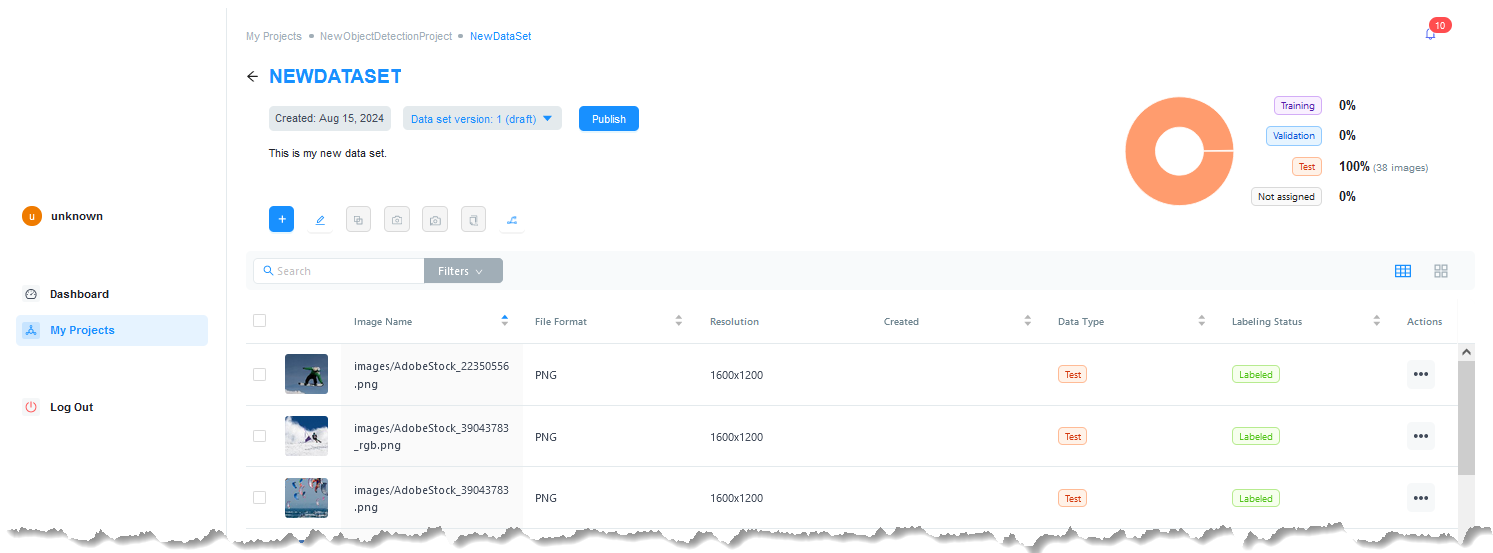
-
Data Sets 탭으로 돌아갑니다.
모델#
-
Models 탭을 클릭합니다.
-
Models 페이지에서 Add model을 클릭합니다.
-
Upload Model 페이지에서 추가하려는 모델의 이름과 간단한 설명(선택 사항)을 입력합니다.
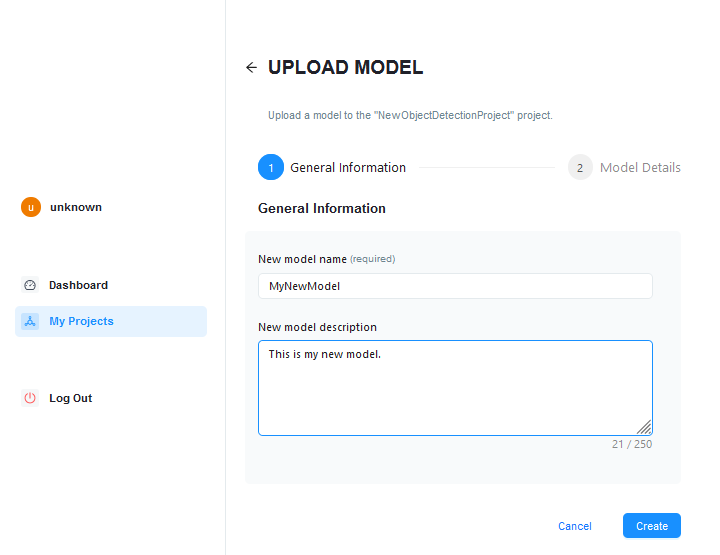
-
Create를 클릭합니다.
-
Upload Model 페이지에서 업로드하려는 모델의 구성을 지정하고 모델 파일을 추가합니다.
업로드 및 유효성 검사가 즉시 시작됩니다. 완료되면 모델에 포함된 클래스를 확인할 수 있습니다.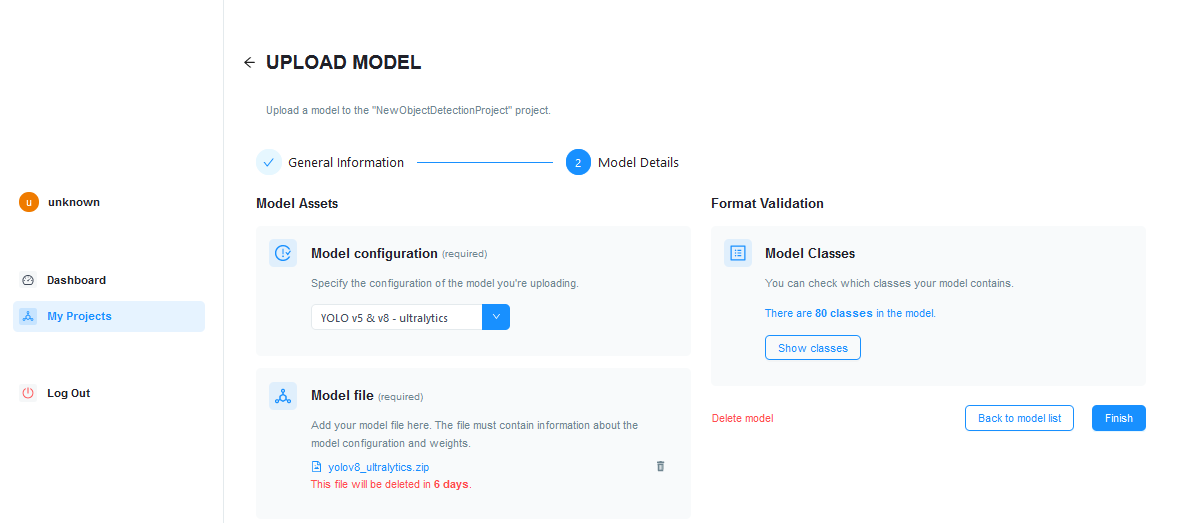
-
Finish를 클릭합니다.
모델을 확인할 수 있는 Models 탭이 열립니다. -
해당 모델을 클릭하여 속성을 확인합니다.
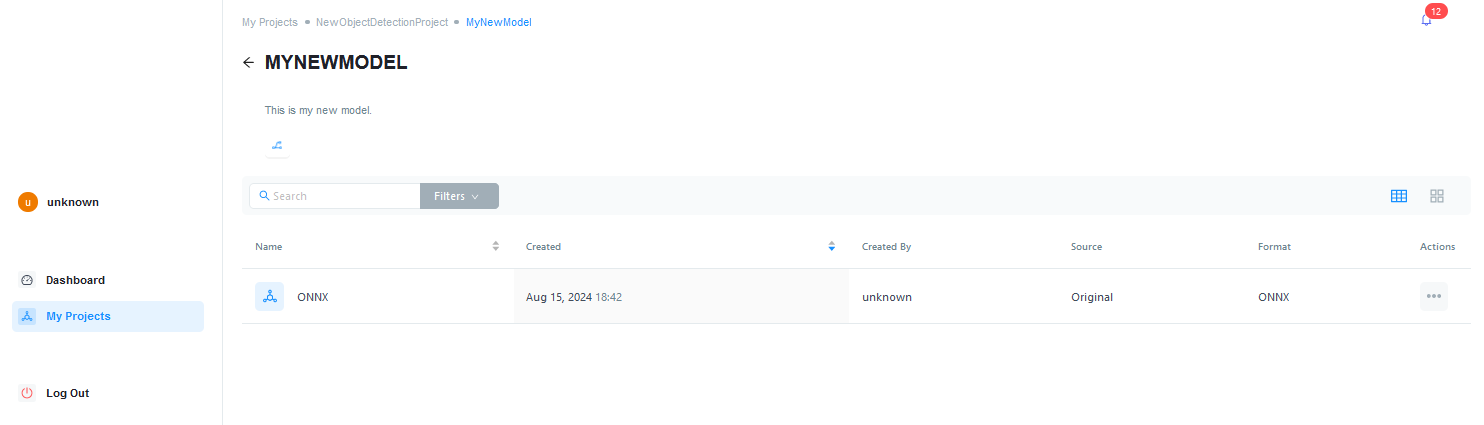
-
Models 탭으로 돌아갑니다.
매핑#
데이터 세트와 모델에는 일반적으로 특정 작업에 필요한 것보다 더 많은 클래스가 포함되어 있습니다. 매핑은 데이터 세트 클래스를 모델 클래스에 일치시켜 프로젝트에서 찾고자 하는 항목을 정의하는 프로세스입니다. 이를 위해 프로젝트 클래스를 추가하고 원하는 데이터 세트 및 모델 클래스를 할당해야 합니다.
-
다음 항목을 클릭합니다. 매핑 탭.
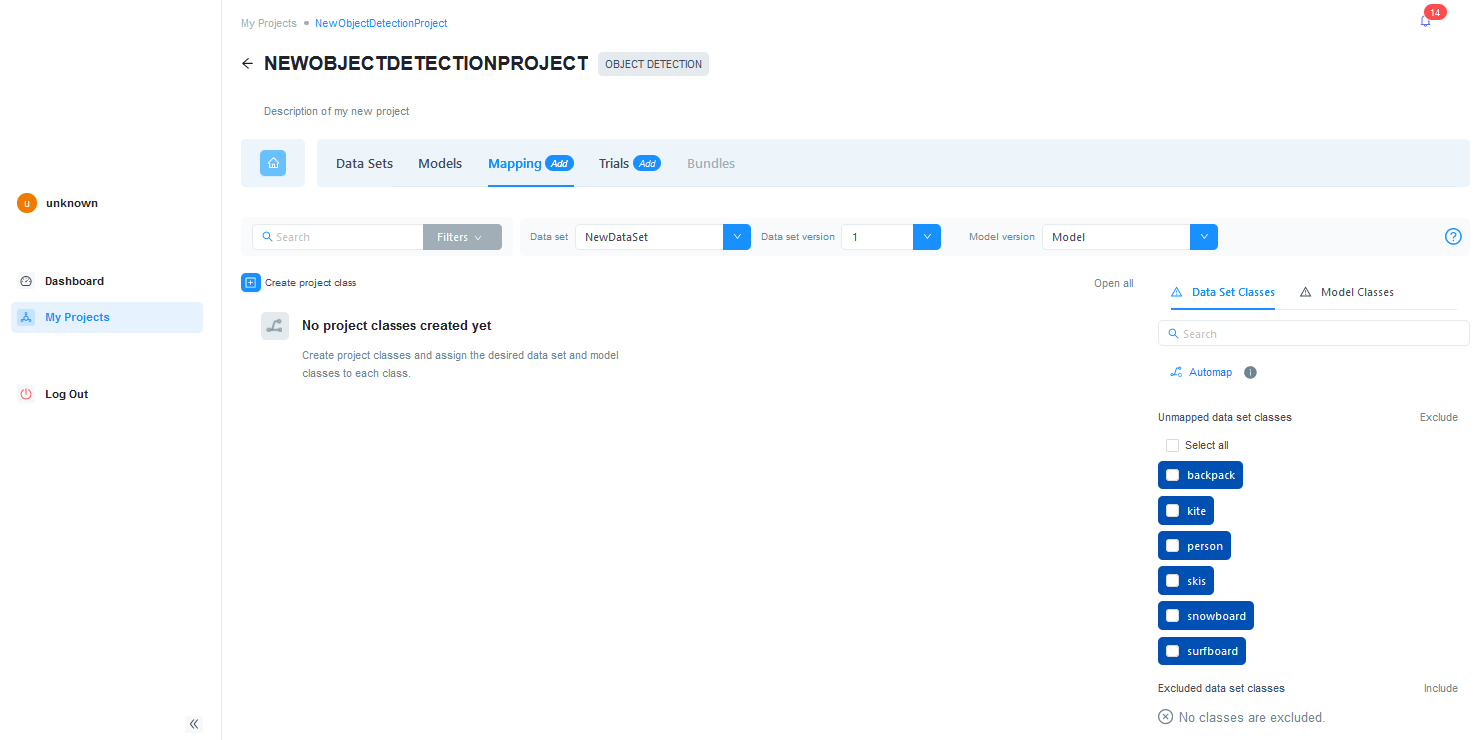
-
매핑 탭에서 다음을 클릭합니다. Create project class 첫 번째 프로젝트 클래스를 생성합니다.
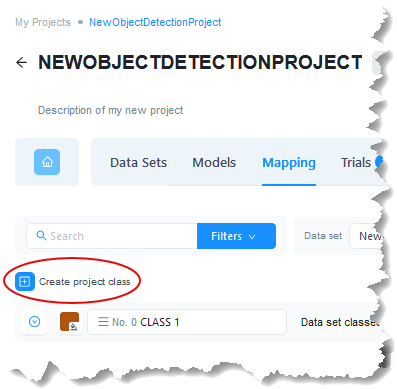
또는 다음을 사용할 수 있습니다. Automap feature.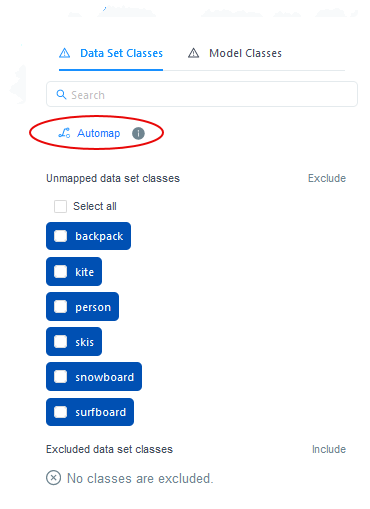
-
필요한 경우 기본 이름을 다른 이름으로 변경합니다.
-
데이터 세트 클래스와 모델 클래스를 추가합니다.
오른쪽에 있는 해당 탭에서 클래스를 간편하게 끌어서 놓을 수 있습니다. 드롭다운 목록을 사용하여 데이터 세트나 해당 버전 및 모델 버전을 변경할 수 있습니다.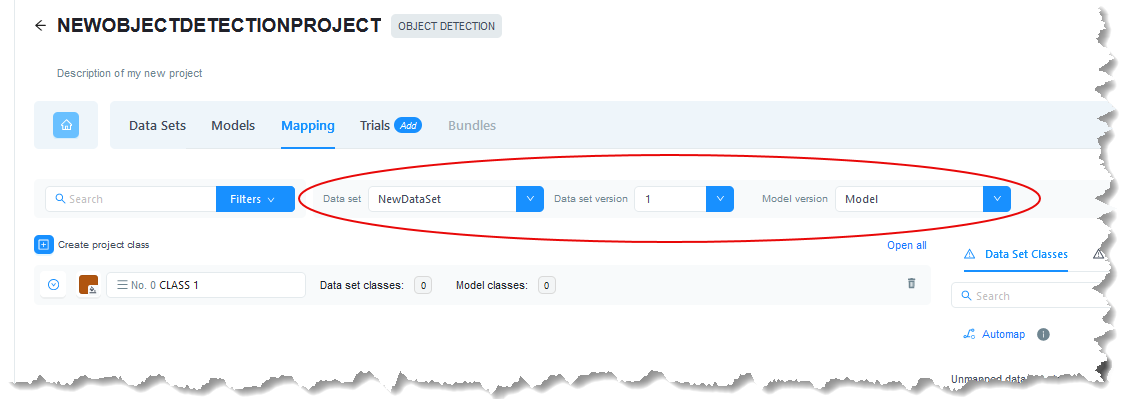
-
필요한 모든 프로젝트 클래스를 생성할 때까지 2~4단계를 반복합니다.
-
필요 없는 모든 데이터 세트 및 모델 클래스를 제외합니다(자세한 내용은 Excluding Classes 참조).
자동 매핑#
자동 매핑을 사용하면 클릭 한 번으로 이름을 기준으로 데이터 세트 및 모델 클래스를 프로젝트 클래스에 매핑할 수 있습니다. 데이터 세트 및 모델 클래스 이름과 일치하는 프로젝트 클래스가 없으면 해당 이름으로 새 프로젝트 클래스가 생성됩니다. 따라서 사용하려는 것보다 더 많은 데이터 세트 클래스나 모델 클래스가 있는 경우 자동 매핑을 사용하기 전에 반드시 제외해야 합니다.
자동 매핑은 매핑되지 않은 클래스에만 작동합니다. 이전에 수동으로 매핑된 클래스는 해당 상태로 유지됩니다.
데이터 세트 또는 프로젝트 클래스의 이름에 "background" 또는 "excluded"라는 단어가 포함된 경우, 프로젝트 유형에 따라 제외되거나 배경으로 정의됩니다.
자동 매핑은 대소문자를 구분하지 않지만 클래스 이름은 정확히 일치해야 합니다.
자동 매핑 사용 방법:
-
오른쪽의 Data Set Classes 탭에서 필요 없는 모든 데이터 세트 클래스를 제외합니다.
-
클릭 Automap.
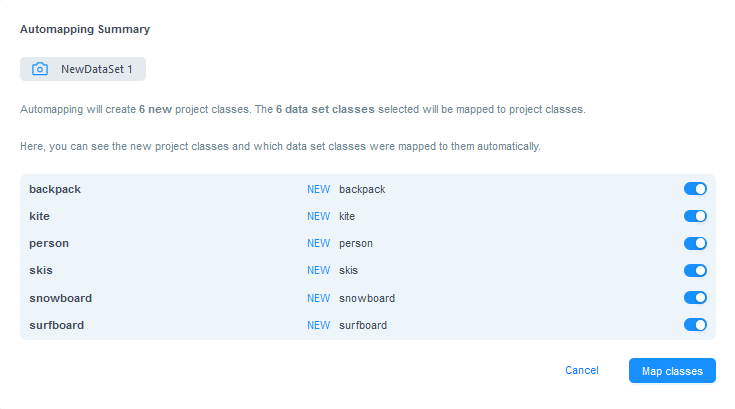
-
Automapping Summary 대화 상자에서 나열된 모든 프로젝트 클래스를 생성할 것인지 확인합니다.
원하지 않는 클래스는 선택 해제할 수 있습니다. 선택 해제된 클래스는 매핑되지 않은 상태로 유지됩니다. 나중에 반드시 제외 처리해 주세요. -
Map classes를 클릭합니다.
프로젝트 클래스가 생성되고 데이터 세트 클래스가 해당 클래스에 추가됩니다. -
오른쪽의 Model Classes 탭에서 필요 없는 모든 모델 클래스를 제외합니다.
-
클릭 Automap.
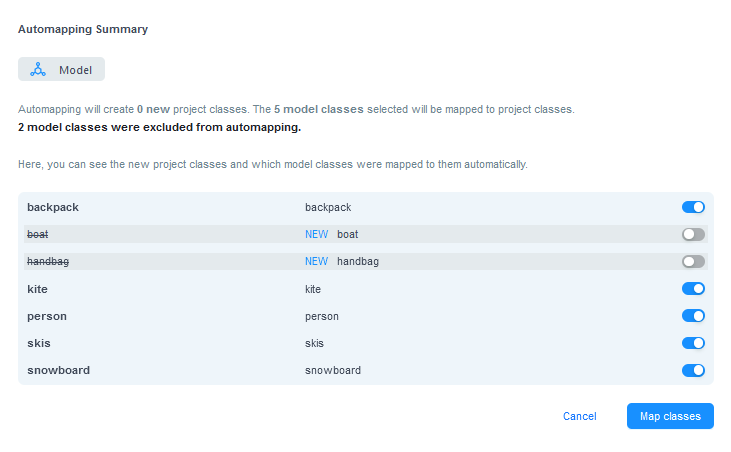
-
Automapping Summary 대화 상자에는 기존 프로젝트 클래스, 이들에 매핑될 모델 클래스, 그리고 새로 생성될 프로젝트 클래스가 표시됩니다. 새로 생성되는 것으로 나열된 프로젝트 클래스를 생성할 것인지 확인합니다.
원하지 않는 클래스는 선택 해제할 수 있습니다. 선택 해제된 클래스는 매핑되지 않은 상태로 유지됩니다. 나중에 반드시 제외 처리해 주세요. -
Map classes를 클릭합니다.
아직 존재하지 않는 프로젝트 클래스가 생성됩니다. 신규 및 기존 프로젝트 클래스에 모델 클래스가 추가됩니다.
클래스 제외#
프로젝트에서 사용하지 않을 모델 클래스는 매핑을 완료하기 위해 제외해야 합니다. 이는 모델로부터 올바른 통계 데이터를 얻기 위해 필요합니다.
클래스를 제외하려면 필요하지 않은 모든 모델 클래스를 선택하고 Exclude를 클릭합니다. 또는 선택한 클래스를 화면 하단으로 드래그하여 Excluded 섹션에 놓을 수도 있습니다.
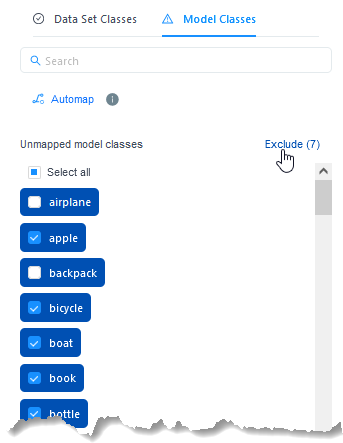
세분화 프로젝트의 경우 이 과정이 약간 다릅니다. 여기서는 불필요한 모든 모델 클래스를 배경으로 정의해야 합니다. 이렇게 하려면 필요하지 않은 모든 모델 클래스를 선택하고 Define as background를 클릭합니다. 또는 선택한 클래스를 화면 하단으로 드래그하여 Background 섹션에 놓을 수도 있습니다.
이 두 작업 모두 해당 버튼을 사용하거나 드래그앤드롭하여 취소할 수 있습니다.
제외된 클래스는 프로젝트 적용 시 고려되지 않습니다. 즉, 해당 클래스에 대한 결과는 얻을 수 없습니다.
시행#
-
Trials 탭을 클릭합니다.
-
Trials 페이지에서 Add trial을 클릭합니다.
-
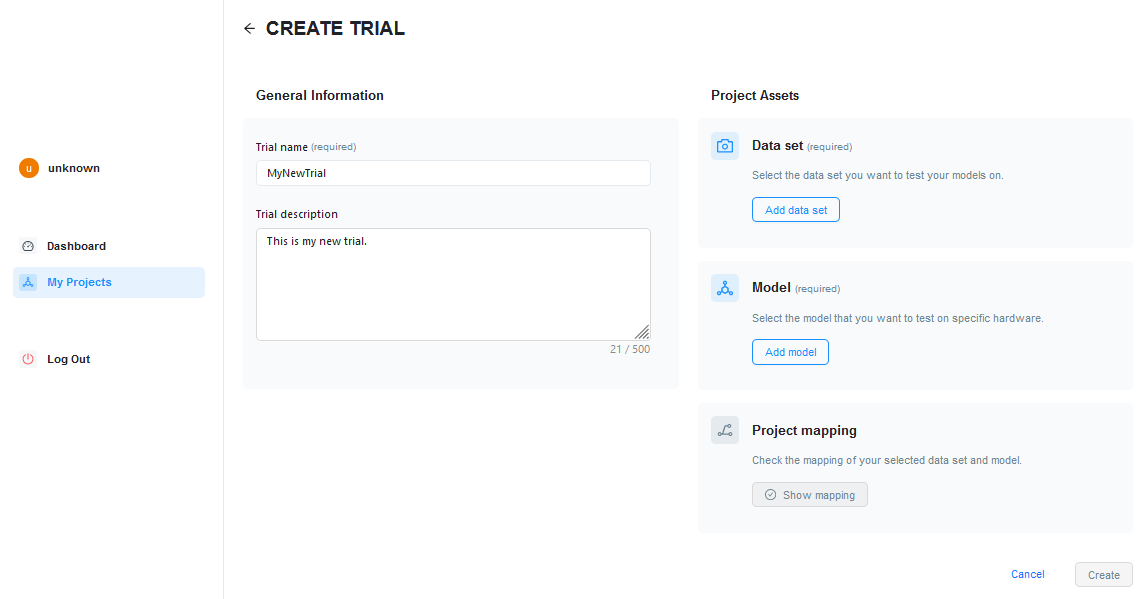
트라이얼 생성 페이지에서 추가하려는 트라이얼의 이름과 간단한 설명(선택 사항)을 입력합니다.
-
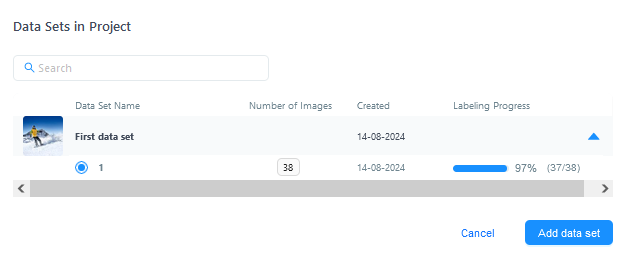
다음에서 프로젝트 자산 영역에서 다음을 클릭합니다. 데이터 세트 추가 테스트에 사용할 데이터 세트를 선택합니다.
-
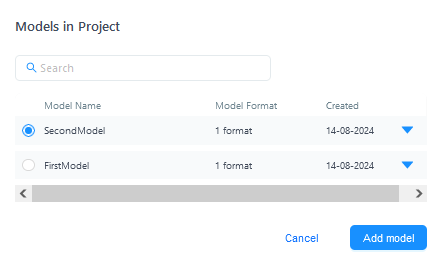
다음에서 프로젝트 자산 영역에서 다음을 클릭합니다. 모델 추가 테스트에 사용할 모델을 선택합니다.
-
다음에서 프로젝트 자산 영역에서 다음을 클릭합니다. 매핑 확인.
매핑을 확인하고 필요한 변경 사항을 적용해야 합니다. 트라이얼을 생성한 후에는 프로젝트 클래스를 더 이상 변경할 수 없습니다.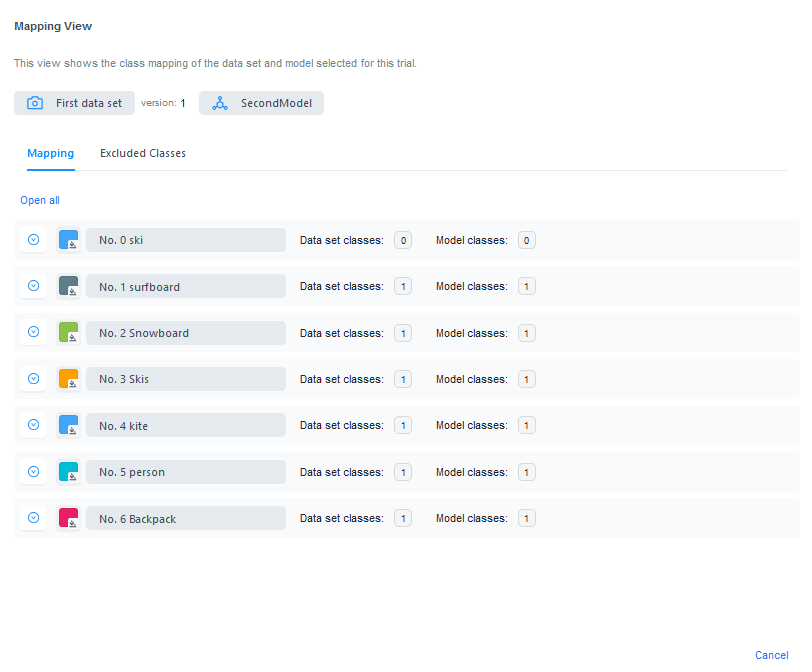
-
Create를 클릭합니다.
-
Add next trial run을 클릭합니다.
-
하드웨어 및 모델 형식을 선택합니다.
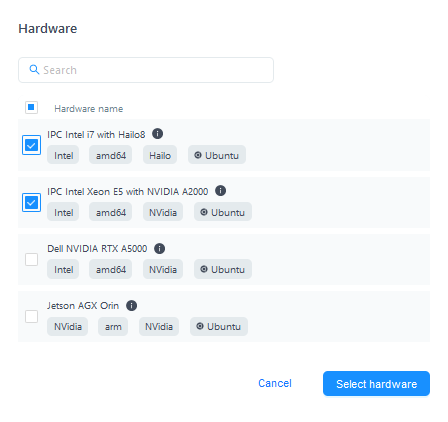
-
클릭 트라이얼 실행.
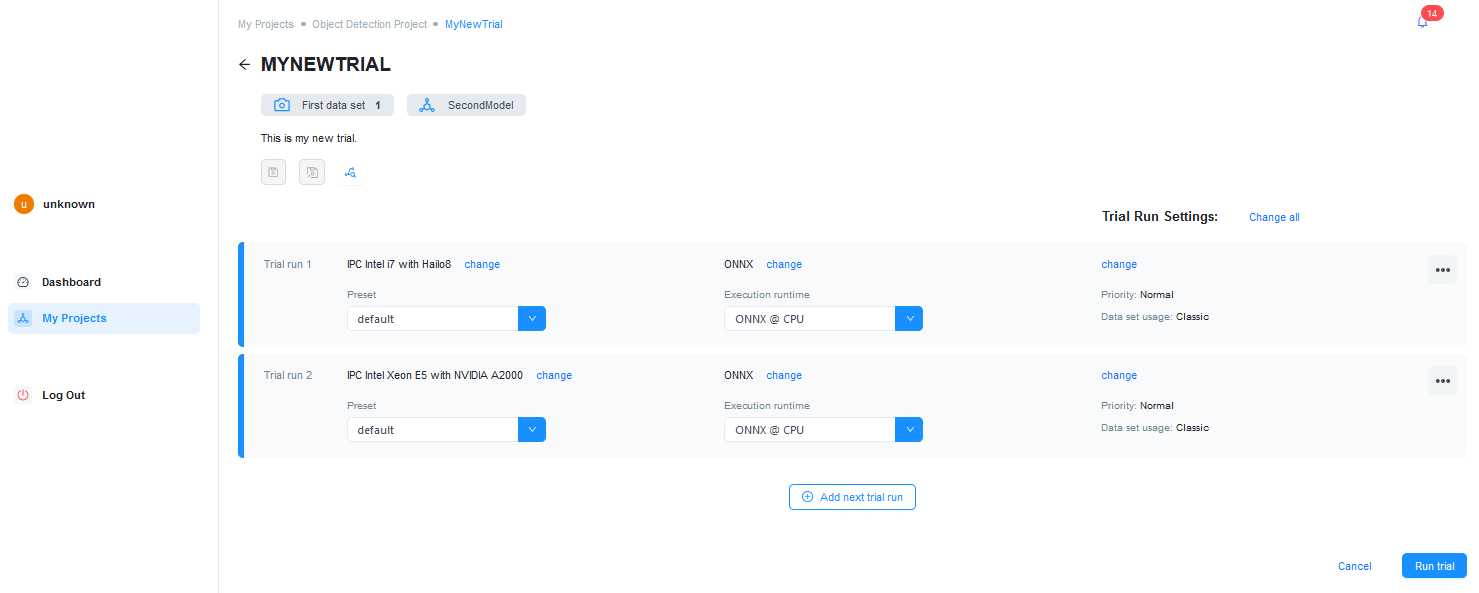
트라이얼 실행이 즉시 시작됩니다. 실행이 완료되면 트라이얼 페이지에 통계가 표시됩니다.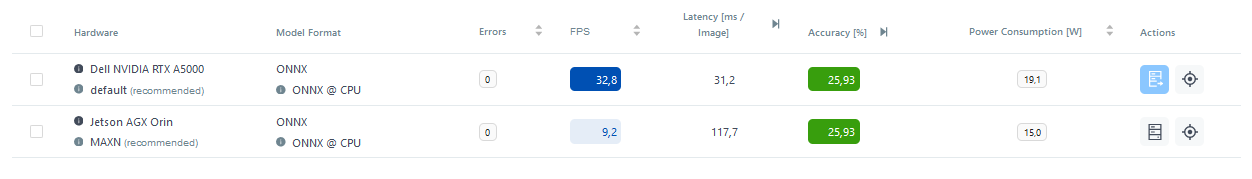
-
결과가 만족스러우면 트라이얼 옆에 있는 번들 릴리스 버튼을 클릭하여 번들을 릴리스할 수 있습니다.

-
번들의 이름을 변경하고 설명(선택 사항)을 입력합니다.
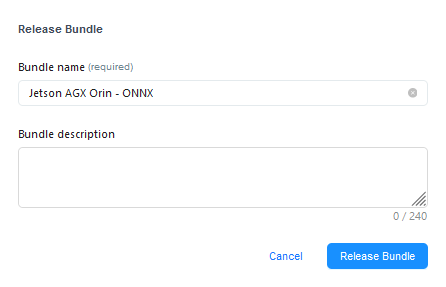
-
Release bundle을 클릭합니다.
번들이 생성됩니다. -
프로젝트 개요 페이지로 돌아가서 Bundles 탭을 클릭합니다.
잠시 후 여기에 번들이 나타납니다.
번들#
릴리스된 번들은 Bundles 탭에 표시됩니다. 여기에서 번들의 Property를 검사하고 번들이 생성된 트라이얼 실행의 세부 정보도 볼 수 있습니다.
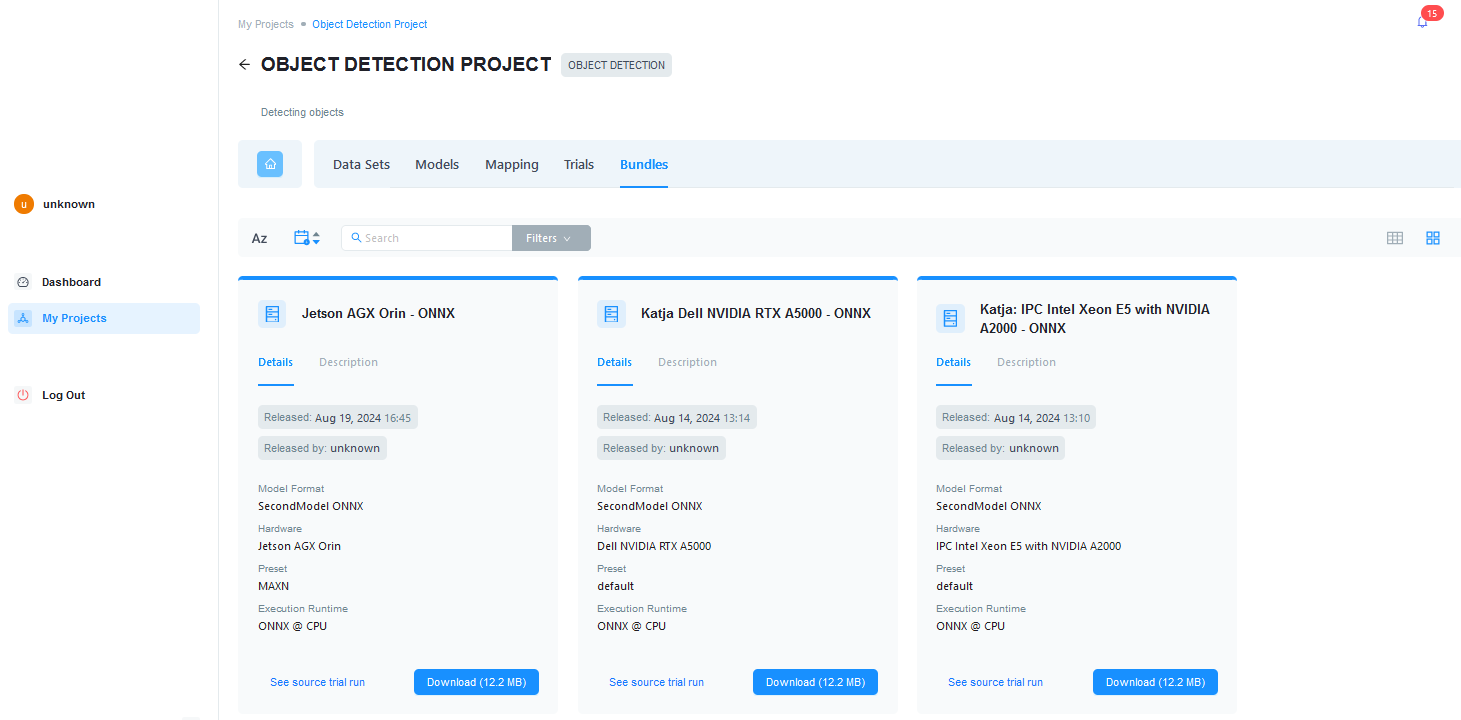
번들에는 vTool이 비전 작업을 수행하는 데 필요한 하드웨어 구성, 모델 등의 모든 필수 정보가 포함되어 있습니다. 이제 pylon AI Agent를 사용하여 AI vTools에 배포할 준비가 되었습니다.
번들을 로컬 또는 원격 저장소 위치에 다운로드할 수도 있습니다. 이 경우 pylon AI Platform에 대한 액세스 권한이 없는 사용자도 번들의 모델을 계속 사용할 수 있습니다.
외부 프로젝트#
pylon AI Platform을 사용하면 Intel Geti 및 Landing AI와 같은 다른 플랫폼에 연결할 수 있습니다. 해당 플랫폼에서 생성된 프로젝트를 가져와서 다양한 하드웨어와 모델로 테스트를 실행할 수 있습니다.
다른 플랫폼에 연결을 설정하려면 해당 플랫폼의 API 키를 추가해야 합니다.
API 키를 추가하려면:
- pylon AI Platform에 로그인합니다.
- 왼쪽 탐색 트리에서 다음을 클릭합니다. Settings.
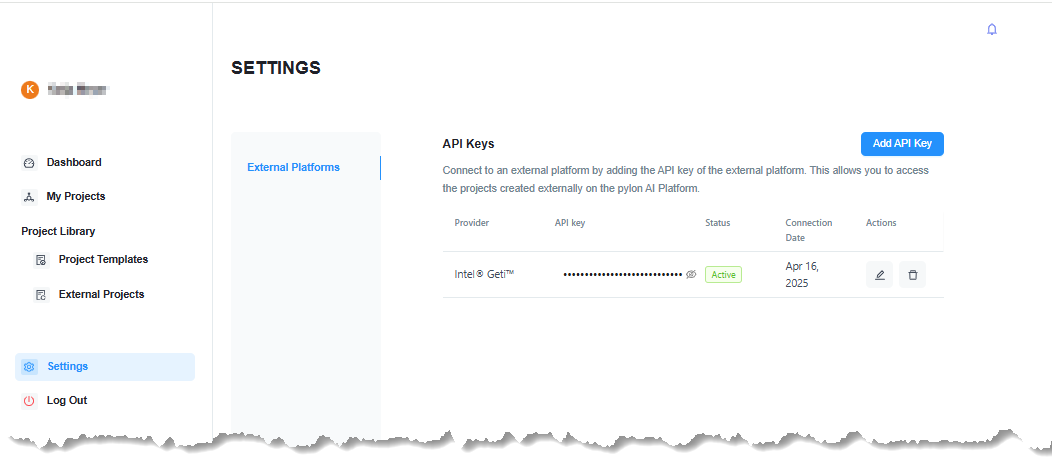
- 다음에서 Settings 뷰에서 다음을 클릭합니다. Add API Key.
이 Add API Key 대화 상자가 열립니다.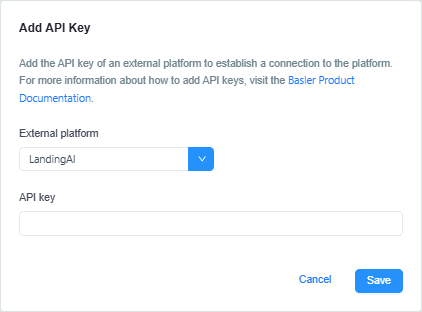
- Add API Key 대화 상자에서 원하는 플랫폼을 선택하고 해당 플랫폼의 API 키를 입력합니다.
API 키를 얻는 방법에 대한 지침은 여기에서 확인할 수 있습니다.
Intel Geti
Landing AI - Save를 클릭합니다.
추가한 API 키가 API Keys 페이지에 표시됩니다. 또한 연결을 설정한 외부 플랫폼에서 생성된 프로젝트를 이제 External Projects 뷰에서 사용할 수 있습니다.
이제 외부 프로젝트를 프로젝트 라이브러리로 가져와서 테스트할 수 있습니다. 외부 프로젝트는 읽기 전용입니다. pylon AI Platform에서는 데이터 세트 등의 리소스를 편집할 수 없습니다. 변경하려면 원래 플랫폼에서 수행해야 합니다.
외부 프로젝트를 가져오려면:
- 왼쪽 탐색 트리에서 다음을 클릭합니다. 외부 프로젝트.
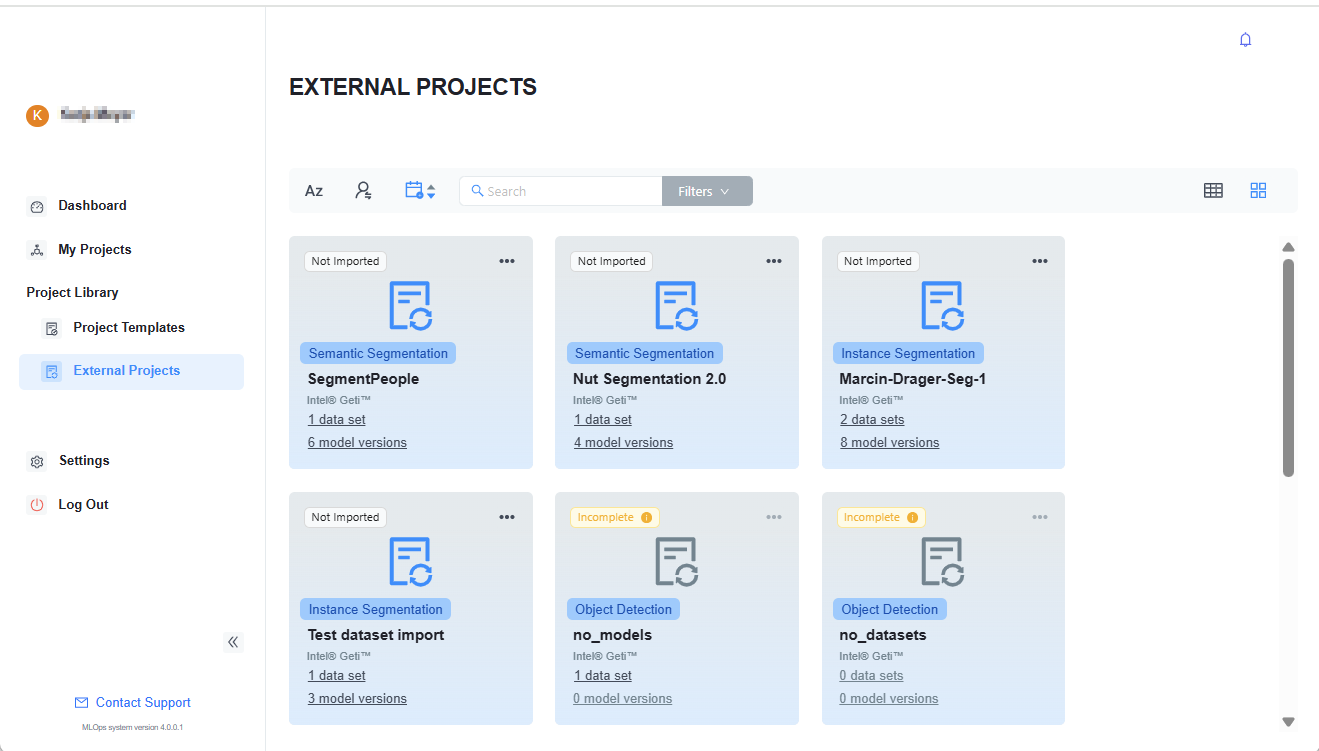
- 가져올 프로젝트를 클릭합니다.
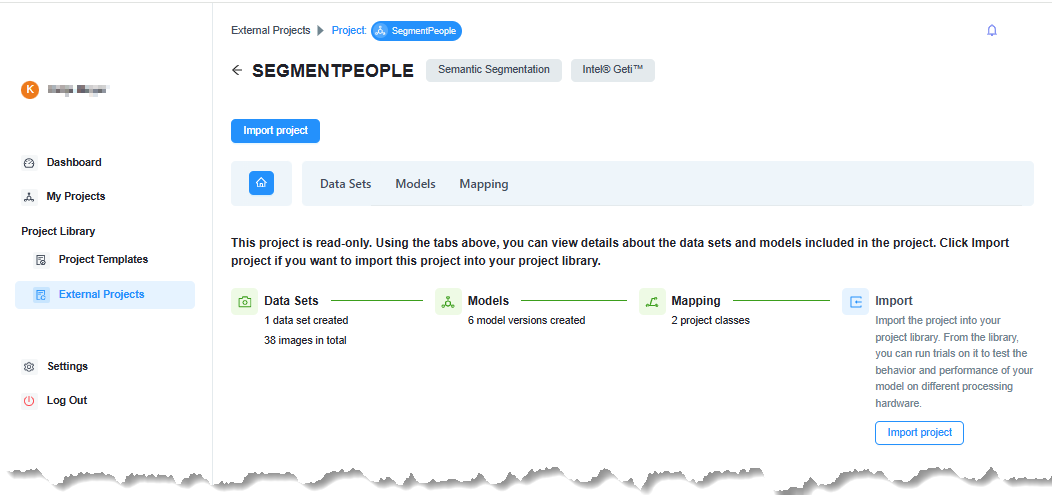
- Data Sets, Models, Mapping 탭에서 프로젝트의 리소스를 검토합니다.
- 프로젝트가 마음에 들면 다음을 클릭합니다. Import project.
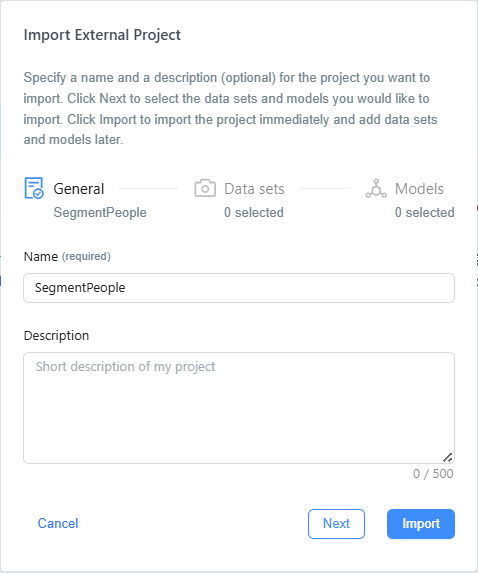
- 이름과 간단한 설명(선택 사항)을 입력합니다.
- Next를 클릭합니다.
- 가져올 데이터 세트를 선택합니다.
나중에 수행할 수도 있습니다. 외부 프로젝트의 일부인 데이터 세트만 가져올 수 있습니다. - Next를 클릭합니다.
- 가져올 모델을 선택합니다.
나중에 수행할 수도 있습니다. 외부 프로젝트의 일부인 모델만 가져올 수 있습니다. - Import를 클릭합니다.
프로젝트가 가져와지며 프로젝트 라이브러리에 추가됩니다. - 왼쪽 탐색 트리에서 다음을 클릭합니다. My Projects.
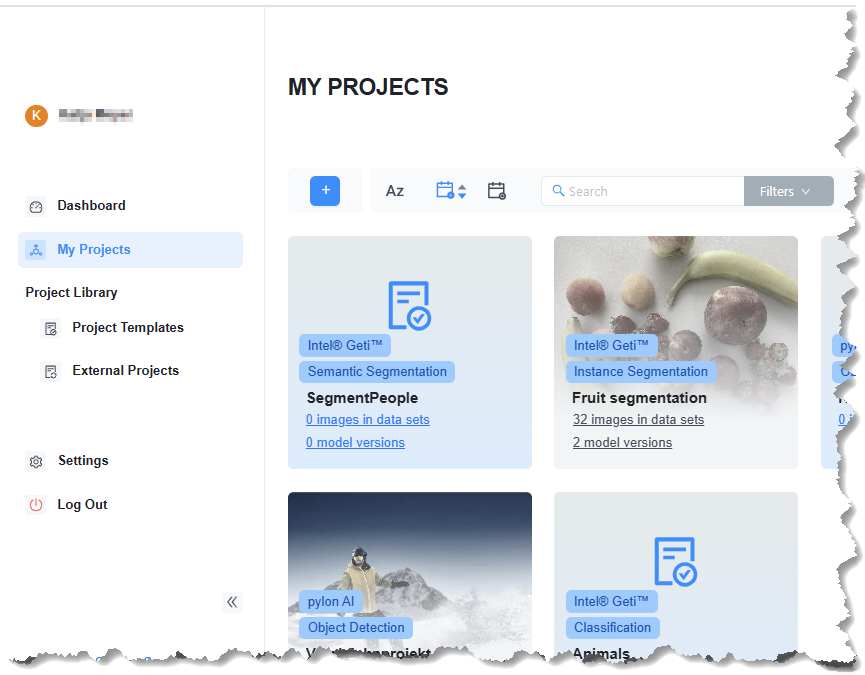
방금 추가한 프로젝트를 사용할 수 있습니다. - 프로젝트를 클릭하여 편집합니다. 예를 들어, 아직 완료하지 않았다면 데이터 세트와 모델을 추가하고 매핑을 확인할 수 있습니다.
- trials를 실행하고 bundles를 생성합니다.