Free-Form OCR vTool#
단어와 텍스트 세그먼트가 나타나는 위치를 미리 알 필요 없이 이를 찾아냅니다. 즉, 애플리케이션에서 필요에 따라 사용할 수 있는 최대한 많은 텍스트를 캡처할 수 있습니다. 텍스트가 고정된 패턴을 따르는 경우 대신 Pattern OCR vTool을 사용하세요.
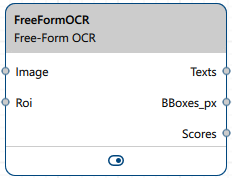
Free-Form OCR vTool은 Image 입력 핀을 통해 수신한 이미지의 텍스트를 읽고 검증합니다. 결과는 Texts, BBoxes_px, Scores 출력 핀을 통해 출력됩니다.
검출 전에 ROI Creator vTool을 사용하여 관심 영역을 지정하는 경우, Free-Form OCR vTool은 Roi 입력 핀을 통해 ROI 데이터를 수신합니다. 이 경우 관심 영역에 대해서만 검출이 수행됩니다. 그 부수적인 효과로 처리 속도가 빨라집니다.
Free-Form OCR vTool 라이선스를 구매하려면 Basler 웹사이트를 방문하세요. 또한 Basler 영업팀에 일반 모델을 요청해야 합니다.
작동 원리#
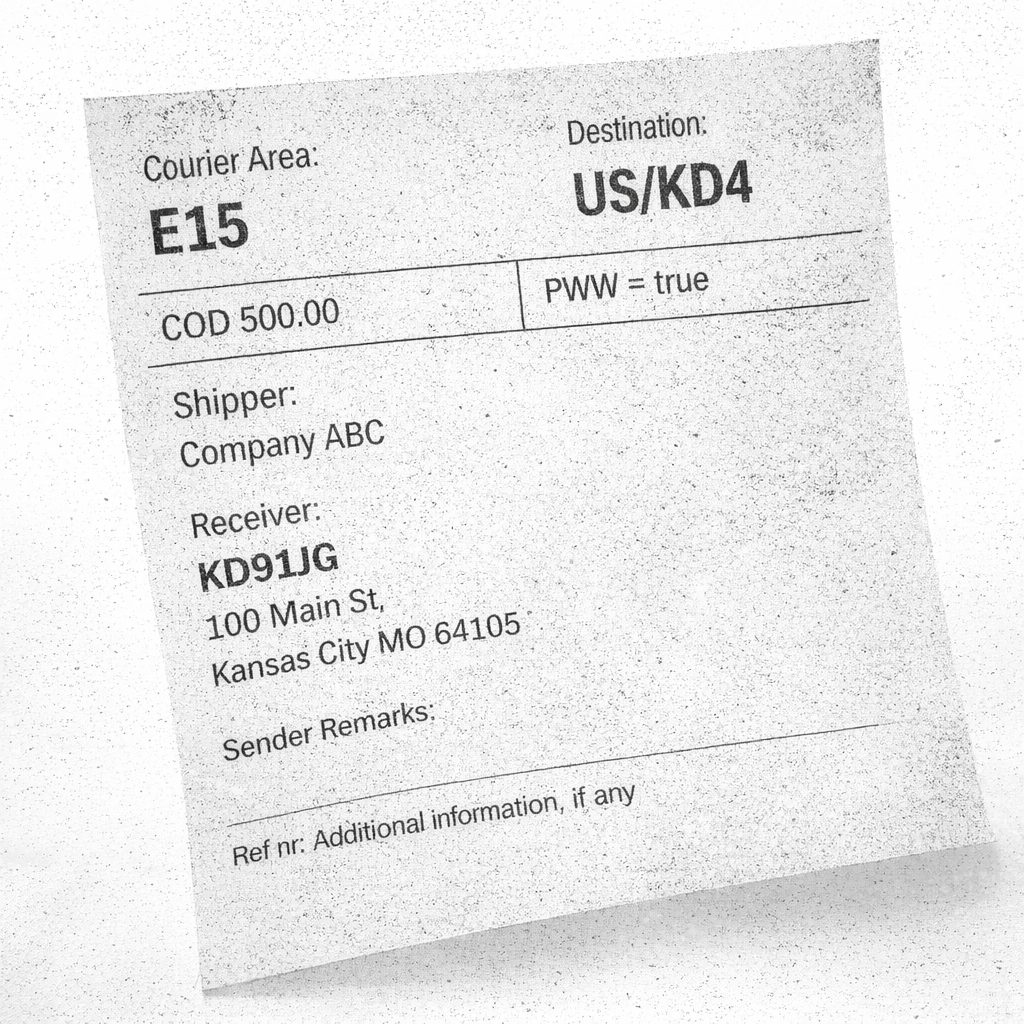
배송 라벨을 판독한다고 가정해 보겠습니다.
배송 라벨이 표시된 입력 이미지입니다.
배송 라벨 판독용으로 학습된 모델을 로드하여 vTool을 구성합니다.
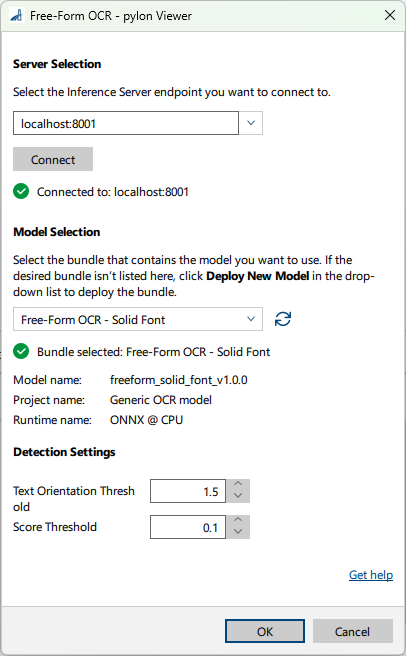
원하는 감지 설정 구성
vTool을 구성한 후, 추론 프로세스를 시작하는 레시피를 실행합니다. vTool은 모델을 사용하여 이미지를 분석하고 존재하는 단어와 텍스트 세그먼트를 읽습니다. 분석이 완료되면 OCR 결과가 반환됩니다.
결과를 보여주는 핀 데이터 뷰입니다:
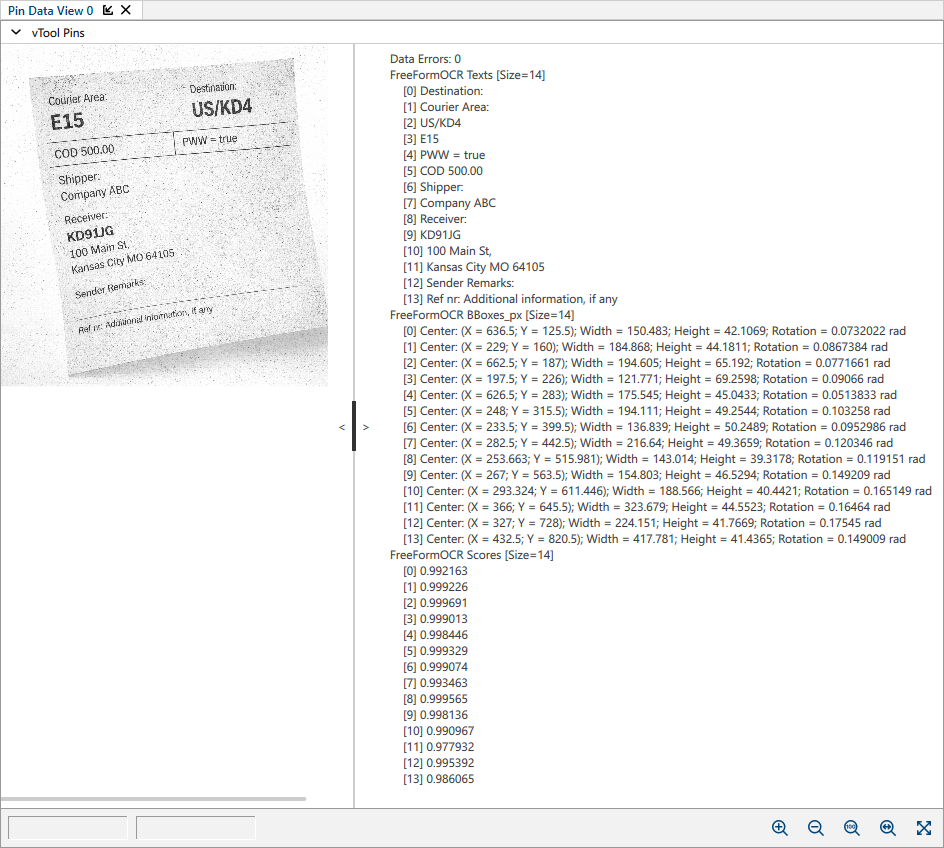
Image Formats#
모델에 따라 Image 입력 핀에서 컬러(BGR 8 Packed), 모노(Mono 8) 또는 컬러 및 모노 이미지 등 다양한 이미지 유형이 허용됩니다.
- 모델이 컬러 이미지를 요구하는 경우, 컬러 Pixel Format은 내부적으로 BGR 8 Packed로 변환됩니다. 모노 이미지는 허용되지 않습니다.
- 모델이 모노 이미지를 요구하는 경우, 모노 Pixel Format은 내부적으로 Mono 8로 변환됩니다. 컬러 이미지는 허용되지 않습니다.
- 모델이 모노와 컬러 이미지를 모두 지원하는 경우, 모노 입력은 Mono 8로 변환되어 모노로 전송되고, 컬러 입력은 BGR 8 Packed로 변환되어 컬러로 전송됩니다. vTool은 컬러를 모노로 또는 모노를 컬러로 변환하지 않습니다.
입력 Pixel Format이 지원되지 않는 경우, 먼저 Image Format Converter vTool을 사용하여 이미지를 변환하십시오. 컬러 입력의 경우 BGR 8 Packed를, 모노 입력의 경우 Mono 8을 선택하십시오.
Output Data Mapping#
Texts, BBoxes_px 및 Scores 결과는 인덱스가 정렬된 배열로 출력됩니다. 출력의 동일한 위치에 있는 요소는 동일한 텍스트 세그먼트를 참조합니다. 추가 vTool 정렬은 적용되지 않습니다.
모델 출력 순서나 세분화가 다른 경우, 출력 핀은 모델 출력 순서를 유지합니다.
예:
세 개의 요소가 있는 출력 데이터 배열, 즉 인식된 텍스트 세그먼트
Texts: ["AB", "12045", "XZ"]
Scores: [0.98, 0.95, 0.93]
BBoxes_px: [b0, b1, b2]
여기서 인덱스 0은 요소/텍스트 세그먼트 1에, 인덱스 1은 요소/텍스트 세그먼트 2에, 인덱스 2는 요소/텍스트 세그먼트 3에 매핑됩니다.
vTool 설정하기#
Free-Form OCR vTool을 설정하려면:
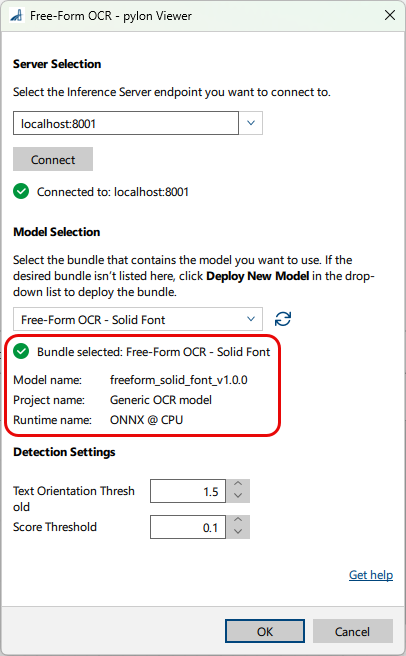
-
vTool Settings 영역의 Recipe Management 창에서 Open Settings를 클릭하거나 vTool을 더블 클릭합니다.
Free-Form OCR 대화 상자가 열립니다. -
Server Selection 영역에서 연결할 서버를 선택합니다.
연결하려면 서버가 실행 중이어야 합니다.- 옵션 1: Triton Inference Server의 IP 주소와 포트를 수동으로 입력합니다.
- 옵션 2: 드롭다운 목록에서 서버의 IP 주소/호스트 이름과 포트를 선택합니다.
-
Connect를 클릭하여 연결을 설정합니다.
그러면 vTool이 사용 가능한 모델을 로드합니다. -
다음에서 모델 선택 영역에서 드롭다운 목록의 원하는 모델이 포함된 번들을 선택합니다.
번들을 선택한 후, 드롭다운 목록 아래의 정보가 번들 세부 정보로 채워져 올바른 번들을 선택했는지 확인할 수 있습니다.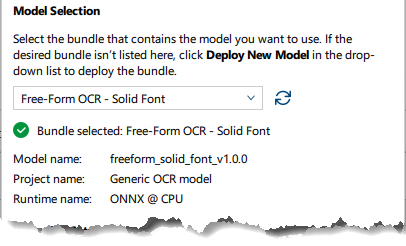
-
원하는 번들이 목록에 없는 경우 클릭하세요. 새 모델 배포 드롭다운 목록에서.
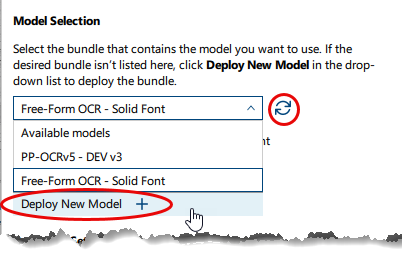
이것은 다음을 엽니다. pylon AI Agent 더 많은 모델을 배포할 수 있습니다.
새 모델을 배포한 후 다음 버튼을 클릭해야 합니다. Refresh button. -
Detection Settings 영역에서 원하는 설정을 구성합니다.
정보
이 영역에서 사용할 수 있는 파라미터는 선택한 모델에 따라 다릅니다. 일부 파라미터는 특정 모델을 선택한 경우에만 사용할 수 있습니다. 기본값은 모델에서 제공됩니다.
-
OK를 클릭합니다.
pin data view에서 Free-Form OCR vTool의 결과를 확인할 수 있습니다. 여기에서 표시할 출력을 선택할 수 있습니다.
입력#
이미지#
Camera vTool 또는 이미지를 출력하는 vTool(예: Image Format Converter vTool)에서 직접 이미지를 허용합니다.
- 데이터 형식: 이미지
- 이미지 포맷: 모노 또는 컬러 이미지. 지원되는 Pixel Format은 모델에 따라 내부적으로 Mono 8 또는 BGR 8 Packed로 변환됩니다. 자세한 내용은 Image Formats를 참조하십시오.
ROI#
ROI Creator vTool 또는 직사각형을 출력하는 기타 vTool에서 관심 영역(region of interest)을 허용합니다.
ROI(직사각형)가 회전된 경우, 추론 전에 바로잡힙니다. 직사각형 내부 영역이 입력 이미지에서 잘려 나오고 축에 정렬되도록 회전됩니다. 이렇게 바로잡힌 크롭 영역이 추론에 사용됩니다.
결과 바운딩 박스가 변환되어 원래 입력 이미지의 좌표계로 반환됩니다. 따라서 회전에는 ROI의 회전이 포함됩니다. 위치, 너비, 높이는 잘려진 영역이 아니라 항상 입력 이미지를 기준으로 합니다.
- Data type: RectangleF
출력#
Texts, BBoxes_px, Scores 결과는 인덱스가 정렬된 배열로 출력됩니다. 출력에서 동일한 위치에 있는 항목은 동일한 텍스트 세그먼트를 나타냅니다.
텍스트#
감지된 각 단어 또는 텍스트 세그먼트를 반환합니다.
- 데이터 타입: String Array
BBoxes_px#
모든 텍스트 감지에 대한 바운딩 박스를 반환합니다. 각 바운딩 박스는 중심 픽셀의 좌표, 너비, 높이 및 회전(x_center, y_center, width, height, rotation)에 의해 정의됩니다. 회전은 라디안 단위이며 x축에서 반시계 방향으로 측정됩니다. 좌표는 Roi 입력 핀이 연결된 경우를 포함하여 원래 입력 이미지를 참조합니다. 바운딩 박스 출력은 다른 vTool의 Roi 입력 핀에 대한 입력으로 사용할 수 있습니다.
- Data type: RectangleF Array
Scores#
각 텍스트 감지에 대한 신뢰도 점수를 반환합니다. 값이 높을수록 신뢰도가 높음을 의미합니다.
- 데이터 타입: Float Array
Payload#
평가를 위한 Inference Server의 성능과 관련된 추가 정보를 반환합니다. 이 출력 핀은 Debug Settings 파라미터 그룹의 Features - All 창에서 활성화한 경우에만 사용할 수 있습니다.
- 데이터 타입: String