pylon AI Agent#
DL 모델은 하드웨어 구성 등과 함께 번들로 패키징되어 pylon AI Platform을 통해 릴리스됩니다. 릴리스된 후에는 pylon AI Agent를 사용하여 Triton Inference Server에서 pylon AI vTools용 모델을 배포합니다.
Triton Inference Server는 추론 프로세스를 처리합니다. 딥러닝에서 추론이란 학습된 모델을 새롭고 보지 못한 데이터에 적용하여 콘텐츠에 대한 예측을 수행하는 것을 의미합니다.
pylon AI Agent 개요#
AI Agent를 시작하는 방법에는 두 가지가 있습니다:
- pylon Viewer의 Workbench 메뉴에서
- vTool의 설정 대화상자에서
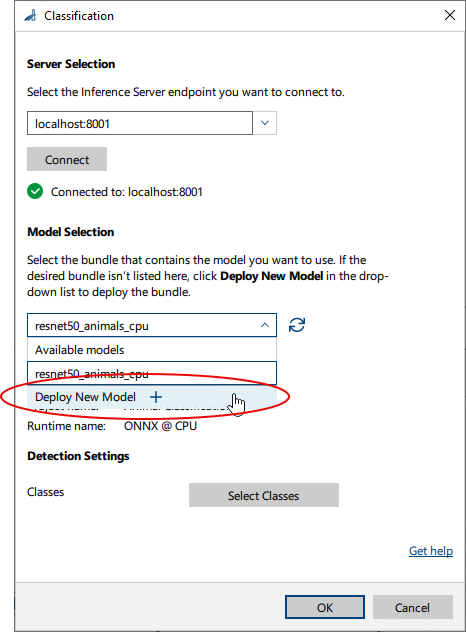
두 방법 모두 Deployed Models 탭에서 AI Agent를 엽니다. 여기에서 이미 배포된 모델을 확인할 수 있습니다.
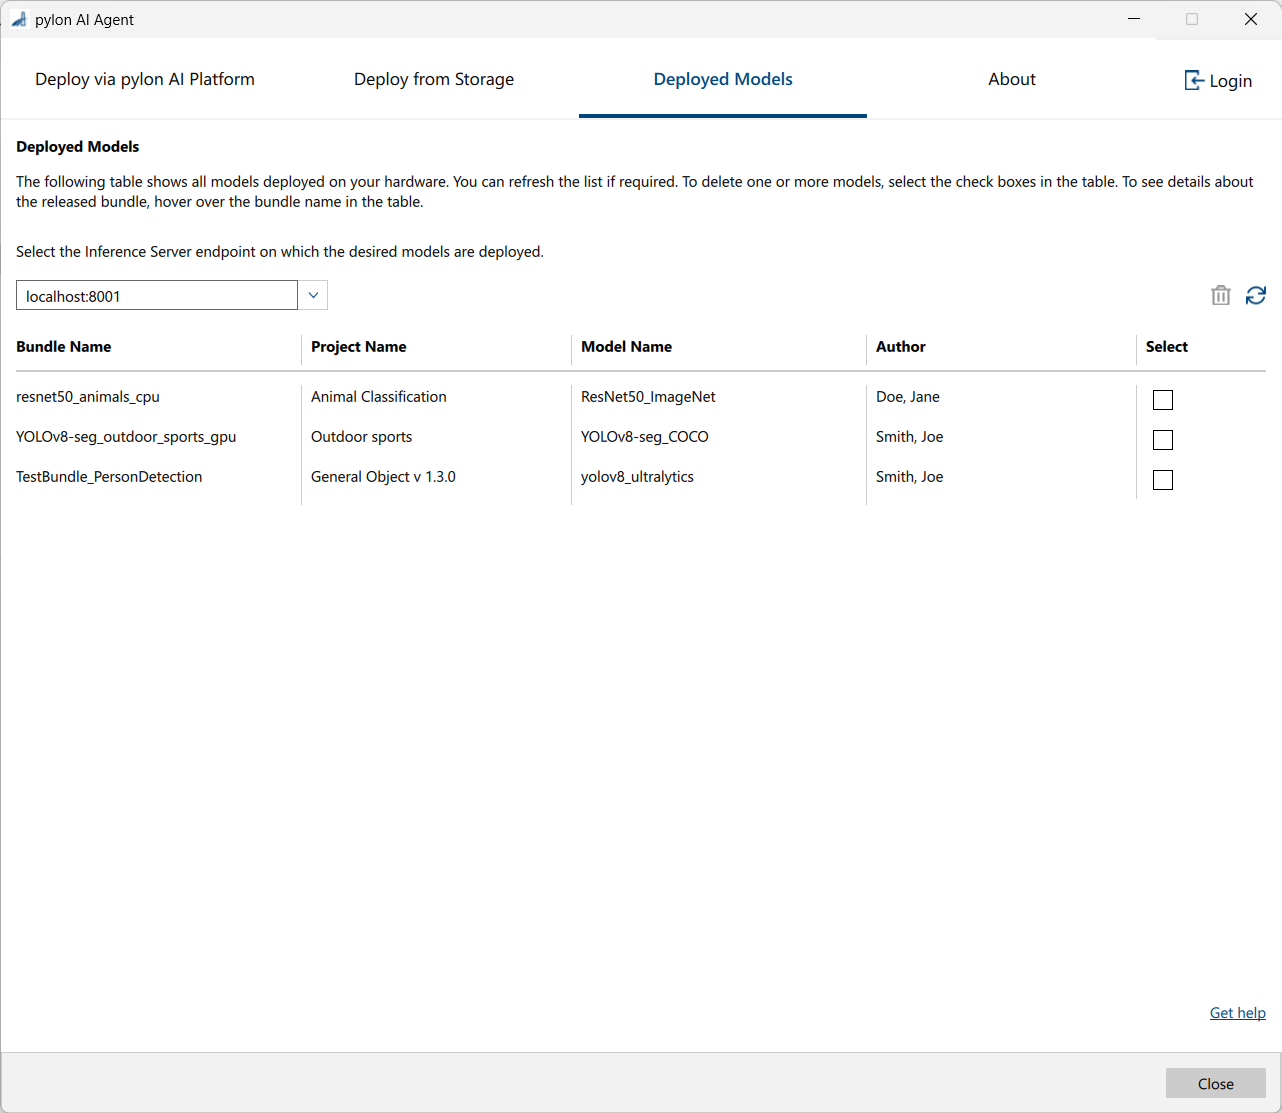
모델을 배포하려면 pylon AI Platform을 통한 배포 또는 하드 드라이브나 플래시 드라이브 같은 스토리지에서의 배포 중 하나를 선택할 수 있습니다.
pylon AI Platform을 통한 배포#
pylon AI Platform을 통해 모델을 배포하려면 다음 사항을 유의해야 합니다.
-
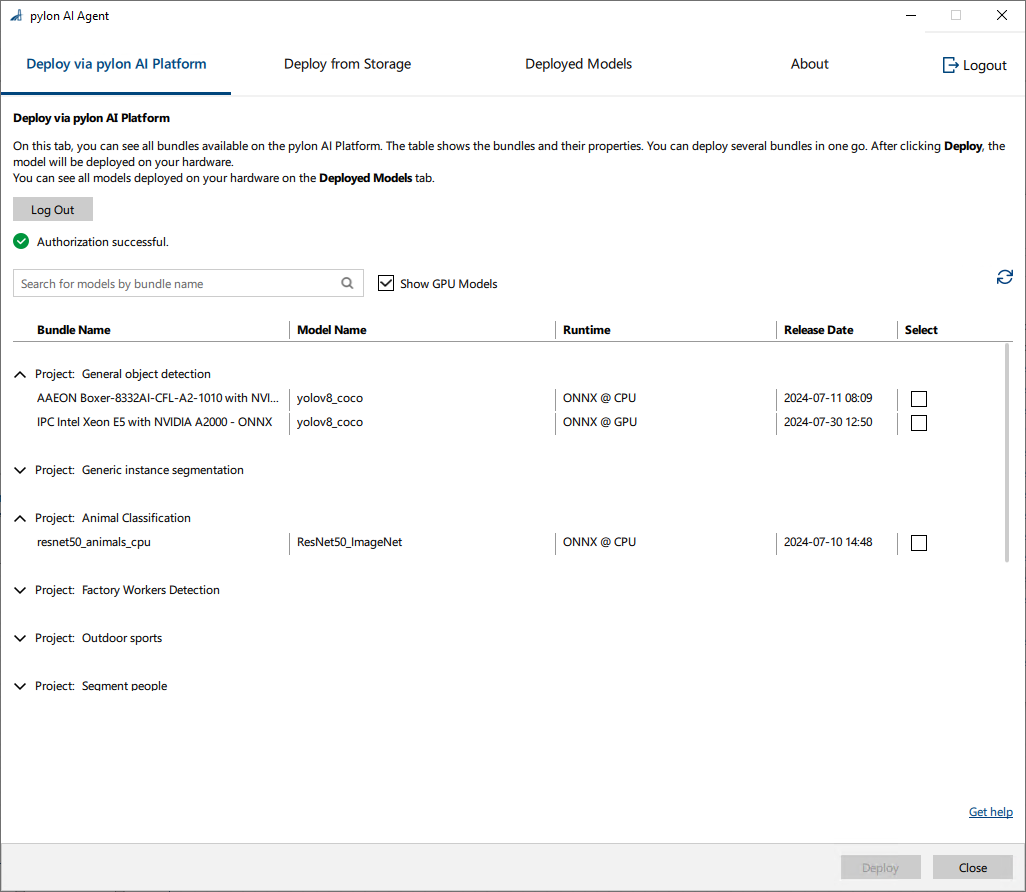
AI Agent를 다음에서 연 경우: Workbench 메뉴에서 모든 비전 태스크에 사용 가능한 모든 모델을 확인할 수 있습니다. pylon AI Platform을 통해 배포 탭.
-
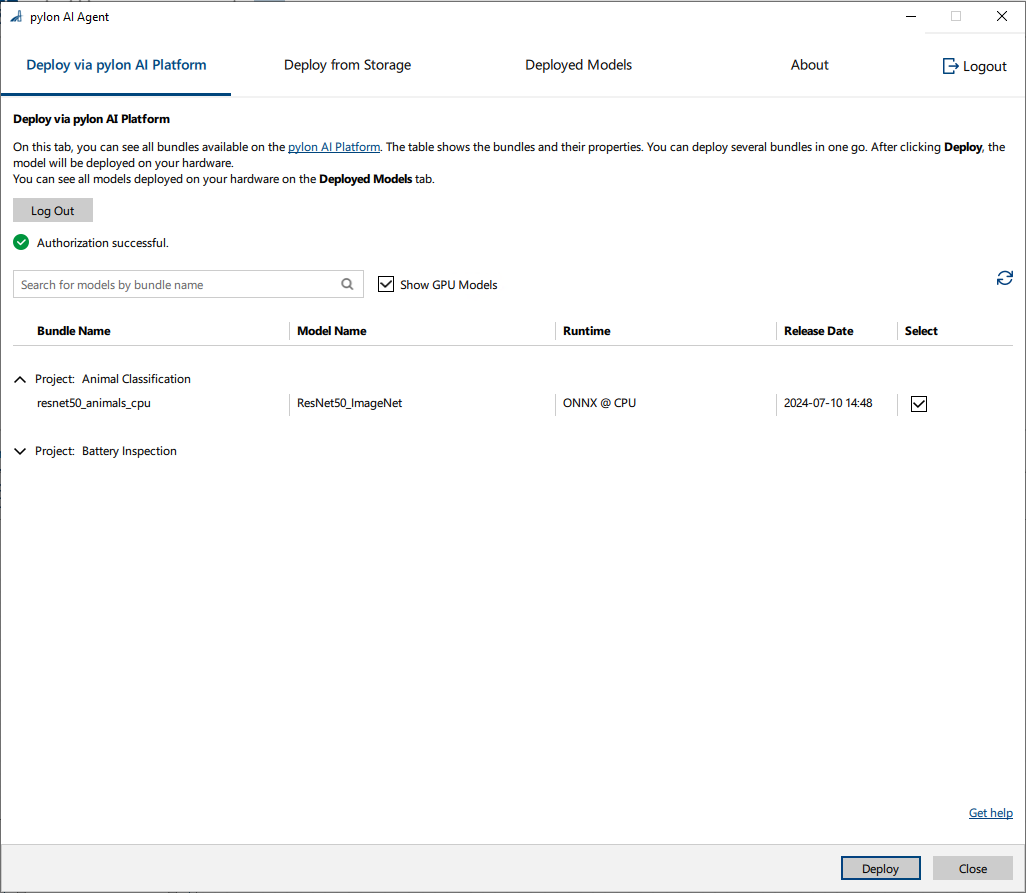
vTool의 설정 대화상자에서 AI Agent를 연 경우, 현재 구성 중인 vTool에 적합한 모델만 표시됩니다. 다음 스크린샷은 Classification vTool의 설정 대화상자에서 AI Agent를 연 경우입니다.
스토리지에서 배포#
스토리지에서 모델을 배포하려면, 먼저 AI Platform에서 원하는 모델이 포함된 번들을 원하는 스토리지 매체에 다운로드해야 합니다.
모델 배포#
- Triton Inference Server를 시작합니다.
지침은 pylon AI용 pylon Supplementary Package에 포함된 설치 문서를 참조하십시오. - 다음 방법 중 하나로 pylon AI Agent를 시작하십시오.
- pylon Viewer의 Workbench 메뉴에서
- vTool의 설정 대화상자에서
pylon AI Agent가 Deployed Models 탭에서 열립니다. 여기에서 이미 배포된 모델을 확인할 수 있습니다.
-
스토리지 또는 pylon AI Platform을 통해 새 모델을 배포할지 여부를 결정하십시오.
-
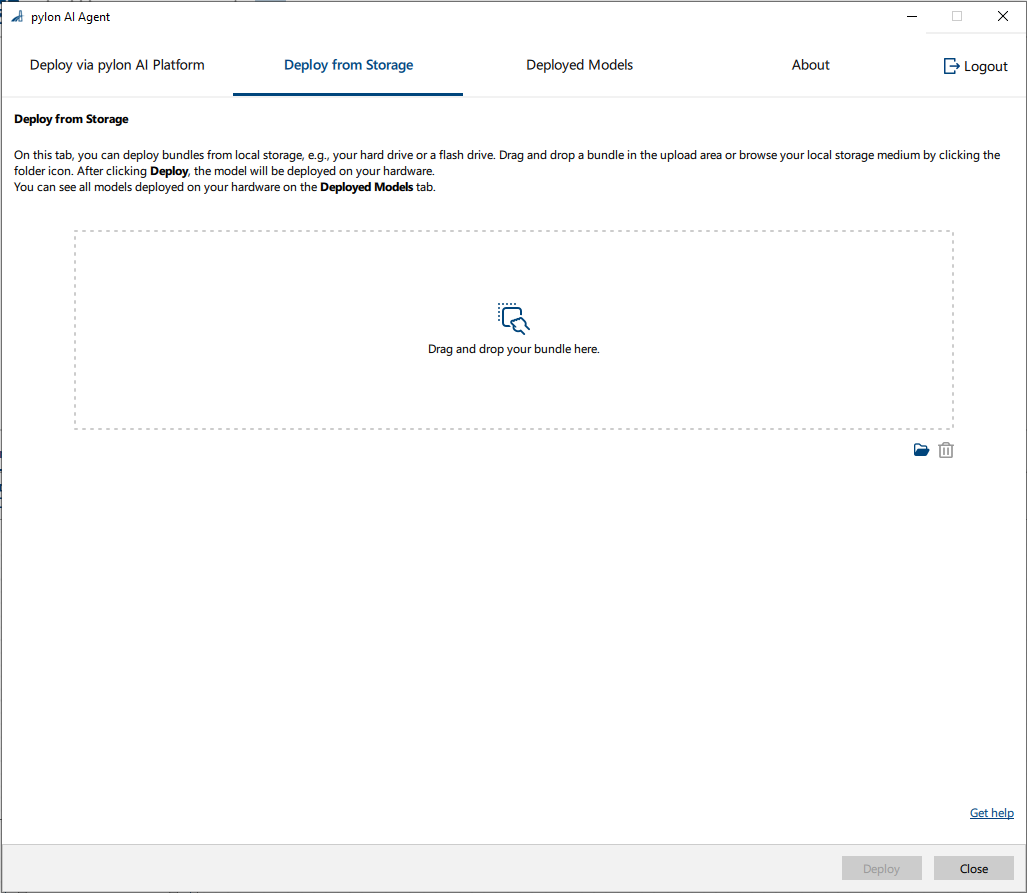
스토리지에서 배포
- pylon AI Platform에서 아직 다운로드하지 않았다면 원하는 번들(bundle)을 다운로드하십시오.
- Deploy from Storage 탭으로 이동합니다.
- 번들을 드롭 영역으로 드래그 앤 드롭하거나 폴더 아이콘을 클릭하여 원하는 번들 파일을 찾습니다.
로컬 또는 원격 스토리지 위치일 수 있습니다. - Deploy를 클릭합니다.
- 다음에서 서버 선택 대화 상자에서 모델을 배포할 Triton Inference Server를 선택합니다.
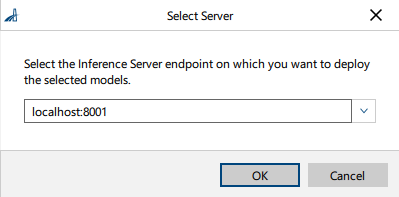
- OK를 클릭합니다.
배포가 즉시 시작됩니다. 배포가 완료되면 메시지가 표시됩니다.
-
pylon AI Platform을 통해 배포
- Deploy via pylon AI Platform 탭으로 이동합니다.
- Log in 버튼을 클릭하여 pylon AI Platform에 로그인합니다.
로그인할 수 있는 AI Platform으로 이동합니다. 그 후 웹 페이지가 닫히고 AI Agent로 자동 복귀되어야 합니다. 그렇지 않은 경우 계속 진행하려면 직접 AI Agent로 돌아가십시오. - 테이블에 나열된 번들 중 하나 이상을 선택합니다.
- Deploy를 클릭합니다.
- 다음에서 서버 선택 대화 상자에서 모델을 배포할 Triton Inference Server를 선택합니다.
- OK를 클릭합니다.
배포가 즉시 시작됩니다. 배포가 완료되면 메시지가 표시됩니다.
-
일반적인 고려사항#
- Model naming: Triton Inference Server에 동일한 이름의 여러 모델을 배포할 수 없습니다. 각 모델은 Triton Inference Server의 모델 리포지토리 내에서 고유한 이름을 가져야 합니다. Triton Inference Server는 모델 이름을 식별자로 사용하여 추론 요청을 적절한 모델로 관리하고 라우팅하므로 고유한 이름이 필요합니다. 이름이 같은 모델이 두 개 있는 경우 서버가 이들을 구분할 수 없습니다.
- Network latency and bandwidth: 충분한 대역폭을 확보하십시오. 특히 대역폭이 제한된 네트워크에서는 대용량 모델을 다운로드하는 데 오랜 시간이 걸릴 수 있습니다.
- Sufficient local storage: Triton Inference Server에는 다운로드한 모델을 캐시하거나 임시로 저장할 수 있는 충분한 로컬 스토리지 공간이 필요합니다. 로컬 스토리지가 부족한 경우, 대용량 모델을 배포하거나 여러 모델을 동시에 배포할 때 문제가 발생할 수 있습니다.
- 서버 및 vTools 원격 실행: 원격 컴퓨터에서 Triton Inference Server를 실행하고 다른 위치에서도 AI vTools를 실행하는 경우 다음의 중요한 제한 사항과 고려 사항에 유의하십시오.
- 추론 요청을 수행하는 vTool과 Triton Inference Server 사이에서 데이터가 이동하는 데 걸리는 시간은 전체 응답 시간에 영향을 미칠 수 있습니다.
- 대기 시간이 길어지면 특히 실시간 애플리케이션의 경우 추론 프로세스가 느려질 수 있습니다.
- 네트워크 대역폭이 제한되면 특히 대량의 데이터를 전송할 때 통신이 느려지거나 불안정해질 수 있습니다.