Parallelism#
핵심 용어
Base Design Clock은 프레임 그래버에서 생성된 FPGA 파이프라인의 클럭으로, 예를 들어 312.5 MHz입니다. 이는 카메라 픽셀 클럭과 다르며 VisualApplets 편집기 내의 클럭도 아닙니다. 클럭 주기(clock cycle)는 Base Design Clock의 1 틱입니다. 클럭 주기당 링크를 통과할 수 있는 픽셀 수는 특정 수입니다. 이 수가 parallelism입니다. Parallelism이 4라는 것은 클럭 주기당 4개의 픽셀을 의미합니다. Base Design Clock 주파수가 높거나 parallelism이 높으면 픽셀 레이트(pixel rate)가 증가하며, 이 항목에서는 이를 대역폭(bandwidth)이라고 부릅니다.
Parallelism 및 대역폭#
Parallelism은 생성된 FPGA 파이프라인의 링크를 통해 클럭 주기당 흐르는 픽셀 수입니다.
Parallelism은 모듈 내의 처리 세분성에 영향을 줍니다. 예를 들어, LineBuffer 매개변수 XLength 은 parallelism에 따라 달라집니다.
다음 규칙이 적용됩니다:
- Higher Parallelism → higher pixel-rate bandwidth.
- Higher Parallelism → higher FPGA resource usage.
Bit Width 및 커널 크기는 이 픽셀 레이트 수치에 포함되지 않습니다. 이는 클록당 데이터 양을 증가시키며, 이는 DRAM 및 리소스에 중요합니다. Working with Kernels 튜토리얼 항목과 Memory Elements 튜토리얼 항목을 참조하십시오.
설계 지침
FPGA 리소스를 절약하기 위해 Parallelism은 필요한 만큼만 유지하십시오.
픽셀 레이트로서 링크의 대역폭은 다음 공식을 따릅니다.
Bandwidth = parallelism × Base Design Clock
Base Design Clock은 사용하는 프레임 그래버에 따라 다릅니다. Basler 프레임 그래버의 경우 Device Resources에서 해당 값을 확인하십시오.
핵심 용어
Link Info 및 Throughput 플래그를 사용하여 설계에서 Parallelism과 데이터 처리량을 시각적으로 확인할 수 있습니다. 툴바에서 다음 버튼을 사용하여 이러한 플래그를 활성화하십시오.
결과적으로 설계에 Link Info 및 Throughput 플래그가 표시됩니다.
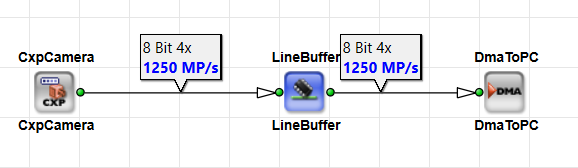
이 항목에서는 Link Info 및 Throughput 플래그가 활성화된 설계의 모든 스크린샷을 보여줍니다.
필요한 Parallelism 계산#
설계를 치수화하려면 먼저 필요한 픽셀 레이트를 계산한 다음 Base Design Clock에서 필요한 Parallelism을 도출하십시오.
면 스캔 디자인의 Parallelism 계산#
에어리어 스캔 카메라가 포함된 설계의 경우 먼저 초당 픽셀 단위로 대역폭을 계산합니다.
Bandwidth = (pixels per line) × (lines per frame) × frame rate
그런 다음 대역폭을 사용하여 필요한 Parallelism을 계산합니다.
Required parallelism = bandwidth / Base Design Clock
계산된 요구 사항보다 크거나 같은 지원되는 가장 작은 Parallelism을 선택합니다. 내림하면 설계 대역폭이 요구 사항 미만으로 떨어지게 됩니다. 예를 들어 Base Design Clock이 312.5 MHz일 때 6000 MP/s에는 19.2의 Parallelism이 필요합니다. Parallelism 19는 5937.5 MP/s만 제공하므로 충분하지 않습니다. 20 또는 플랫폼에서 허용하는 다음으로 높은 값을 사용하십시오.
면 스캔 계산 예시#
해상도가 2064 × 2064 픽셀이고 초당 30프레임인 카메라의 경우 다음 대역폭 계산이 적용됩니다.
Bandwidth ≈ 2064 × 2064 × 30 ≈ 127.9 MP/s
Base Design Clock이 312.5 MHz인 경우 이는 다음과 같은 계산된 Parallelism으로 이어집니다.
Required parallelism ≈ 127.9 / 312.5 ≈ 0.41 → 올림하여 1
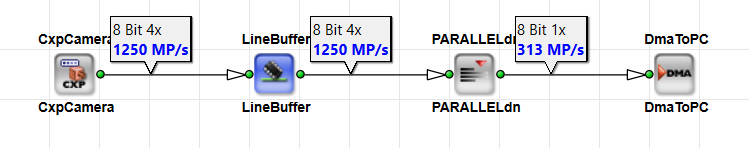
위 스크린샷은 해당 VisualApplets 설계 구현을 보여줍니다. 다음의 Parallelism 카메라 인터페이스 이 다음으로 설정된 경우 4. 해당 값은 대역폭 계산에서 도출된 processing parallelism이 아닙니다. 다음 CxpCamera operator는 ConnectionCount 모듈 파라미터(이 경우, x1)에 의해 정의된 CXP 연결 수를 기반으로 interface parallelism을 자동으로 설정합니다. Interface parallelism과 필요한 processing parallelism은 서로 다른 수치입니다. 필요한 processing parallelism이 1이므로, 링크 parallelism은 1 operator의 출력 링크에서 LineBuffer (으)로 줄어듭니다.
낮은 프레임 레이트에서는 parallelism 값으로 1 이(가) 충분합니다. 더 높은 프레임 레이트나 해상도에서는 필요한 parallelism이 증가합니다. 값을 계산한 후 지원되는 다음 단계로 올림하십시오. 예: 2, 4, 또는 8. 플랫폼에서 짝수 parallelism을 요구하는 경우, 먼저 올림한 후 다음으로 높은 유효 짝수 값을 선택하십시오. 예를 들어 계산 결과가 6.3인 경우, 8을(를) 사용하고 7.
라인 스캔 디자인의 Parallelism 계산#
은(는) 사용하지 마십시오. 라인 스캔 카메가를 사용하는 디자인의 경우, 먼저 초당 픽셀 단위로 대역폭을 계산하십시오:
대역폭 = (라인당 픽셀 수) × 라인 레이트
그런 다음 대역폭을 사용하여 필요한 Parallelism을 계산합니다.
Required parallelism = bandwidth / Base Design Clock
플랫폼 규칙 및 허용되는 parallelism 값에 따라 결과를 올림하십시오.
라인 스캔 계산 예시#
해상도가 16384픽셀이고 라인 레이트가 120 kHz인 카메의 경우 다음과 같은 대역폭 계산이 적용됩니다:
대역폭 ≈ 16384 × 120 kHz ≈ 1966.08 MP/s
Base Design Clock이 312.5 MHz인 경우 이는 다음과 같은 계산된 Parallelism으로 이어집니다.
필요한 parallelism ≈ 1966.08 / 312.5 ≈ 6.3 → 7로 올림
계산 결과는 6.3이므로, 다음 정수는 7. 플랫폼에서 짝수 parallelism, 다음으로 높은 유효 짝수 값 선택 (8, 아니면 7). 아래 스크린샷은 Parallelism을 사용합니다. 7, 이는 짝수 Parallelism이 필수가 아닐 때 유효합니다.
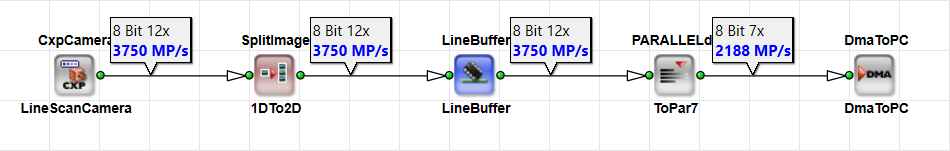
위 스크린샷은 해당 VisualApplets 디자인 구현을 보여줍니다. 카메라 인터페이스의 Parallelism은 다음과 같이 설정됩니다. 12. 이 값은 다음 항목에 의해 자동으로 구성됩니다. CxpCamera CXP 연결 수에서 온 operator (ConnectionCount 매개변수가 다음과 같이 설정됨 x2). 해당 인터페이스 Parallelism 역시 필수 처리 Parallelism과는 다릅니다. 다음 SplitImage operator는 1D-to-2D 변환을 수행합니다. 그 후 LineBuffer operator는 계산된 처리 요구사항에 맞게 링크 Parallelism을 다음으로 줄입니다. 7 .
디자인에서 Parallelism 변경#
아래 operator들은 디자인의 Parallelism을 대역폭 요구사항(bandwidth requirements)에 맞게 조정합니다.
Parallelism 증가 또는 감소#
PARALLELdn— Parallelism을 줄입니다. 참조: PARALLELdn (Operator Reference 내용).PARALLELup— Parallelism을 늘립니다. 참조: PARALLELup (Operator Reference 내용).- LineBuffer (imaFlex 전용): The
ParallelismConverteroperator의LineBufferoperator는 추가 Parallelism operator 없이 입력과 출력 간의 Parallelism을 조정합니다. 참조: LineBuffer (imaFlex) (Operator Reference 내용).
스트림 분할, 선택 및 병합#
SplitParallel— 더 높은 Parallelism을 가진 하나의 데이터 스트림을 더 낮은 Parallelism을 가진 여러 개의 스트림으로 분할합니다. 예: Parallelism8이(가) 각각 Parallelism이4인 두 개의 스트림이 됩니다. 참고: SplitParallel (Operator Reference 내용).SelectFromParallel— 병렬 스트림에서 개별 구성 요소(예: 클록 주기당 전송되는 여러 데이터 단어 중 하나)를 선택합니다. 참고: SelectFromParallel (Operator Reference 내용).MergeParallel— 별도의 처리 후 병렬 스트림을 다시 병합합니다. 참고: MergeParallel (Operator Reference 내용).
기타 Operator#
CastParallel— 링크상의 비트를 다시 해석합니다. Parallelism 및 Bit Width는 다음 조건이 유지되는 한 변경될 수 있습니다. Bit Width × Parallelism 입력과 출력에서 동일하게 유지됩니다. 예: 16 bit × PAR 2는 8 bit × PAR 4가 됩니다. 이미지 너비도 그에 따라 변경됩니다. 다음 내용도 참조하십시오. CastParallel (Operator Reference 내용).ExpandToParallel— Parallelism 1인 입력을 받아 원하는 출력 parallelism을 생성합니다. 입력 값은 모든 병렬 채널로 복제됩니다. 다음 내용도 참조하십시오. ExpandToParallel (Operator Reference 내용).
사용 사례#
다음과 같은 사용 사례가 자주 발생합니다.
-
설정하려는 속성을 식별하려면
PARALLELupparallelism을 높이고, 병렬 브랜치에서 데이터를 처리하며, 다음을 사용하여 브랜치를 다시 병합합니다.MergeParallel.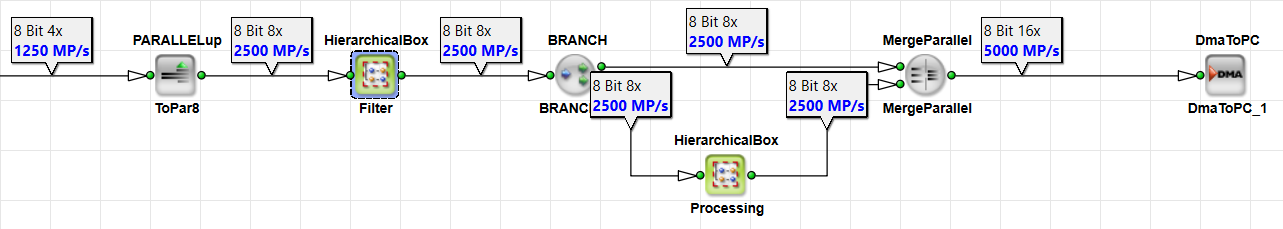
-
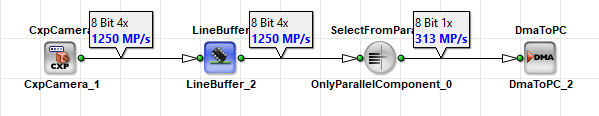
특정 처리 작업의 경우 단일 구성 요소만 선택하는 것만으로도 수학적으로 충분하며 필요한 결과를 제공하는 동시에 데이터 양을 줄일 수 있습니다. 다음을 사용하십시오.
SelectFromParallelparallelism 스트림에서4하나의 채널만 전달합니다.
- 다음 이후
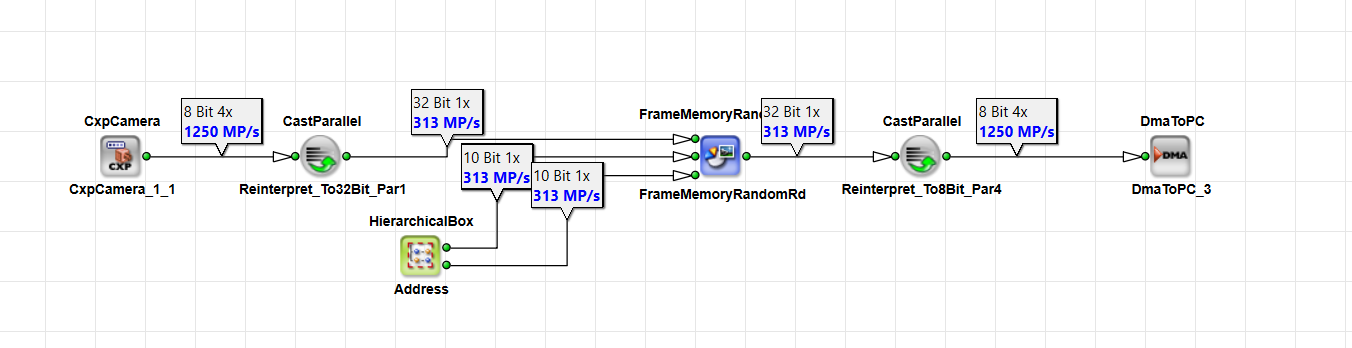
FrameBufferRandomRead, 스트림은 예를 들어 픽셀당 64 bit의1parallelism으로 실행됩니다. 다운스트림 처리가 더 높은 parallelism으로 실행되도록 하려면 데이터 스트림을 8 bit × parallelism으로8재해석합니다. 이를 위해 다음을 사용하십시오.CastParallel(으)로 줄어듭니다.
- 설정하려는 속성을 식별하려면
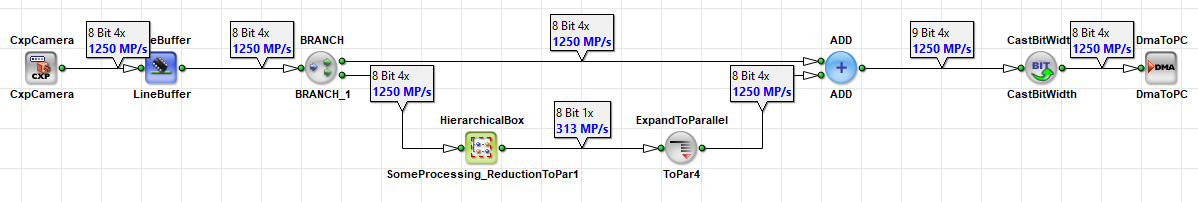
ExpandToParallel예를 들어 병렬 브랜치의 계수나 마스크를 위해 네 개의 모든 병렬 채널에서 동일한 값이 사용 가능해야 할 때, parallelism1에서 parallelism4(으)로 제어 값 또는 픽셀 스트림을 확장합니다.
Parallelism 제약 조건#
픽셀 단위의 최대 이미지 너비는 parallelism(으)로 나누어떨어져야 합니다.
예시:
- Parallelism
4의 경우 허용되는 이미지 너비에는 1024 및 2048이 포함됩니다. - Parallelism
12, 16384의 이미지 너비는 않습니다 16384 / 12가 정수가 아니므로 허용되지 않습니다.
임시 해결 방법:
- 더미 픽셀 — 이미지 너비가 parallelism 값으로 균등하게 나누어떨어질 때까지 시뮬레이션 링크 속성 또는 연산자 등을 통해 이미지 너비를 넓힙니다.
- 자르기 — 유효한 이미지 너비로 이미지를 다듬습니다.
핵심 용어
생성된 FPGA 하드웨어는 클럭당 패킷 단위로 픽셀을 처리합니다. 16384 / 12가 정수가 아니기 때문에 16384픽셀의 라인은 parallelism 12에 깔끔하게 패킹되지 않습니다. 따라서 VisualApplets에서는 디자인의 이미지 너비가 parallelism으로 나누어떨어져야 합니다.
Memory Operator를 이용한 Parallelism#
FrameBufferRandomRead 허용합니다. parallelism 1, 메모리에 순차적으로 액세스하기 때문입니다. 디자인에서 더 높은 Parallelism을 사용하고 전체 대역폭에 영향을 주지 않으려면, 병렬 컴포넌트를 다음을 사용하여 커널 컴포넌트로 변환하십시오. CastKernel operator 또는 현재 픽셀의 상위 비트 컴포넌트로 변환합니다. CastParallel (으)로 줄어듭니다.
방법에 대한 예시는 Working with Kernels 튜토리얼 항목을 참조하십시오.
Operator Reference의 FrameBufferRandomRead 및 Operator Reference의 FrameBufferRandomRead (imaFlex)를 참조하십시오.
병목 현상 문제 해결#
전형적인 병목 현상은 다음과 같은 경우에 발생합니다. InsertLine Operator Reference 또는 InsertImage Operator Reference가 다음와 결합되지 않은 경우 PARALLELup. 연산자 순서가 적절하지 않으면 처리량이 감소할 수 있습니다.
삽입 연산자(Insert operator)를 사용하면 처리 파이프라인으로 유입되는 데이터 양이 증가하여 전체 대역폭이 높아집니다. 따라서 다음 이후의 Parallelism은 InsertLine 또는 InsertImage operator는 결과 대역폭을 처리할 수 있을 만큼 충분히 높아야 합니다.
예시#
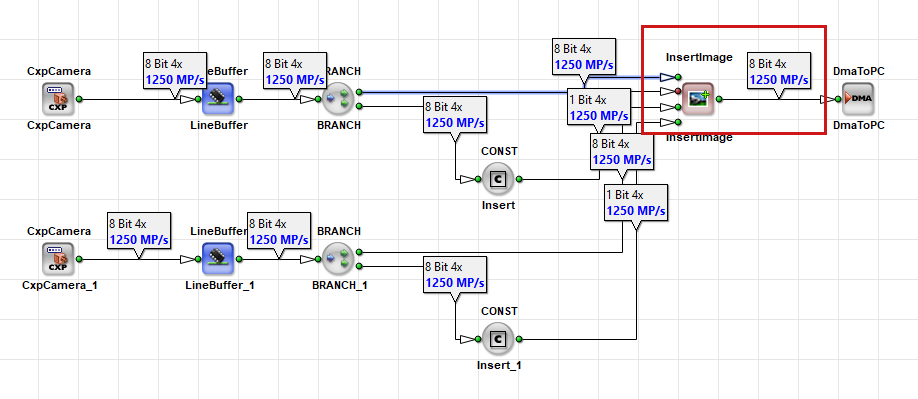
위 이미지의 예시는 다음을 보여줍니다. InsertImage operator에는 두 개의 입력 링크가 있습니다. 각 입력 링크는 4의 Parallelism을 사용하여 5120 × 5120 픽셀 해상도의 이미지를 1250 MPixel/s 대역폭으로 처리합니다.
다음 이전에 Parallelism이 증가하지 않는 경우 InsertImage operator, 입력당 대역폭은 1250 MPixel/s로 유지됩니다. 그러나 두 개의 입력 링크가 있으므로 디자인은 2 × 1250 MPixel/s의 결합된 처리량을 처리해야 합니다.
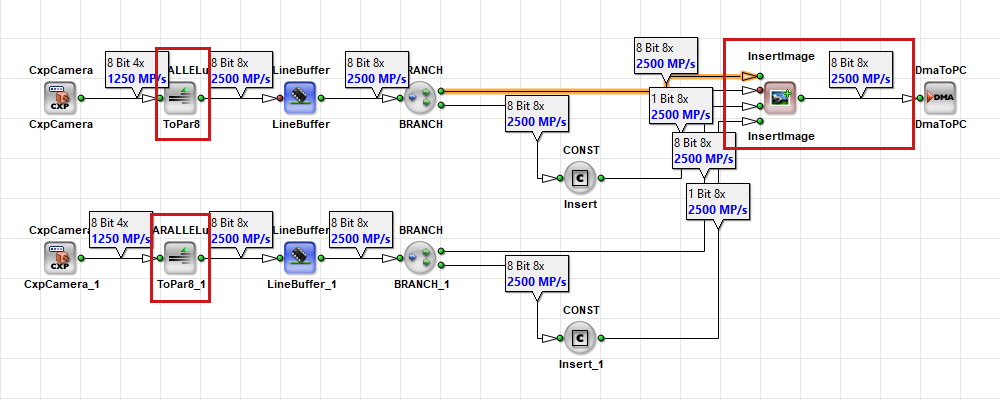
이러한 대역폭 병목 현상을 방지하려면 다음을 사용하여 Parallelism을 높이십시오. PARALLELup operator 이전의 InsertImage operator는 아래와 같습니다.
관련 항목#
- Pipeline Concept 튜토리얼 항목 — 처리량, 병목 현상 및 링크 용량
- Parameterization 튜토리얼 항목 —
Parallelismlink property - Memory 요소 튜토리얼 항목 — RAM 데이터 너비 및
LineBufferParallelism 변환 - Working with Kernels 튜토리얼 주제 — 커널 크기 대 Parallelism
- Latency 튜토리얼 주제 — Parallelism 및 Latency
- 사용 설명서의 Bandwidth of an Applet — 공식적인 Bandwidth 정의
- Device Resources — Base Design Clock 주파수
- 사용 설명서의 Bandwidth Bottlenecks — 오퍼레이터 순서 지정 및 병목 현상