파이프라인 개념#
공식적인 데이터 흐름 모델은 사용자 매뉴얼의 Data Flow를 참조하십시오. 디자인을 처음부터 끝까지 빌드하고 검증하는 방법은 From Empty Design to Running Applet 튜토리얼 주제를 참조하십시오.
Modules, Links, and Pipeline Structure#
operator 라이브러리의 operators를 사용하여 VisualApplets 디자인을 빌드합니다. 배치된 각 operator 인스턴스는 module입니다. 모듈은 input 및 output 포트를 제공합니다. links를 사용하여 포트를 연결합니다. 다이어그램에는 각 링크가 화살표로 표시되어 있습니다.
VisualApplets 디자인의 모듈과 링크는 함께 이미지 처리 pipeline을 형성합니다. 빌드를 통해 해당 그래프가 프레임 그래버 FPGA의 하드웨어 단계로 구현됩니다. 처리 순서는 연결 순서를 따릅니다. 분기와 병합은 그래프에서 병렬 경로와 통합 지점을 정의합니다.
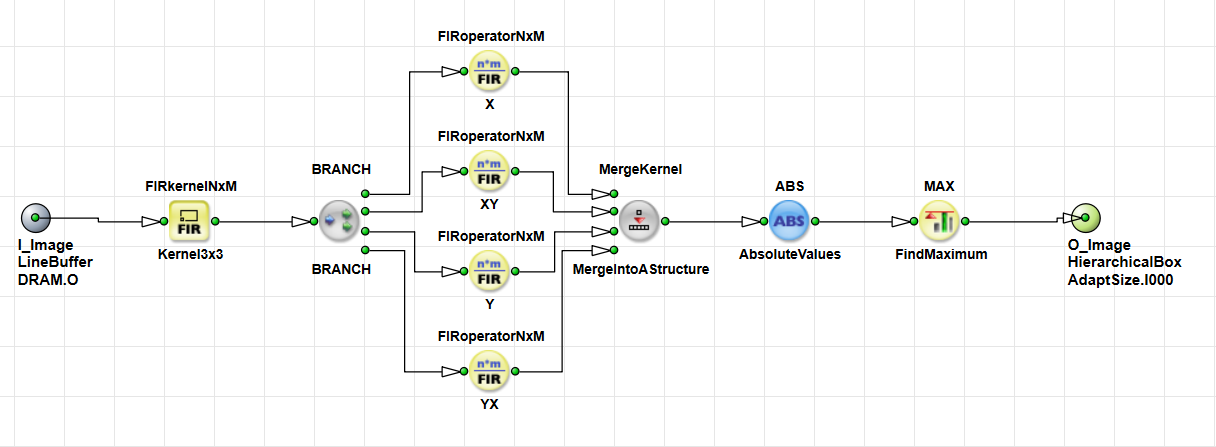
각 모듈은 입력 데이터를 사용할 수 있게 되는 즉시 처리를 시작합니다. 계산이 완료되고 출력이 차단되지 않은 경우 출력 링크로 결과를 전달합니다. 런타임 시 이 동작은 VisualApplets의 그래픽 심볼이 아니라 모듈에서 생성된 FPGA 로직에 의해 구현됩니다. 따라서 파이프라인 구조는 데이터가 분기되는 곳, 다시 결합되는 곳, 그리고 어떤 모듈이 직렬 또는 병렬로 실행되는지를 정의합니다.
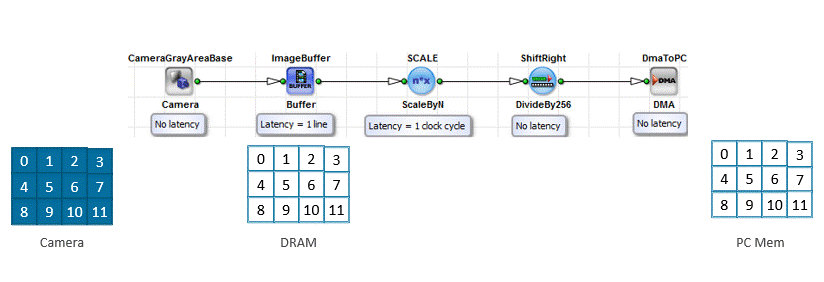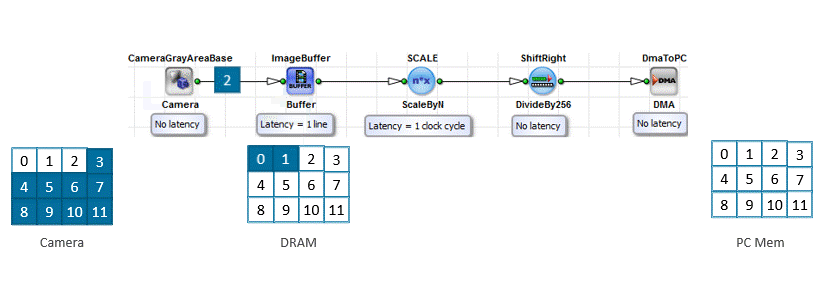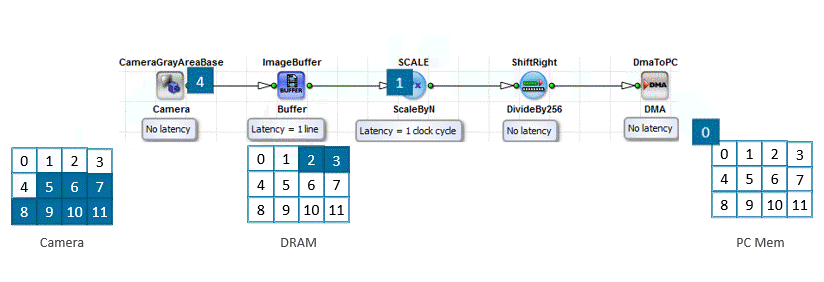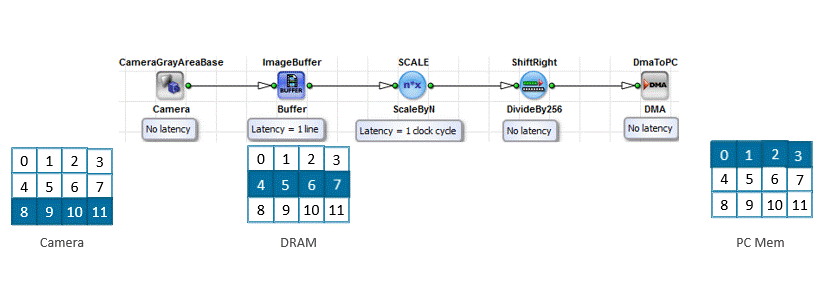
픽셀은 한 번에 완성된 이미지 형태로 프레임 그래버에 입력되지 않습니다. 카메라는 픽셀을 획득 경로로 하나씩 차례대로 전송하거나, 앱릿 내부 이미지 소스가 픽셀을 하나씩 차례대로 생성합니다. 그런 다음 해당 픽셀은 동일한 순차적 순서로 pipeline 단계를 통과합니다.
Key Terms
픽셀을 도로 위의 자동차에 비유해 보세요. 자동차들은 길을 따라 서로 뒤를 이어 달립니다. 어느 순간이든, 각기 다른 자동차(픽셀)들은 도로(파이프라인 단계)의 서로 다른 위치에 있습니다. 도로 자체는 ‘ VisualApplets ’ 설계에서 연결한 파이프라인 구조입니다. 빌드 후에는 그 도로가 ‘ VisualApplets ’ 편집기 내부의 경로가 아니라, 프레임 그래버 FPGA상의 하드웨어가 됩니다.
이 비유에서 Parallelism은 도로의 차선 수와 같습니다. 차선이 많을수록 더 많은 차량(픽셀)이 동시에 앞으로 이동할 수 있습니다.
Pipeline Inputs and Outputs#
모든 pipeline에는 디자인으로 데이터를 공급하는 source가 하나 이상 있으며, FPGA 처리 경로를 벗어나는 하나 이상의 sinks가 있습니다. 소스와 싱크는 보통 M 타입 operator입니다. 사용 가능한 operator는 타겟 하드웨어 플랫폼에 따라 다릅니다.
입력#
데이터는 다음과 같은 방식으로 파이프라인에 입력될 수 있습니다.
- 카메라 또는 기타 이미지 소스에서: 플랫폼별 카메라 operator는 연결된 카메라의 연속적인 픽셀 스트림을 획득 경로로 전달합니다.
- 앱릿 내부에서 생성됨: 다음과 같은 operator
CreateBlankImage또는CoefficientBuffer라이브 카메라 없이 이미지 데이터를 생성하거나 재생합니다. 이러한 소스는 Test Patterns, 호스트에서 업로드한 참조 데이터, 또는 카메라에서 획득하지 않는 디자인에 사용됩니다.
신호 경로는 디지털 입력(예: GPI) 또는 앱릿 내부 신호 발생기에서 생성됩니다. 흐름 제어 하에서 카메라 소스가 중지 가능한 앱릿 내부 소스와 어떻게 다른지 알아보려면 다음을 참조하십시오. 중지 가능 및 중지 불가능 데이터 스트림 Tutorial topic.
출력#
처리된 결과는 다음과 같은 방식으로 파이프라인을 벗어날 수 있습니다.
- 호스트로의 DMA:
DmaToPC오퍼레이터는 직접 메모리 액세스(Direct Memory Access)를 통해 이미지 데이터를 호스트 PC 메모리로 전송합니다. 이는 호스트 소프트웨어에서 처리된 이미지를 획득하는 일반적인 경로입니다. - GPO를 통한 신호:
GPO오퍼레이터는 프레임 그래버의 디지털 출력핀을 구동합니다. 이 경로는 트리거, 상태 또는 호스트 PC 외곽의 기타 하드웨어 제어 신호에 사용합니다. - 호스트로의 이벤트:
EventToHost및EventDataToHostoperators는 소프트웨어 이벤트를 호스트로 전송합니다. 호스트 응용 프로그램은 Framegrabber API를 통해 이를 수신하고 앱릿의 조건에 대응할 수 있습니다.EventToHost신호 입력의 상승 에지에서 이벤트를 발생시키며 페이로드를 전달하지 않습니다.EventDataToHost구성 가능한 데이터 페이로드와 함께 이벤트를 발생시킵니다. - 레지스터 정보만 해당: 일부 결과는 읽을 수 있는 값으로 프레임 그래버에 유지됩니다. 다음과 같은 오퍼레이터가 있습니다.
GetStatus호스트 소프트웨어가 동적 파라미터로 읽는 값을 저장합니다. 응용 프로그램에 상태 또는 측정 수치만 필요한 경우에는 이미지 스트림이나 DMA 전송이 필요하지 않습니다.
디자인은 이러한 출력 중 여러 개를 결합할 수 있습니다. 예를 들어, 한 분기는 다음을 통해 이미지를 전송할 수 있습니다. DmaToPC 반면 다른 분기는 조건이 발생할 때 GPO 핀을 어서트하거나 호스트 이벤트를 발생시킵니다.
오퍼레이터에 대한 자세한 내용은 Operator Reference의 DmaToPC, Operator Reference의 GPO, Operator Reference의 EventToHost, Operator Reference의 EventDataToHost, Operator Reference의 GetStatus를 참조하십시오.
Unbuffered Pipeline Flow#
대부분의 모듈은 내부적으로 전체 이미지를 저장하지 않습니다. 출력 값을 계산하고 정보가 사용 가능할 때 즉시 전달합니다.
모든 오퍼레이터가 입력에 데이터가 도착하자마자 결과를 출력하는 것은 아닙니다. M-type 특히 오퍼레이터는 출력을 지연시킬 수 있습니다. 이는 다음과 같은 버퍼 오퍼레이터뿐만 아니라 LineBuffer 또는 ImageFifo — 많은 필터 및 동기화 오퍼레이터도 M-type에 해당합니다. 지연 시간이 얼마나 되는지는 오퍼레이터에 따라 다릅니다. 자세한 내용은 다음을 참조하십시오. Operator 유형 및 동기화 Tutorial 항목 및 지연 시간 Tutorial topic.
버퍼 operators는 다운스트림 모듈이 데이터를 수용할 수 있을 때까지 데이터를 저장합니다.
이 unbuffered 동작은 latency를 낮게 유지합니다. 동일한 프레임의 다른 픽셀이 여전히 카메라 입력에 있는 동안에도 픽셀이 출력에 도달할 수 있습니다. 획득, 처리 및 DMA는 시간에 따라 중첩될 수 있습니다.
Key Terms
생성된 FPGA 파이프라인을 분기와 밸브가 있는 파이프 시스템으로 생각하십시오. 공간이 생기는 즉시 물이 파이프를 통해 흐릅니다. 버퍼 operator는 배출구가 속도를 따라가지 못할 때 채워지는 작은 저수지와 같습니다.
경로를 따라 latency가 누적되는 방식과 대역폭과 latency의 차이점에 대해서는 Latency Tutorial 항목을 참조하십시오.
Concurrent Processing in Hardware#
프레임 그래버 FPGA에서는 모든 파이프라인 단계가 동시에 실행됩니다. 이는 명령어를 대체로 순차적으로 실행하는 일반적인 CPU 프로그램과 다릅니다.
하나의 FPGA 모듈이 픽셀을 처리하는 동안 다른 모듈은 경로를 따라 더 나아간 다른 픽셀을 처리합니다. 파이프라인이 채워진 후에는 여러 모듈이 동시에 동일한 이미지 작업을 수행합니다. FPGA는 pipeline 그래프와 일치하는 구조를 가진 전용 하드웨어로 VisualApplets 디자인을 구현합니다.
Key Terms
VisualApplets 디자인에서 생성된 FPGA 하드웨어에서 처리 경로는 프레임 그래버의 전용 하드웨어 로직으로 구현됩니다. 데이터는 컨베이어 벨트 위의 물품처럼 해당 하드웨어 단계를 통과합니다. CPU는 대개 전체 데이터 청크를 로드하고 순서대로 단계를 거쳐 작업합니다.
생성된 앱릿이 편집 가능한 *.vad 디자인과 어떻게 연관되는지에 대한 자세한 내용은 VisualApplets Fundamentals Tutorial 항목을 참조하십시오.
Throughput and Bottlenecks#
Throughput은 파이프라인을 통과하는 지속적인 데이터 속도입니다. VisualApplets 디자인에서는 생성된 FPGA 하드웨어의 링크에 있는 bandwidth와 밀접한 관련이 있습니다.
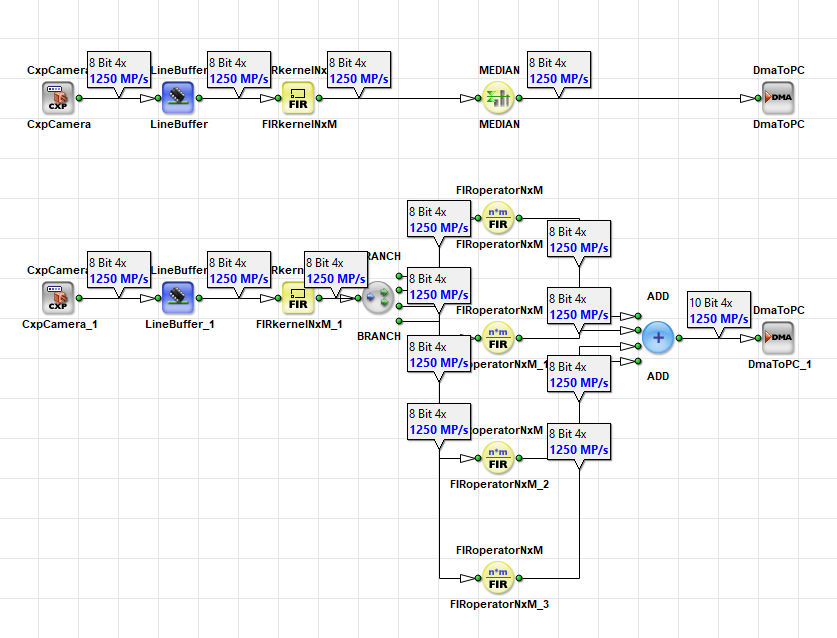
디자인 내의 모듈 개수는 처리량(throughput)을 저하시키지 않습니다. 생성된 모든 FPGA 스테이지는 Parallelism로 실행될 수 있습니다. 병렬 브랜치 수 역시 처리량을 감소시키지 않습니다. 브랜치는 하드웨어 리소스를 추가하지만, 그 자체만으로는 개별 경로의 데이터 속도를 느리게 하지 않습니다. 다음 두 가지 디자인에서 볼 수 있듯이, 두 개의 취득 경로는 서로 다른 수의 모듈을 사용하면서도 동일한 처리량을 제공할 수 있습니다.
처리량은 다음 요인에 따라 달라집니다.
- Link capacity: 모듈 간 연결이 전송할 수 있는 데이터 양입니다. 용량은 모듈 및 링크의 파라미터화(특히 Parallelism, Bit Width, maximum image dimensions)와 기본 디자인 클록(Base Design Clock)에 의해 결정됩니다. 링크 속성 및 모듈 파라미터에 대한 자세한 내용은 Parameterization 튜토리얼 항목을 참조하십시오.
- Downstream readiness: 모듈이 데이터를 연속적으로 수용할 수 있는지 여부입니다. 예를 들어 버퍼가 가득 찼거나 후속 모듈이 차단되어 모듈이 데이터를 영구적으로 받을 수 없는 경우, 흐름 제어(flow control)가 스트림을 중지시키며 이는 블로킹(blocking), 백프레셔(backpressure) 또는 둘 다를 유발합니다.
- Operator limits: 일부 오퍼레이터는 입력 링크가 제공하는 전체 대역폭을 처리할 수 없습니다. Operator Reference에는 영향을 받는 각 오퍼레이터에 대한 이러한 제한 사항이 문서화되어 있습니다.
픽셀 속도(초당 픽셀 수)로서 링크의 bandwidth는 다음 공식을 따릅니다.
Bandwidth = Parallelism × Base Design Clock
이 픽셀 속도 공식에는 Bit Width나 커널 크기가 포함되지 않습니다. 더 넓은 Bit Width나 더 큰 커널은 클록당 데이터 양(비트 또는 값)을 증가시키며, 이는 DRAM 액세스 및 FPGA 리소스에 중요하지만 이 픽셀 속도 수치를 변경하지는 않습니다. DRAM 데이터 너비에 대해서는 Memory Elements Tutorial 항목을 참조하십시오. 커널 대 픽셀 속도 대역폭에 대해서는 Working with Kernels Tutorial 항목을 참조하십시오.
Base Design Clock은 프레임 그래버 플랫폼에 따라 다릅니다. Device Resources에서 값을 확인하십시오.
최대 이미지 치수 역시 이 픽셀 레이트 공식에는 나타나지 않지만, 여전히 디자인을 형성하는 요소로서 파이프라인이 처리할 수 있는 이미지 크기를 제한합니다. Parallelism 및 Bit Width와 함께 이러한 link property는 카메라 또는 라인 스캔 소스와 일치해야 합니다.
경로의 bottleneck은 해당 경로를 따라 가장 낮은 대역폭입니다. 디자인의 전체 Throughput은 항상 이 가장 좁은 지점에 의해 제한됩니다. 하나의 좁은 링크 또는 대역폭이 제한된 오퍼레이터는 동일한 경로에서 그 상류에 있는 모든 항목의 Throughput을 제한합니다. 따라서 Throughput은 경로상의 가장 좁은 대역폭과 다운스트림 모듈이 데이터를 연속적으로 수락하는지 여부에 따라 결정됩니다.
디자인 가이드라인
카메라 또는 라인 스캔 소스에 필요한 레이트를 지원하는 데 필요한 수준으로만 Parallelism 및 link property를 설정하십시오. 이러한 값을 더 높이면 추가 FPGA 리소스가 소비되며, 다른 구성 요소가 이미 병목 구간인 경우 처리량이 향상되지 않습니다.
일부 오퍼레이터는 입력과 출력 간의 Parallelism을 변경합니다. 다른 오퍼레이터는 예를 들어 이미지를 자르(crop)는 등의 방식으로 픽셀 수를 줄입니다. 결과적으로 필요한 출력 대역폭이 입력 대역폭과 다를 수 있습니다. 가능한 경우 오퍼레이터는 Parallelism을 자동으로 조정합니다. 조정이 불가능한 경우 VisualApplets은 Design Rules Check 오류를 보고합니다.
디자인에 필요한 대역폭을 계산하는 방법과 오퍼레이터가 스트림을 병합할 때 대역폭 병목 현상을 해결하는 방법을 포함하여 Parallelism 계산 및 조정에 대한 정보는 Parallelism Tutorial 항목 및 Troubleshooting Bottlenecks Tutorial 항목을 참조하십시오.
Visualizing Throughput in the Design#
Link Info 및 Throughput 플래그를 사용하여 디자인에서 parallelism과 데이터 처리량을 시각화할 수 있습니다. 툴바의 다음 버튼으로 이 플래그를 활성화하십시오.
그 결과 디자인에 Link Info 및 Throughput 플래그가 표시됩니다.
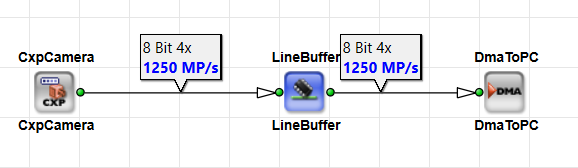
경로를 따라 값들을 비교하여 가장 좁은 link를 찾으십시오. 하류의 다른 operator가 속도를 따라잡지 못하는 경우가 아니라면 해당 link가 해당 경로의 병목 구간입니다.
정보
처리량 플래그만으로는 모든 성능 제한 사항을 확인할 수 없습니다. 예를 들어, 여러 DRAM 연산자가 동일한 메모리 인터페이스를 공유하는 경우, 공유 메모리로 인해 발생하는 DRAM 대역폭 제한은 처리량 표시창에 반영되지 않습니다. 그 밖의 DRAM 비효율성, 블로킹 및 잠재적인 교착 상태도 표시되지 않습니다. 공유 메모리 사용 및 DRAM 대역폭 계획에 대한 지침은 ‘메모리 요소 자습서’ 항목을 참조하십시오. 데드락에 대한 자세한 내용은 ‘오퍼레이터 유형 및 동기화’ 튜토리얼 항목을 참조하십시오.
Link Properties and Image Formats#
처리량과 데이터 형식은 링크 속성과 모듈 파라미터에 따라 달라집니다. 위에서 다룬 용량 관련 속성(Parallelism, Bit Width, maximum image dimensions) 외에도, 일반적인 속성에는 이미지 프로토콜과 Color Format이 포함됩니다.
링크 속성은 파이프라인 전체에 걸쳐 전파됩니다. 카메라 출력 링크나 초기 처리 단계에서 여러 속성을 설정하면, 해당 속성은 운영자가 변경할 때까지 모든 하류 링크에 적용됩니다. 모듈 매개변수는 연결된 링크의 속성과 일치해야 합니다. 따라서 상류 링크에서 변경 사항이 발생하면, 다른 운영자가 해당 속성을 재설정할 때까지 그 뒤를 잇는 모든 운영자에 영향을 미칩니다.
link Property 전체 목록 및 전파 규칙은 사용자 Manual의 Parameterization Tutorial 항목과 Rules of Links를 참조하십시오.
image protocol은 링크의 데이터 스트림 구조를 정의합니다. VisualApplets는 다음과 같은 다양한 데이터 형식/스트림 포맷을 지원합니다.
| Protocol | 권장 사용법 |
|---|---|
VALT_IMAGE2D | 예를 들어 area scan 카메라의 경우와 같이 라인 끝(end-of-line) 및 프레임 끝(end-of-frame) 마커가 있는 2차원 이미지입니다. 프레임 내의 라인은 길이가 다를 수 있습니다. |
VALT_LINE1D | 예를 들어 line scan 카메라의 경우와 같이 끝없는 연속 라인 데이터입니다. |
VALT_PIXEL0D | 이미지 치수 정보가 없는 비구조적 연속 픽셀 스트림입니다. |
VALT_SIGNAL | 예를 들어 trigger logic 등에서 모든 클록 주기에 유효한 단일 비트 신호입니다. |
픽셀은 스캔 순서에 따라 파이프라인을 통과합니다. 라인 내에서는 왼쪽에서 오른쪽으로, 프레임 내에서는 위쪽에서 아래쪽으로 이동합니다. 일부 카메라 소스는 다른 순서를 사용합니다. 소스가 이 규칙과 일치하지 않는 경우 적절한 operator를 사용하여 순서를 수정하십시오.
image protocol 및 픽셀 순서에 대한 자세한 내용은 사용자 Manual의 Image Protocols, Image Dimensions and Data Structure를 참조하십시오.
흐름 제어(flow control) 상황에서 소스가 일시 중지할 수 있는지 여부는 파이프라인 배선 방식에 영향을 미칩니다. 카메라 오퍼레이터는 non-stoppable 소스입니다. 대개 그 바로 뒤에 버퍼 오퍼레이터를 배치합니다. 자세한 내용은 아래의 Flow Control, Blocking, and Backpressure 및 Stoppable and Non-Stoppable Data Streams Tutorial 항목을 참조하십시오.
Flow Control, Blocking, and Backpressure#
생성된 FPGA 파이프라인은 스테이지 간에 flow control을 적용합니다. 스테이지가 더 이상 데이터를 수용할 준비가 되지 않으면 block its input을 수행할 수 있습니다. 즉, 상위 스테이지에 대한 데이터 요청을 중지하고 상위 스테이지도 출력을 중지합니다. 이러한 차단 동작은 backpressure로서 파이프라인을 통해 역방향으로 전파됩니다. M-타입 오퍼레이터만 입력을 차단할 수 있습니다. VisualApplets의 그래픽 모듈은 이러한 하드웨어 동작을 설명할 뿐, 모듈 자체가 flow control을 적용하는 것은 아닙니다.
가정해 봅시다. DmaToPC 호스트 컴퓨터로 데이터를 충분히 빠른 속도로 전송하지 못합니다. 이로 인해 때때로 입력을 차단합니다. 차단 신호는 상위 스트림의 버퍼 오퍼레이터로 전파됩니다. 버퍼는 차단이 활성화되어 있는 동안 데이터 전달을 중지합니다. 들어오는 픽셀을 저장하며 Fill 레벨이 상승합니다. 카메라가 데이터 전송을 중지하면 버퍼가 다시 비워집니다.
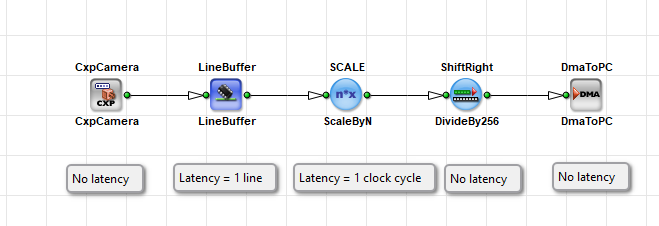
버퍼 오퍼레이터는 처리 속도가 다른 단계를 분리합니다. 중지할 수 없는 카메라 소스 뒤에 버퍼가 없으면, 하위 스트림 모듈에 의한 차단으로 인해 카메라 스트림 속도를 낮출 수 없습니다. 결과적으로 디자인이 Design Rules Check에 실패하거나 하드웨어에서 교착 상태(deadlock)가 발생할 수 있습니다.
오퍼레이터 유형 및 O-타입, M-타입, P-타입 모듈에서 차단 동작 방식에 대한 자세한 내용은 Operator Types and Synchronization Tutorial 항목을 참조하십시오.
Key Terms
Blocking이란 생성된 FPGA 스테이지가 후속 단계에서 데이터를 수용하지 않거나 스테이지 내부 처리 시간이 더 소요되는 등의 이유로 추가 입력 데이터를 수용할 수 없는 상태를 의미합니다. VisualApplets의 모듈 아이콘은 해당 스테이지를 나타내며, 아이콘 자체 대기 또는 차단 기능을 수행하지는 않습니다.
Backpressure는 그 이면에 작용하는 메커니즘으로, "압력"이 역방향으로 작용합니다. 특정 스테이지가 데이터를 충분히 빠르게 처리하지 못하면 상위 스테이지가 대기해야 하며 흐름이 차단됩니다. 실제 상황에서는 하위 스테이지가 데이터를 수용할 수 없으므로(예: 버퍼가 가득 찬 경우) 상위 스테이지가 대기하게 됩니다.
이 항목에서 Bandwidth는 연결의 픽셀 레이트, 즉 링크를 통해 초당 전송되는 픽셀 수를 의미합니다. Bit width와 커널 크기는 각 픽셀이 운반하는 데이터 양을 변경하며, 이는 별개의 개념입니다. Parallelism Tutorial 항목을 참조하십시오.
관련 항목#
- Data Flow (사용자 Manual) — 형식적 파이프라인 데이터 흐름 모델
- VisualApplets Fundamentals Tutorial 항목 — 디자인 대 하드웨어 앱릿
- From Empty Design to Running Applet Tutorial 항목 — 디자인, DRC, 시뮬레이션 및 빌드
- Parallelism Tutorial 항목 — 대역폭 및 Parallelism
- Latency Tutorial 항목 — 파이프라인 상의 지연
- Parameterization Tutorial 항목 — link Property 및 이미지 포맷
- Stoppable and Non-Stoppable Data Streams Tutorial 항목 — 흐름 제어 및 카메라 소스
- Operator Types and Synchronization Tutorial 항목 — 오퍼레이터 유형 및 차단
- Operator Reference