Kernel 작업#
이 주제를 읽고 나면 커널을 구축하고, 필터 연산자로 처리한 다음, 단일 픽셀로 다시 변환하는 방법을 이해하게 됩니다. DmaToPC.
Kernel Structure#
커널은 이미지 내 한 위치 주변의 인접 픽셀 값으로 이루어진 작은 창입니다. Noise Reduction, 블러, 엣지 검출과 같은 많은 필터는 이 인접 영역에서 새로운 출력 값을 계산합니다.
3×3 kernel의 경우 윈도우에는 9개의 값, 즉 해당 위치의 current 픽셀과 8개의 주변 픽셀이 포함됩니다. 홀수 kernel 크기의 경우 current 픽셀은 윈도우의 center에 위치합니다.
kernel은 이미지 위를 from left to right, row by row로 이동합니다. 각 위치에서 필터는 해당 픽셀 주변의 영역을 사용합니다.
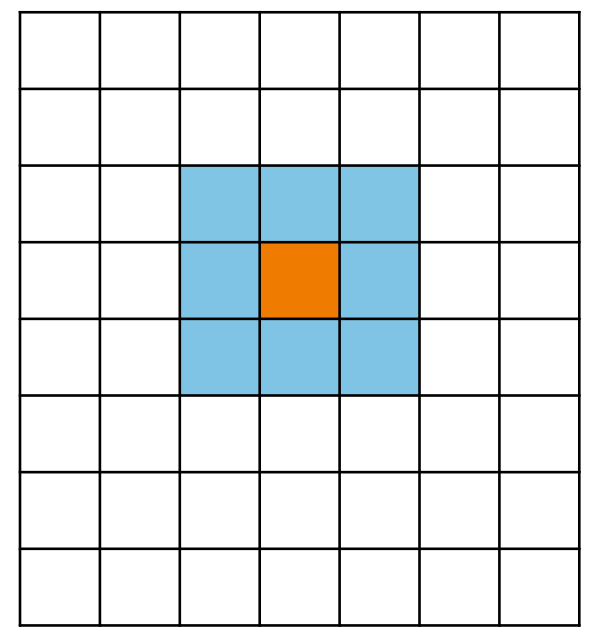
VisualApplets에서 해당 영역은 link properties에 의해 정의됩니다. 윈도우를 구성하는 방식과 current 픽셀이 그 안에서 위치하는 곳은 오퍼레이터에 따라 다릅니다. 이에 대한 세부 내용은 아래에 이어집니다.
Kernel Columns and Kernel Rows#
kernel 크기는 다음의 일부입니다. link properties. KernelColumns 이것은 이웃 창(neighborhood window)의 너비입니다. KernelRows 는 그 높이입니다. 따라서 3×3 커널은 KernelColumns = 3 그리고 KernelRows = 3.
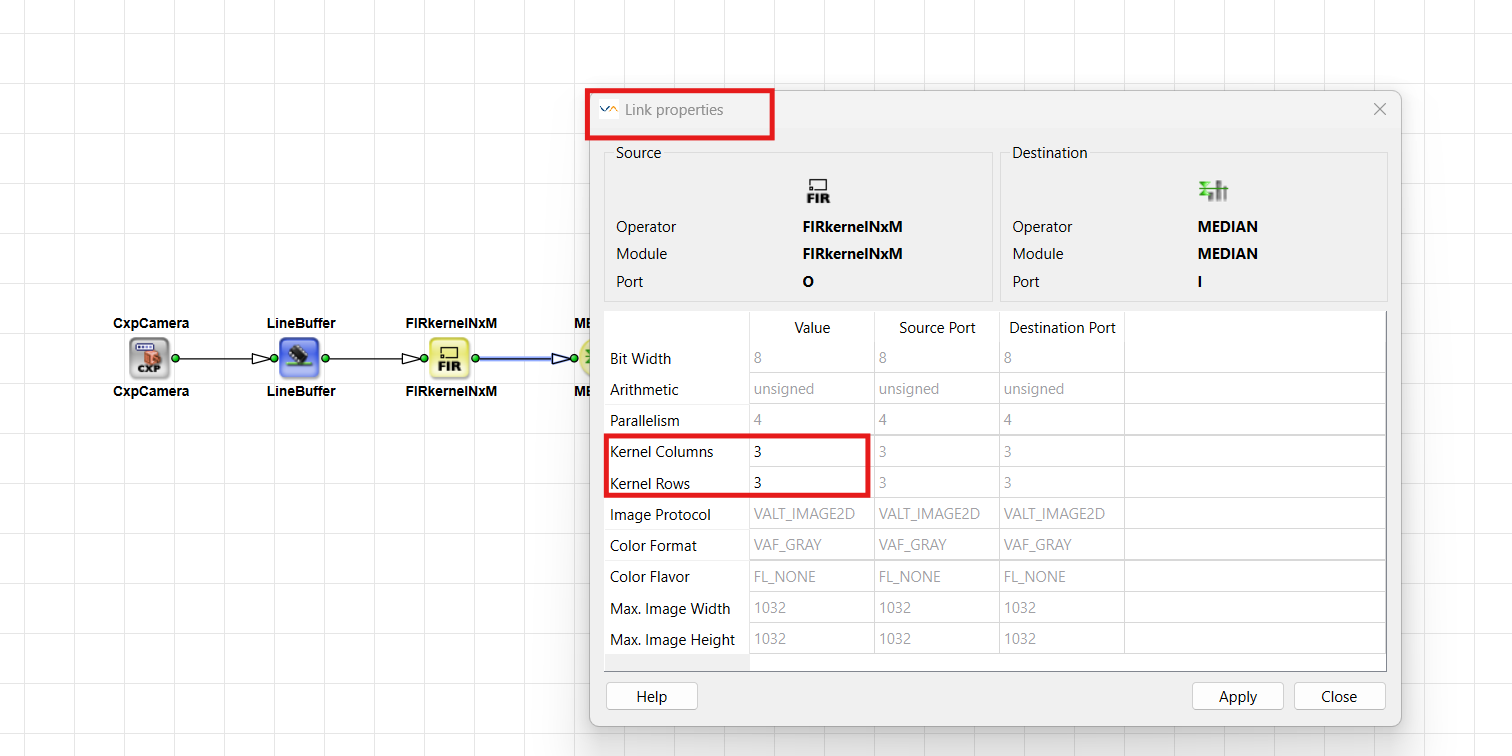
VisualApplets에서 N은 kernel 행의 수이고 M은 kernel 열의 수입니다. kernel 엘리먼트는 좌표 대신 인덱스로 지정됩니다. 인덱싱은 상단 왼쪽에서 하단 오른쪽으로 row by row 방식으로 진행됩니다.
커널 인덱스와 이미지 위치 간의 정확한 대응 관계는 항상 운영자 설명서를 참조하십시오.
모든 오퍼레이터가 1×1보다 큰 kernel을 허용하거나 전달하는 것은 아닙니다. 각 오퍼레이터는 허용되는 값을 문서화하고 있습니다. Supported Link Format 표에 있는 Operator Reference. 허용하는 오퍼레이터에 kernel 링크를 연결하는 경우 Kernel Columns = 1 및 Kernel Rows = 1, VisualApplets는 링크 형식 충돌을 보고합니다.
모든 링크 속성에 대한 개요는 Parameterization 튜토리얼 토픽을 참조하십시오.
Kernels and Parallelism#
Parallelism과 kernels는 모두 클록 주기당 링크가 전달하는 데이터의 양을 증가시키지만 서로 다른 개념을 설명합니다.
| Parallelism | Kernel | |
|---|---|---|
| 질문 | 클록당 몇 개의 independent 픽셀이 전달됩니까? | 하나의 위치에 몇 개의 neighbor values가 속합니까? |
| 권장 사용법 | 카메라 / DMA 대역폭 일치 | 주변부 데이터가 필요한 필터 공급 |
| Link properties | Parallelism | KernelColumns, KernelRows |
커널을 사용하여 Parallelism을 1로 유지하면서도 클록당 더 많은 데이터를 전송할 수 있습니다. 링크는 하나의 데이터 워드로 하나의 주변부(예: 3×3 값)를 전송합니다. 클록당 데이터 양이 증가하는 것은 클록당 더 많은 새로운 이미지 위치가 처리되기 때문이 아니라, 클록당 더 많은 값이 이동하기 때문입니다. Parallelism 튜토리얼 항목의 픽셀 레이트 대역폭 공식에는 커널 크기가 곱해지지 않습니다.
또한 두 가지를 결합할 수도 있습니다. 연산자 CastKernel 는 해당 곱이 일정하게 유지되는 한, 입력과 출력 사이의 Parallelism과 커널 크기의 곱을 재해석할 수 있습니다. 예를 들어, 커널 3×2의 Parallelism 1은 커널 1×1의 Parallelism 6이 될 수 있습니다.
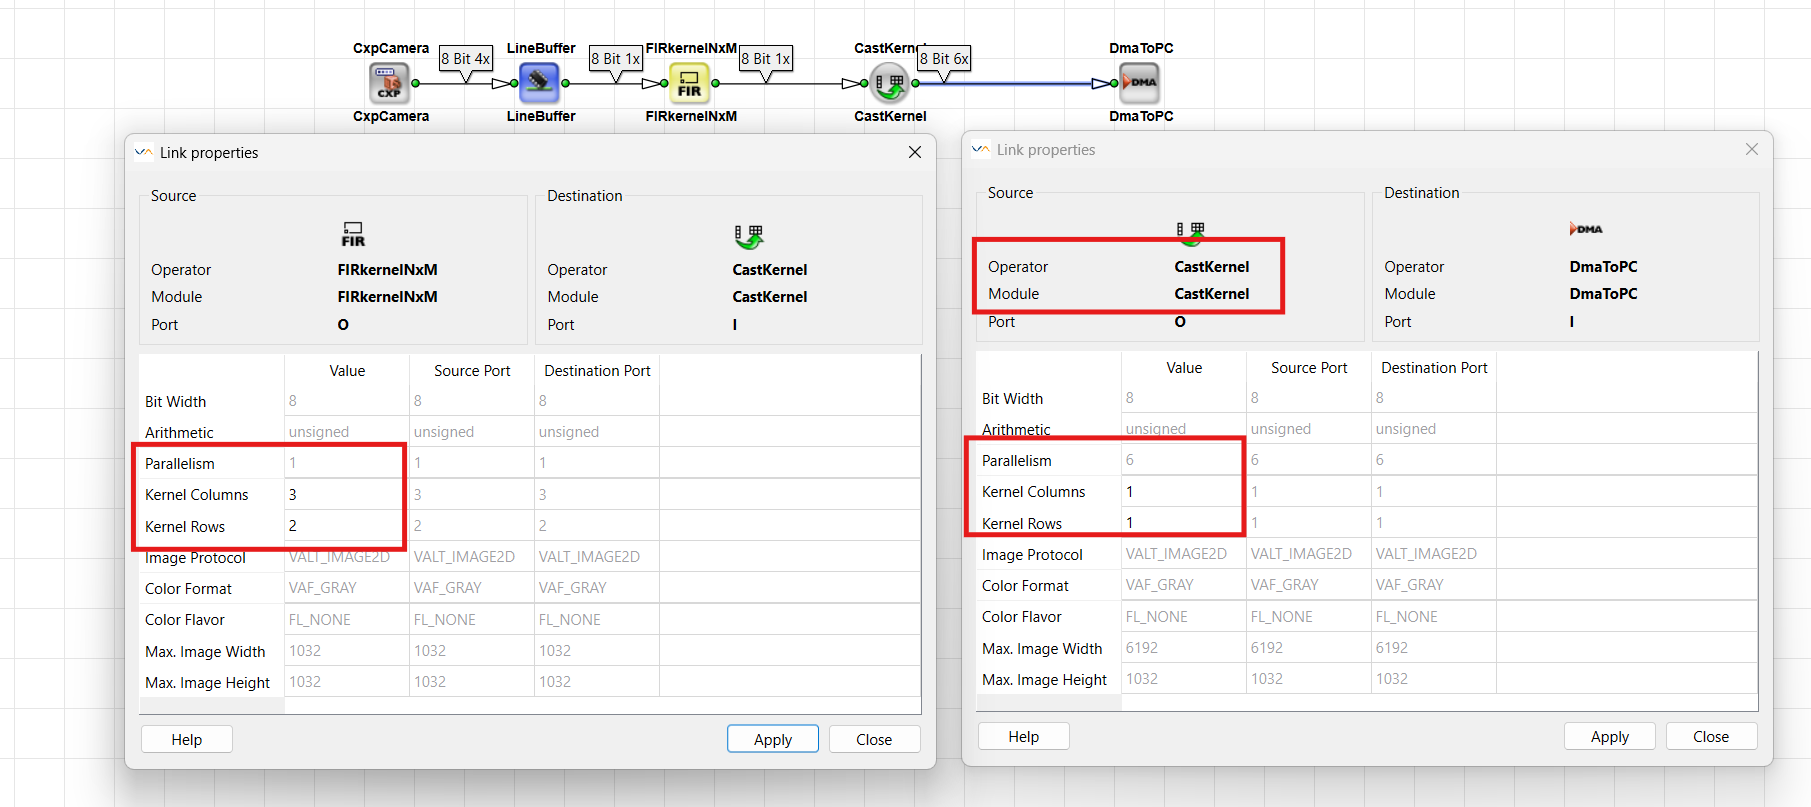
자세한 내용은 Operator Reference의 CastKernel 및 Parallelism 튜토리얼 항목을 참조하십시오.
Building Kernels#
일반 픽셀 스트림에서 주변부 데이터를 생성하려면 출력 링크에서 커널 크기를 설정하는 오퍼레이터를 사용하십시오. FIRkernelNxM 중심이 맞춰진 2D 커널 윈도우를 빌드합니다. LineNeighboursNx1 및 PixelNeighbours1xM 은 특별한 경우입니다. 중심이 맞춰진 윈도우 대신 이전 라인이나 이전 픽셀을 수집합니다. 연산자는 현재 픽셀이 위치한 곳, 연산자 유형, FPGA 비용 및 지연 시간, 그리고 에지 처리 방식(아래 참조)에서 차이가 있습니다. 사용 사례에 맞는 연산자를 선택하십시오. 중심이 맞춰진 2D 필터 이웃 영역, 이전 라인이나 픽셀 간의 비교, 또는 전체 FIR 스타일 윈도우에 대한 리소스 효율적인 대안 중에서 선택할 수 있습니다.
FIRkernelNxM#
Operator FIRkernelNxM (library Filter)은(는) 주변 픽셀을 포함하여 각 픽셀 주위에 직사각형 커널 창을 생성합니다. 이름과 달리 포함되지 FIR 필터를 구현합니다. 필터 오퍼레이터에 필요한 커널 데이터를 준비합니다. 홀수 커널 크기의 경우 현재 픽셀은 중앙 에 위치합니다. 짝수 크기의 커널에는 정확한 중앙이 없으며 중앙 위치가 왼쪽 위로 치우칩니다.
3×3 Average Filter를 사용한 스무딩:
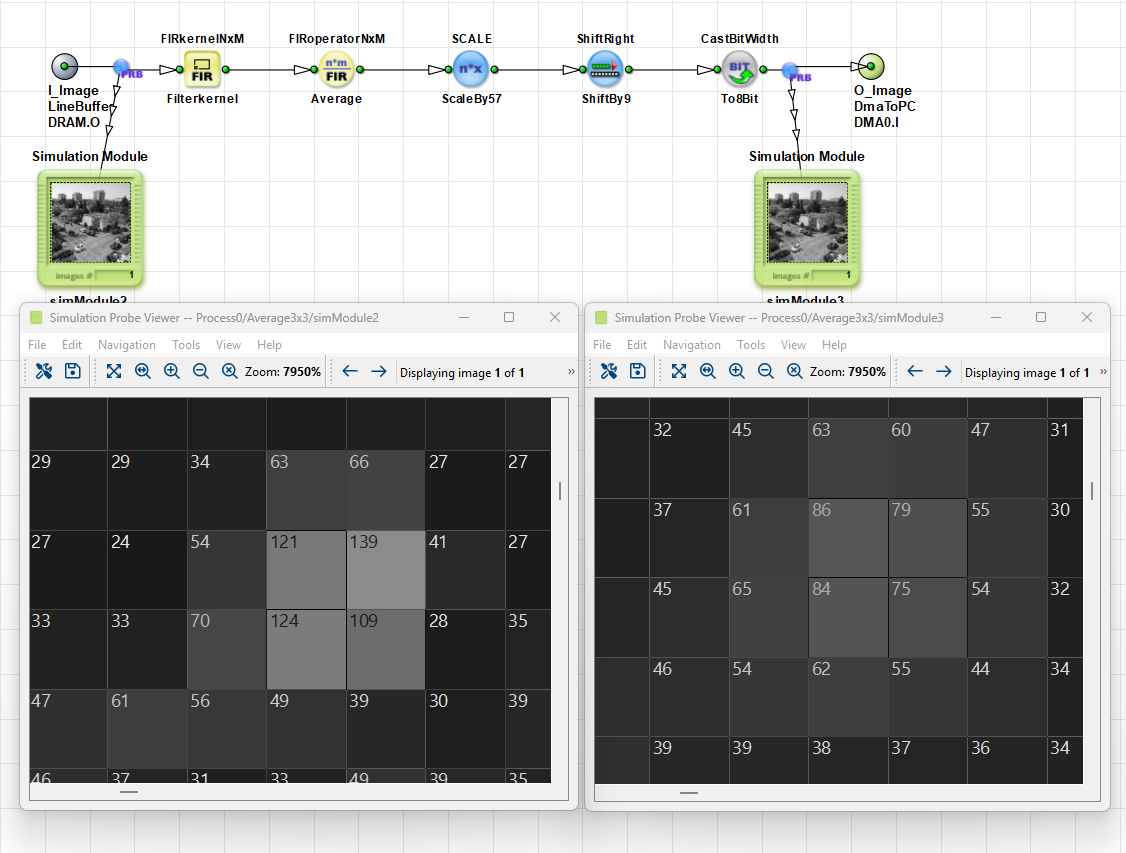
디자인은 다음을 사용하여 중심이 맞춰진 3×3 이웃 영역을 빌드합니다. FIRkernelNxM (Filterkernel), 다음 항목과 평균을 낸 후 FIRoperatorNxM (Average), 결과를 스케일링하고 8비트로 캐스트합니다. 시뮬레이션 프로브는 평균화 전후의 픽셀 값을 비교합니다. 날카로운 로컬 피크가 더 부드럽고 균일한 값으로 바뀝니다.
출력 링크를 편집하여 커널 크기를 정의합니다(Kernel Columns 및 Kernel Rows). 연산자는 전체 이웃 영역을 사용할 수 있게 될 때까지 필요한 픽셀을 버퍼링합니다. 이미지 경계에서는 이웃이 누락될 수 있습니다. 파라미터 EdgeHandling 는 누락된 값이 채워지는 방식을 선택합니다(EdgeMirrored 또는 EdgeConstant).
FIRkernelNxM 은(는) M-type 오퍼레이터입니다. 3×3과 같은 중앙 집중식 주변부를 구축하려면 버퍼링이 필요하므로 아래의 라인 또는 픽셀 이웃 오퍼레이터보다 더 많은 FPGA 리소스를 사용하고 더 많은 지연을 추가합니다. 필터에 진정으로 FIRkernelNxM 중앙 집중식 2D 주변부가 필요할 때 (예: 이전에) FIRoperatorNxM (흐림, 평균화 또는 에지 검출용).
오퍼레이터에 대한 자세한 내용은 Operator Reference의 FIRkernelNxM을 참조하십시오.
LineNeighboursNx1 및 PixelNeighbours1xM#
LineNeighboursNx1 및 PixelNeighbours1xM 은 특별한 경우입니다. 일반적인 의미의 중심이 맞춰진 커널을 빌드하지 않습니다.
LineNeighboursNx1 은(는) N행 1열의 커널을 생성합니다. 현재 픽셀은 kernel index 0에 위치하며, 다른 요소들은 이전 라인(위쪽)의 픽셀들입니다. PixelNeighbours1xM 은(는) 1행 M열의 커널을 생성합니다. 현재 픽셀은 다시 kernel index 0에 위치하며, 다른 요소들은 동일한 라인의 이전 픽셀들(왼쪽)입니다.
달리 FIRkernelNxM, 포함되지 이 오퍼레이터들은 현재 픽셀을 중앙에 두지 않으며 아직 처리되지 않은 "미래의" 이웃을 제공하지 않습니다. 이들은 이전 (이전 라인 또는 이전 픽셀). 해당 O-type operator이며, 중앙 주변부를 버퍼링할 때 발생하는 라인 또는 픽셀 지연을 추가하지 않습니다. 따라서 더 간단하며 일반적으로 FPGA 리소스 측면에서 FIRkernelNxM을(를) 공급합니다. 이러한 연산자는 입력에서 커널을 예상하고, 이웃에서 하나의 값(예: 가장 작은 픽셀)을 선택하며, 1×1 결과를 출력합니다. 해당 단계가 완료되면 커널이 다시 해제됩니다. Constant2차원 커널을 구축하려면
일반적인 사용 사례:
-
전반의 값을 비교하거나 줄입니다. 이전 라인 호출
LineNeighboursNx1과(와) 같은 연산자를 전체 커널에 걸쳐 요소별로 적용할 수 있습니다(예: 모든 이웃을 동일한 임계값과 비교).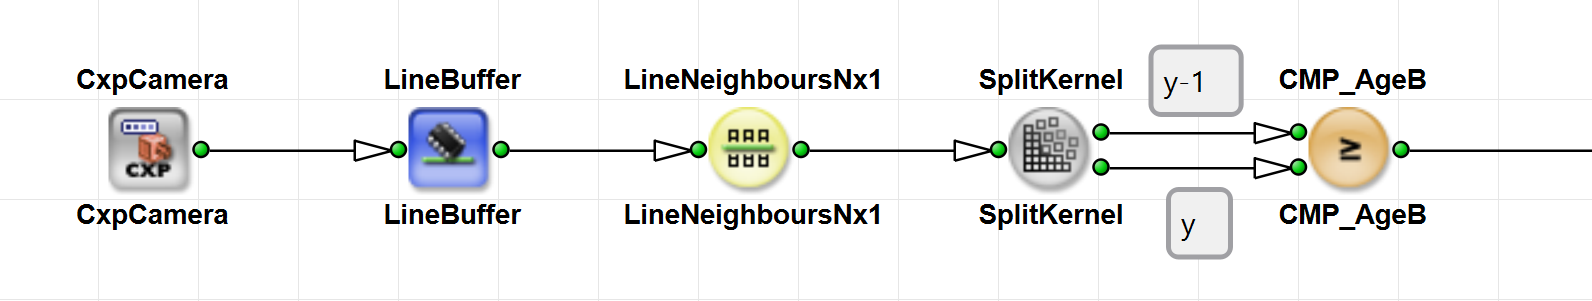
-
전반의 값을 비교하거나 줄입니다. 동일 라인의 이전 픽셀 호출
PixelNeighbours1xM.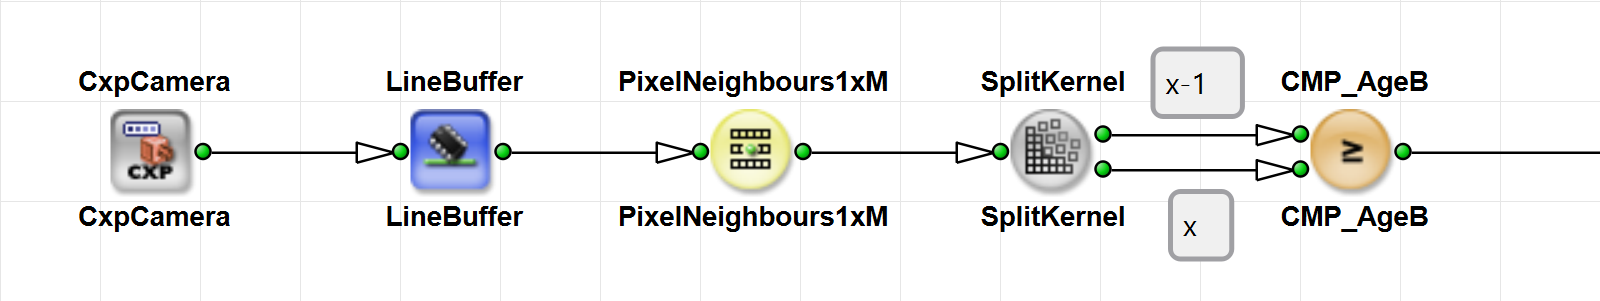
-
연산자의 출력은
MIN또는MAX: 이 operator는 입력에서 커널을 예상하고, 주변부에서 하나의 값(예: 가장 작은 픽셀)을 선택하며, 다음을 출력합니다. 1×1 결과입니다. 해당 단계 후 커널이 다시 해제됩니다.인접한 라인 전반에 걸친 최소 픽셀 값:
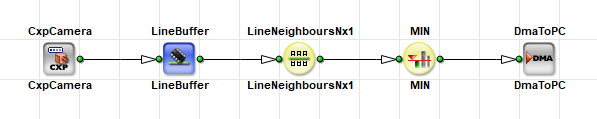
인접 픽셀 중 최대 픽셀 값:
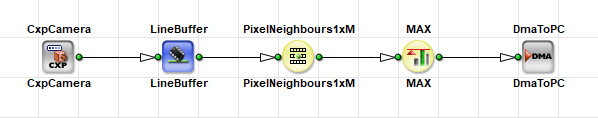
2차원 커널을 구축하려면 다음을 결합할 수 있습니다. LineNeighboursNx1 그 다음으로 PixelNeighbours1xM.
operator에 대한 자세한 내용은 Operator Reference의 LineNeighboursNx1 및 Operator Reference의 PixelNeighbours1xM을 참조하십시오.
ExpandToKernel#
Operator ExpandToKernel 단일 픽셀 입력을 임의의 커널 크기로 확장합니다. 이 기능은 복제합니다. 입력 값을 모든 커널 구성 요소로 보냅니다. 출력 링크에서 새 커널 크기를 정의합니다.
사용 ExpandToKernel 다운스트림 operator가 입력에서 커널을 예상하지만 사용자에게 다음만 있는 경우 단일 픽셀 값(예: 임계값, 평균 또는 기준 픽셀)입니다. 일반적인 패턴은 해당 상수 또는 기준을 확장하여 다음 항목의 기존 주변부와 일치시키는 것입니다. FIRkernelNxM, LineNeighboursNx1, 또는 PixelNeighbours1xM. 그러면 다음과 같은 연산자를 적용할 수 있습니다. CMP, SUB, 또는 ADD 전체 커널에 걸쳐 요소별로 처리합니다(예를 들어, 동일한 임계값을 적용하여 모든 인접 요소를 비교합니다).
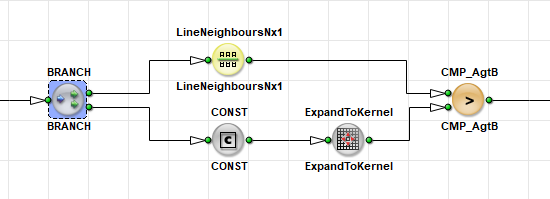
operator에 대한 자세한 내용은 Operator Reference의 ExpandToKernel을 참조하십시오.
Processing Kernels#
커널을 생성한 후에는 필터링하거나, 부분 집합을 추출하거나, 커널 스트림을 병합 또는 분할하거나, 커널 구성 요소를 재정렬할 수 있습니다. 이 섹션에 소개된 연산자들은 기존 커널을 처리합니다. 그 전에 DmaToPC, 커널을 1×1로 줄여야 합니다. 다음을 참조하십시오. Connecting to DMA.
FIRoperatorNxM#
Operator FIRoperatorNxM 각 커널 요소에 계수를 곱한 뒤 그 곱들의 합을 구합니다. 이러한 계수는 다음을 사용하여 정의할 수 있습니다. Coefficients 파라미터.
의 출력은 FIRoperatorNxM 연산자의 커널 크기는 1×1이며, 이는 각 위치마다 하나의 필터링된 픽셀 값이 산출됨을 의미합니다. 다음을 사용하십시오. FIRkernelNxM, LineNeighboursNx1, 또는 PixelNeighbours1xM 필요한 입력 커널을 생성합니다.
링크에 이미 이웃 영역이 있고 위치당 하나의 필터링된 출력 픽셀이 필요한 경우, 평균값, 가우스, 소벨 및 유사한 필터와 같은 전통적인 FIR 스타일 필터에 이 오퍼레이터를 사용하십시오.
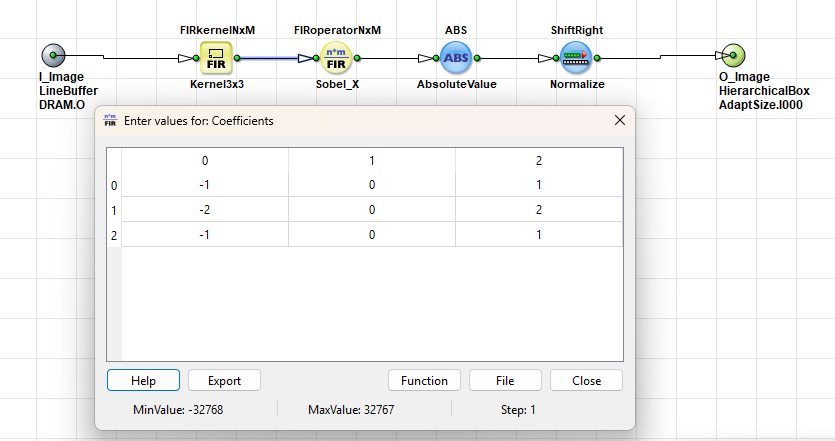
스크린샷은 VisualApplets와 함께 제공되는 디자인 예제 Examples\Processing\Filter\EdgeDetection\SobelGradientX를 보여줍니다.
operator에 대한 자세한 내용은 Operator Reference의 FIRoperatorNxM을 참조하십시오.
SelectSubKernel#
이 SelectSubKernel 오퍼레이터는 입력 커널에서 직사각형 하위 집합을 추출합니다. 해당 매개변수는 FirstROW 및 FirstCOL 하위 집합의 오프셋을 정의합니다. 새로운 커널 크기는 출력 링크에 설정됩니다.
다음과 함께 SelectSubKernel 전체 주변 영역이 더 이상 필요하지 않을 때, 중앙의 커널 요소(일반적으로 해당 이미지 위치의 원래 픽셀)를 추출합니다.
일반적인 사용 사례는 필터를 적용하면서도 원본 이미지를 유지하는 것입니다. 적용 후: FIRkernelNxM 이(가) 이웃 영역을 구축한 후, 커널 링크를 분기합니다. 하나의 경로는 필터링된 결과를 계산합니다. 다른 경로는 SelectSubKernel 을(를) 사용하여 1×1 하위 커널(해당 이미지 위치의 원본 픽셀)을 추출합니다. 그러면 필터링된 데이터와 필터링되지 않은 이미지 모두를 얻을 수 있습니다.
필터 옆에 원본 이미지 데이터 유지하기:
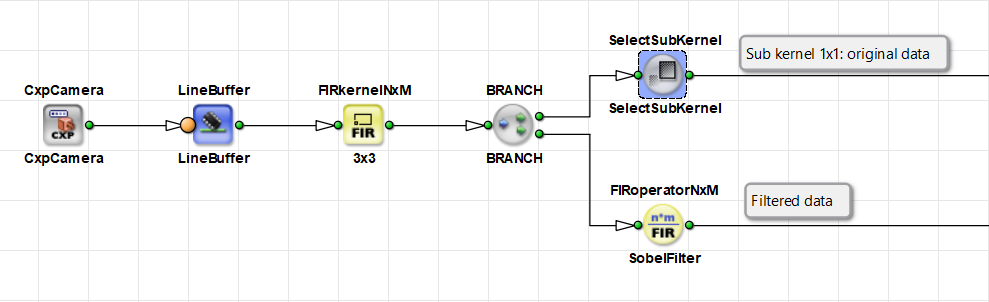
이 디자인은(는) FIRkernelNxM을(를) 사용하여 3×3 이웃 영역을 구축한 다음 분기합니다. 상단 경로는 SelectSubKernel 을(를) 사용하여 원본 픽셀(1×1 하위 커널)을 추출합니다. 하단 경로는 FIRoperatorNxM 을(를) 소벨 필터로 적용합니다.
오퍼레이터에 대한 자세한 내용은 오퍼레이터 레퍼런스의 SelectSubKernel을 참조하십시오.
MergeKernel 및 SplitKernel#
Operator MergeKernel 은(는) 여러 입력 링크를 하나의 출력 커널로 병합합니다. 이를 위해 입력 간에 하나의 커널 차원(행 또는 열)이 일치해야 하며, 입력의 다른 차원은 다를 수 있습니다. Alignment 값(이)가 있는 horizontal 또는 vertical 매개변수는 입력이 연결되는 방식을 정의합니다.
반대되는 오퍼레이터는 SplitKernel. SplitKernel 은(를) N×M 커널을 각각 커널 크기 1×1인 N×M개의 별도 출력 링크로 분할합니다. 출력 수는 커널 구성 요소 수와 같아야 하며 오퍼레이터를 인스턴스화할 때 고정됩니다.
일반적인 사용 사례는 동일한 이미지의 여러 가지 변형 (예: 서로 다른 그레이스케일 또는 처리된 버전)을 하나의 커널로 결합하여 함께 비교하거나 처리하는 것입니다. 사용: SplitKernel 개별 커널 구성 요소를 별도의 경로에서 다시 처리해야 할 때 사용합니다.
함께, MergeKernel 및 SplitKernel 은(는) 그렇지 않으면 필요할 수 있는 디자인을 대체할 수도 있습니다. SYNC operator: SYNC 일반적으로 입력에 버퍼가 필요하므로 FPGA 리소스가 소모됩니다. 대신 스트림을 커널 컴포넌트로 전달할 수 있는 경우, 커널을 병합하고 분할하는 것이 종종 더 리소스 효율적인 접근 방식입니다.
이 패턴은 다음과 같은 경우에만 사용하십시오. 동일한 이미지의 여러 가지 변형 예를 들어 하나의 카메라 스트림에서 나온 두 개의 서로 다른 처리 경로와 같이 공통 소스를 계속 공유합니다. Do 포함되지 use MergeKernel 두 개의 독립된 카메라를 병합합니다. 독립된 카메라는 비동기 소스로 유지되며 여전히 다음이 필요합니다. SYNC (또는 비동기 입력이 있는 다른 오퍼레이터) 및 버퍼. 참조: Operator 유형 및 동기화 Tutorial topic.
비동기 경로 병합 시 동기화 오류(Sync Error When Merging Asynchronous Paths):
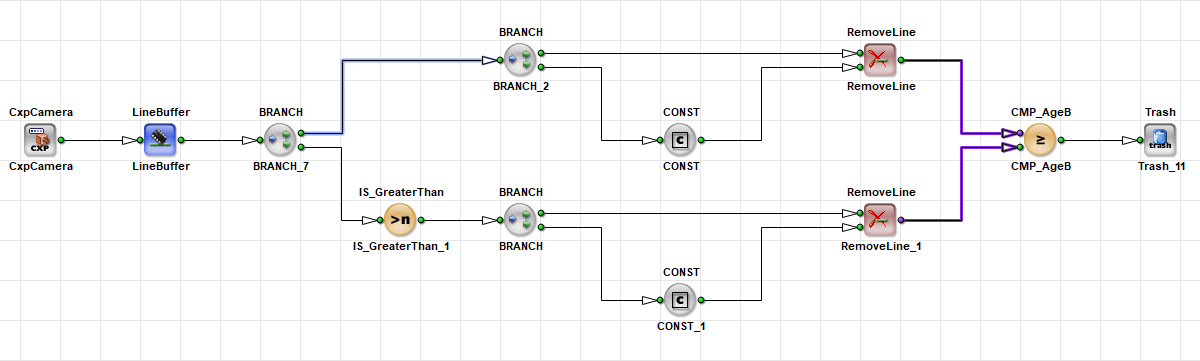
여기서는 두 분기가 동일한 이미지를 다르게 처리한 다음 공통으로 공급합니다. CMP 오퍼레이터. 한 경로의 M형 오퍼레이터로 인해 분기들이 비동기화되었기 때문에 VisualApplets은 동기화 오류(보라색 링크)를 보고하므로 직접 연결할 수 없습니다. 이 예시는 두 개의 독립된 카메라이며 여전히 하나의 카메라입니다.
버퍼 및 SYNC로 해결된 동기화 오류(Sync Error Resolved with Buffers and SYNC):
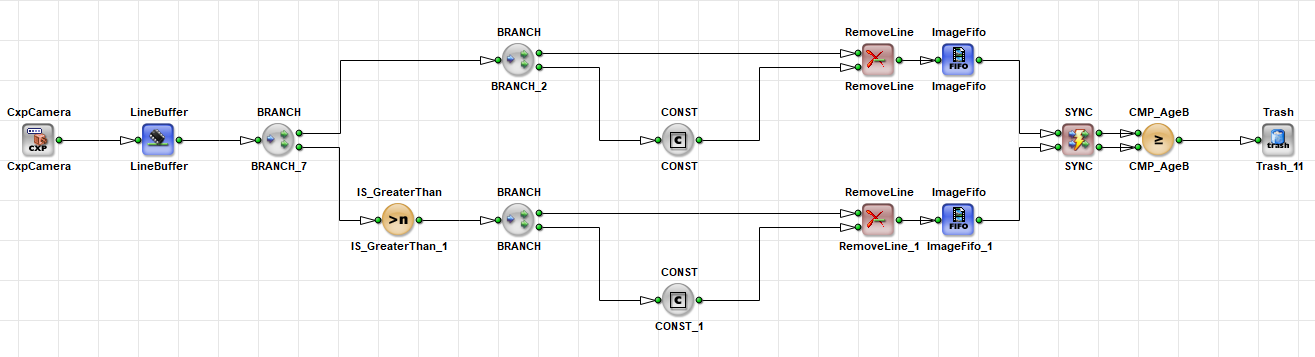
유효한 해결 방법 중 하나는 다음을 배치하는 것입니다. ImageFifo (또는 다른 버퍼)를 각 경로에 배치하고 다음으로 다시 동기화합니다. SYNC 이전 CMP. 이는 작동하지만 추가 버퍼로 인해 FPGA 리소스가 소모됩니다.
MergeKernel 및 SplitKernel로 해결된 동기화 오류(Sync Error Resolved with MergeKernel and SplitKernel):
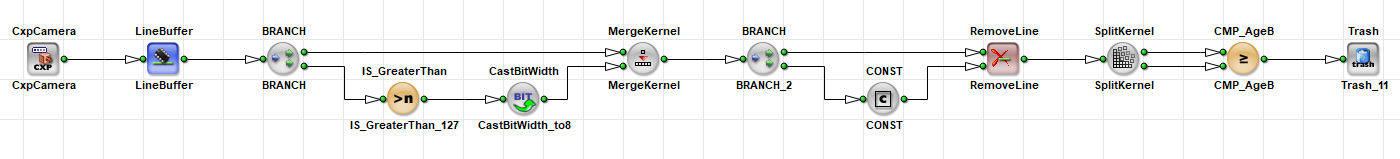
리소스 효율적인 대안은 두 변형을 모두 커널 컴포넌트로 전달하는 것입니다. MergeKernel 은(는) 두 경로를 하나의 커널 링크로 결합하고, 해당 링크에서 처리가 계속되며, SplitKernel 은(는) 다음 작업 전에 컴포넌트를 다시 분리합니다. CMP. 아니오 SYNC 또한 추가 동기화 버퍼가 필요하지 않습니다.
동기화 및 동기화 오류에 대한 자세한 내용은 오퍼레이터 유형 및 동기화 튜토리얼 주제를 참조하십시오.
오퍼레이터에 대한 자세한 내용은 오퍼레이터 레퍼런스의 MergeKernel 및 오퍼레이터 레퍼런스의 SplitKernel을 참조하십시오.
CastKernel#
CastKernel 은(는) 수신 데이터의 Parallelism 및 커널 크기를 재구성합니다. 출력 링크에서 커널 크기를 변경할 수 있습니다. 커널 행, 커널 열 및 Parallelism의 곱은 입력과 출력에서 동일해야 합니다.
다음과 함께 CastKernel 변환할 수 있습니다. Parallelism을 커널로. 예를 들어, 1×1 커널의 Parallelism 48은 48개의 커널 열을 가진 Parallelism 1이 됩니다. 동일한 48개의 픽셀 값이 여전히 한 클럭 주기에 이동하지만, 이제는 병렬 픽셀이 아니라 커널 구성 요소가 됩니다. 이는 특정 Parallelism만 허용하는 Memory 오퍼레이터 앞에서 유용합니다.
메모리 오퍼레이터 전에서 Parallelism을 커널로 변환(Converting Parallelism into a Kernel Before a Memory Operator):
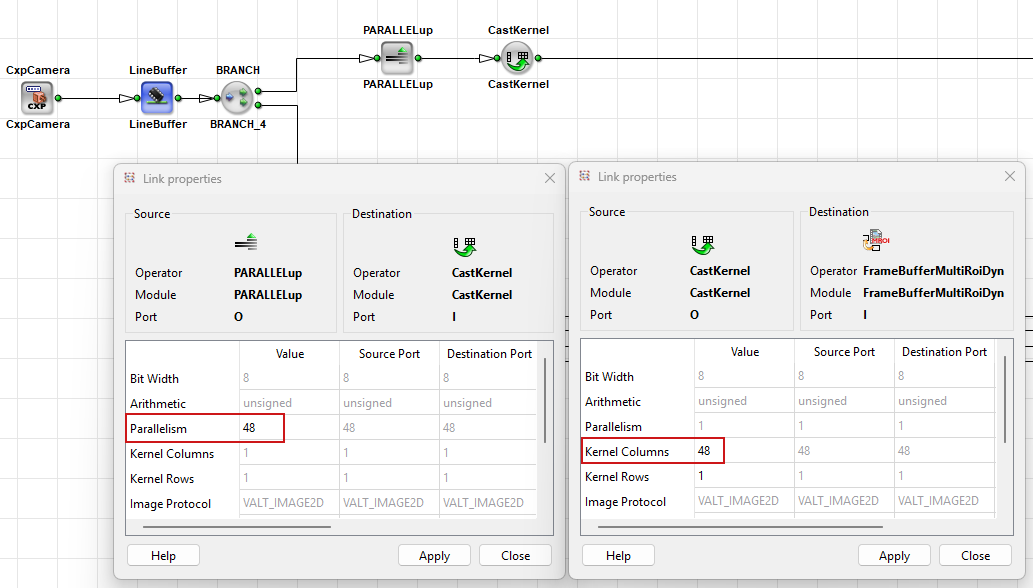
스크린샷에서, PARALLELup 은(는) Parallelism을 48(커널 1×1)로 높입니다. CastKernel 은(는) 이를 48개의 커널 열을 가진 Parallelism 1로 재해석하므로, 후속 메모리 오퍼레이터가 데이터를 수용할 수 있습니다.
오퍼레이터에 대한 자세한 내용은 오퍼레이터 레퍼런스의 CastKernel을 참조하십시오.
KernelRemap#
KernelRemap 은(는) 입력과 출력 간의 커널 구성 요소를 재매핑합니다. 커널 치수는 유지됩니다. SourceSelect 파라미터를 사용하여 각 출력 커널 구성 요소에 입력 커널 인덱스를 할당할 수 있습니다.
이 연산자를 사용하면 커널 콘텐츠를 미러링 또는 회전하고, 하나의 입력 요소를 여러 출력에 매핑하거나, 사용되지 않는 입력 요소를 버릴 수 있습니다.
KernelRemap을 사용하여 Kernel Columns 바꾸기:
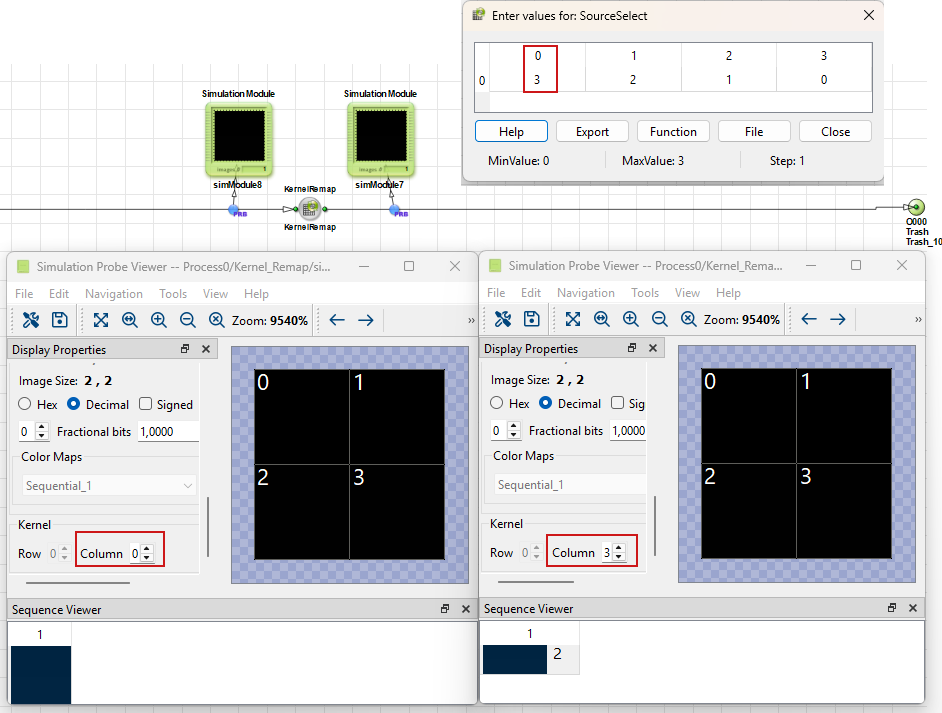
스크린샷의 디자인은 KernelRemap 이(가) Kernel Columns를 바꾸는 방법을 보여줍니다. 컬럼 0과 컬럼 3이 서로 자리를 바꿉니다(내부 컬럼도 그에 따름). 매핑은 SourceSelect 파라미터(여기서는 0, 1, 2, 3 → 3, 2, 1, 0)에서 가져옵니다. 시뮬레이션 프로브는 재매핑 전후의 커널 구성 요소를 보여줍니다.
해당 오퍼레이터에 대한 자세한 내용은 Operator Reference의 KernelRemap을 참조하십시오.
Connecting to DMA#
Raw kernel 링크는 반드시 포함되지 직접 이동 DmaToPC. DmaToPC (으)로 이동할 수 없습니다. 은(는) Kernel Columns = 1 및 Kernel Rows = 1.
만 허용하기 때문입니다. DmaToPC따라서 항상 커널 출력과
FIRoperatorNxMSelectSubKernelSplitKernelMIN또는MAXMedian
Example Design#
전형적인 필터 경로는 다음과 같습니다:
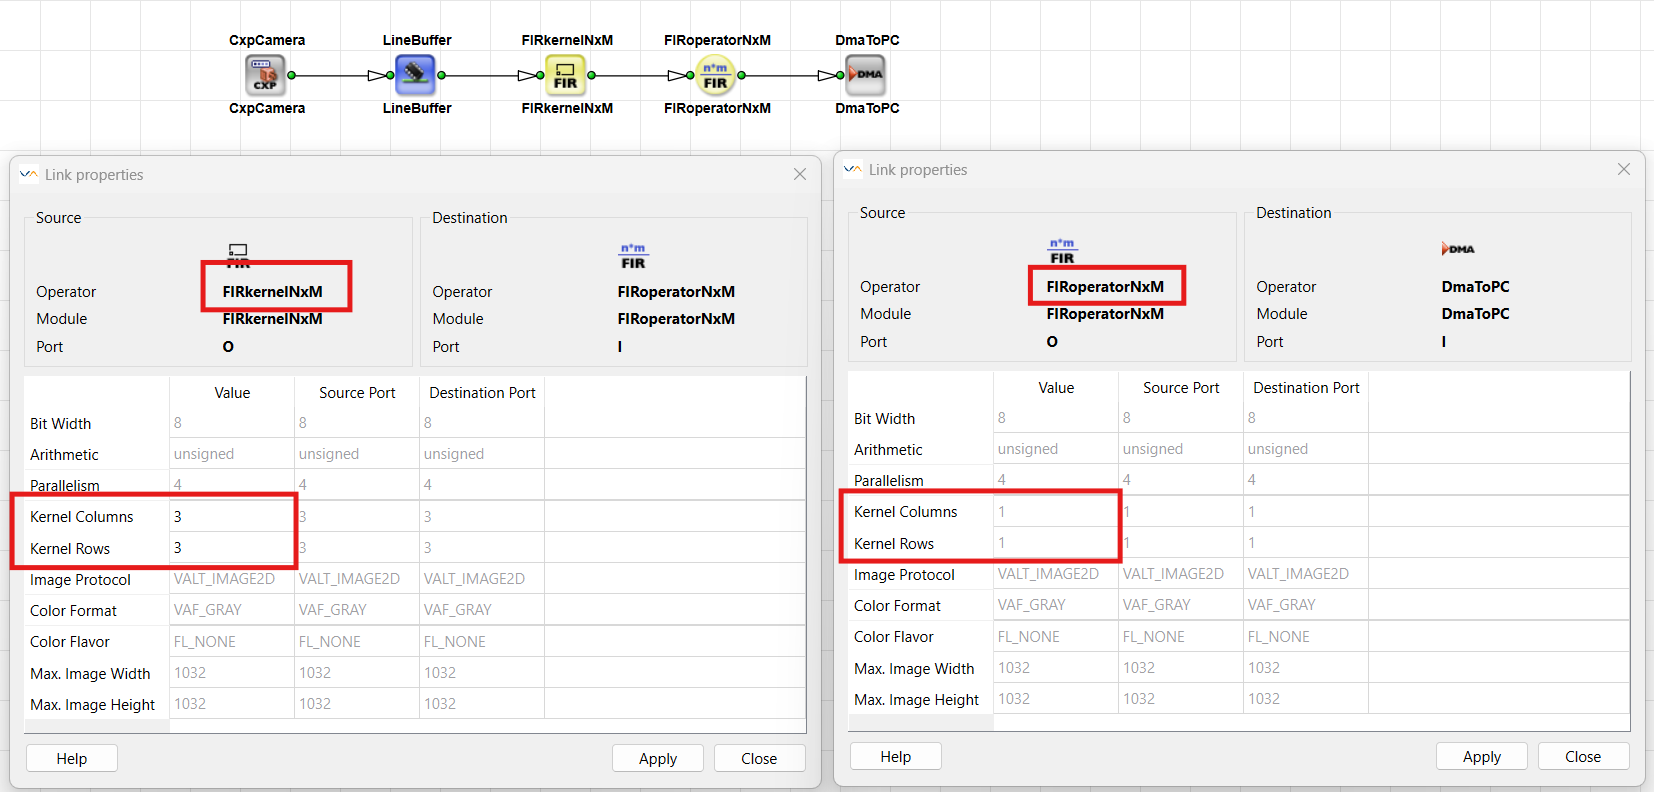
- 카메라는 단일 픽셀(1×1 커널)을 전달합니다.
- 예를 들어
LineBuffer또는ImageBuffer같은 버퍼는 카메라를 프로세싱으로부터 분리하고 주변 연산자에 필요한 라인 데이터를 제공합니다. FIRkernelNxM은(는) 출력 링크에 3×3 또는 5×5와 같은 주변 픽셀로 커널을 빌드합니다.FIRoperatorNxM은(는) 필터 계수를 적용하고 위치당 하나의 픽셀을 출력합니다.DmaToPC은(는) 단일 픽셀 스트림을 호스트로 전송합니다.
평균화, Gaussian, Sobel, 적응형 임계값 등 상세한 필터 예제는 Operator Reference의 FIRkernelNxM 및 Operator Reference의 FIRoperatorNxM에 있는 Examples of Use 섹션에 나와 있습니다.
디자인 가이드라인
항상 다음의 내용을 확인하십시오. Supported Link Format 링크에서 1×1보다 큰 커널을 생성하기 전, 특히 다음 오퍼레이터의 DmaToPC전에 커널을 1×1로 줄이십시오.
관련 항목#
- 매개변수화 튜토리얼 주제 —
KernelColumns및KernelRowslink properties - Parallelism 튜토리얼 주제 — 병렬 처리와 커널 데이터 레이트 비교
- Latency 튜토리얼 주제 — 버퍼 및 필터 오퍼레이터의 지연 시간
- Operator Reference의 FIRkernelNxM
- Operator Reference의 FIRoperatorNxM
- Operator Reference
- User Manual의 Parameterization — GUI에서 링크 및 모듈 파라미터 편집