지연 시간#
Key Terms
지연 시간 은(는) 단일 픽셀이 카메라(또는 기타 소스) 입력에서 생성된 FPGA 파이프라인을 거쳐 다음과 같은 출력에 도달하는 데 걸리는 시간입니다. DmaToPC. 이 지연은 VisualApplets 편집기가 아니라 프레임 그래버에서 발생합니다. Bandwidth 은(는) 링크를 통해 초당 흐를 수 있는 픽셀의 수입니다.
디자인은 높은 대역폭과 낮은 대기 시간을 동시에 가질 수 있습니다. 많은 픽셀이 FPGA 파이프라인을 통해 병렬로 이동하지만, 프레임의 첫 번째 픽셀은 DMA에 전달되기까지 여전히 일정 시간이 필요합니다.
Latency vs. Bandwidth#
Bandwidth 및 latency은(는) 동일 파이프라인의 서로 다른 속성을 설명합니다.
| Bandwidth | 지연 시간 | |
|---|---|---|
| 질문 | 초당 흐르는 데이터의 양은 얼마입니까? | 하나의 픽셀이 처리될 때까지 대기하는 시간은 얼마나 됩니까? |
| 다음에 따라 다름 | Parallelism and Base Design Clock | 연산자 유형 및 알고리즘 |
| 수식 (링크) | Bandwidth = Parallelism × Base Design Clock | 연산자별로 정의됨; 아래 참조 |
파이프라인은 이미지 데이터를 동시에 전송하고 처리할 수 있습니다. 예를 들어, 1000번째 픽셀이 이미 출력단에 도달해 있는 동안 5000번째 픽셀은 여전히 카메라 입력단에 있을 수 있습니다. 여러 픽셀이 디자인을 통해 병렬로 처리되기 때문에 전체 데이터 속도(대역폭)는 높게 유지됩니다. 지연 시간(Latency)은 개별 픽셀의 지연만을 나타냅니다.
디자인 가이드라인
VisualApplets 디자인에서 생성된 FPGA 파이프라인의 지연 시간은 이론적 최솟값에 가깝게 유지됩니다. 대부분의 연산자는 전체 이미지를 저장하지 않으며, 정보가 가용한 즉시 결과를 전달합니다.
Latency Definition#
지연 시간 은(는) 디자인 내 픽셀의 지연 시간, 즉 픽셀이 처리 체인에 진입한 시점부터 빠져나갈 때까지의 시간(예: DmaToPC).
중요 사항:
- 지연 시간은 각 연산자별로 개별적으로 정의되며, 주로 해당 알고리즘 구현에 따라 달라집니다.
- 모듈을 추가해도 throughput은 감소하지 not 않습니다. 생성된 FPGA 파이프라인의 모든 단계는 병렬로 실행됩니다. 즉, 한 모듈이 픽셀을 처리하는 동안 다른 모듈은 다른 픽셀을 처리합니다. 파이프라인이 Fill된 후에도 더 긴 체인은 모든 클럭 주기마다 새로운 픽셀(또는 픽셀 패킷)을 계속 수용할 수 있습니다.
- 연산자를 추가하면 latency이(가) 증가할 수 있습니다. 각 연산자는 단일 픽셀의 경로에 지연을 추가할 수 있으며, 이러한 지연들은 체인을 따라 누적됩니다. O-type 연산자의 몇 안 되는 클록 주기는 버퍼의 라인 또는 프레임 지연에 비해 대개 미미합니다.
- 지연 시간은 차단(blocking)이나 버퍼 Fill 수준과 같지 않습니다. 하위 수준의 처리가 느려지면 버퍼가 채워지고 지연 시간이 더 증가합니다. 이 주제에서는 연산자 자체에 내장된 최소 지연 시간(minimum latency)을 설명합니다.
Example Design#
본 주제 전반에 걸쳐 다음 디자인이 사용됩니다. 이는 하나의 버퍼와 두 개의 처리 단계로 구성된 간단한 수집(acquisition) 경로를 보여줍니다.
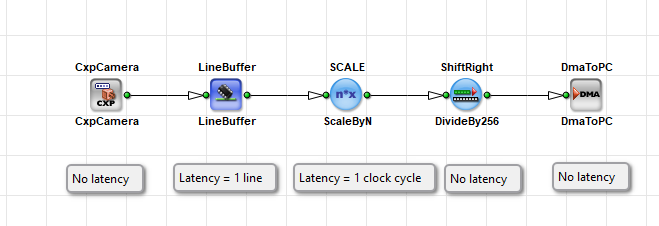
위 디자인의 Latency 주석은 이 특정 예시에 적용됩니다:
| 오퍼레이터 | 이 예시에서의 Latency |
|---|---|
CxpCamera | 이 예시에서는 추가적인 알고리즘적 지연이 없음 |
LineBuffer | 1 라인 |
ScaleByN | 1 클록 주기 |
ShiftRight | 추가 지연 없음 |
DmaToPC | 이 예시에서는 추가적인 알고리즘적 지연이 없음 |
이 경로상의 픽셀에 대한 총 지연 시간은 다음 요소에 의해 주도됩니다. 원라인 지연 의 멤버 LineBuffer과 다른 연산자들의 미세한 처리 지연. "추가적인 알고리즘적 지연이 없음"(No additional algorithmic latency)은 CxpCamera 및 DmaToPC 의 경우 이 예시에서 해당 연산자들이 그와 같은 추가 지연을 발생시키지 않는다는 의미입니다. 픽셀이 PC에 즉시 나타난다는 의미는 아닙니다. 카메라 인터페이스 타이밍, PCIe 전송, 호스트 버퍼링 및 디스플레이는 이 표에 포함되지 않습니다.
Pixel Flow in the Example Design#
예제 디자인에서 픽셀은 카메라 인터페이스를 통해 카메라에서 LineBuffer. LineBuffer 데이터를 출력으로 전달하기 전에 전체 라인 하나를 수집합니다.
전체 라인이 LineBuffer에 저장된 후, 버퍼는 해당 라인의 픽셀을 출력합니다. 동시에 카메라는 이미 다음 라인을 전송합니다. 이것이 생성된 FPGA 하드웨어의 파이프라인 동작 방식입니다. 즉, 획득, 버퍼링, 처리, DMA가 중첩될 수 있습니다. VisualApplets는 그러한 파이프라인을 설명할 뿐, 카메라 스트림 자체를 처리하지는 않습니다.
Calculating Latency#
지연 시간(Latency)은 operator에 따라 다릅니다. 전체 디자인에 대한 단일 값은 존재하지 않습니다. 하나의 픽셀 경로를 따라 지연 시간을 합산하거나(또는 시간순으로 추적) 합니다.
Line-Based Latency (Buffer Operators)#
다음과 같은 Buffer operator는 ImageBuffer 및 LineBuffer 최소한 하나의 전체 라인 이 필요합니다. 위의 예시에서 LineBuffer 의 경우:
Latency = 1 line
시간 단위로 측정한 한 라인의 지연 시간은 다음과 같습니다.
Line latency = (pixels per line) / (pixel rate of the link)
픽셀 레이트는 Parallelism 및 Base Design Clock에 따라 달라집니다. 라인이 더 넓어지거나 링크가 느려지면 첫 번째 픽셀이 버퍼를 떠날 때까지의 시간이 증가합니다.
Clock-Cycle Latency (Processing Operators)#
많은 처리 operator는 고정된 수의 클록 사이클만큼 픽셀을 지연시킵니다. 파이프라인이 Fill된 후에도 이들은 여전히 매 클록 사이클마다 하나의 픽셀(또는 하나의 병렬 픽셀 패킷)을 수 받아 출력할 수 있습니다. 이때 단일 픽셀의 지연은 내부 레지스터 단에 의한 지연뿐입니다.
예제 디자인에서 ScaleByN 추가됨:
Latency = 1 clock cycle
시간 단위로 측정한 한 클록 사이클의 지연 시간은 다음과 같습니다.
Cycle latency = 1 / Base Design Clock frequency
예를 들어, Base Design Clock이 312.5 MHz일 때 하나의 클록 사이클은 3.2 ns입니다.
다음과 같은 operator는 ShiftRight 이 예시에서 실제 동작 시 유의미한 지연을 추가하지 않습니다. 입력 값이 사용 가능한 즉시 결과를 전달합니다.
Operator Types and Latency#
VisualApplets는 operator를 유형별로 분류합니다. 이 유형을 통해 지연 시간을 예측할 수 있습니다.
| Type | 아이콘 모양 | 일반적인 지연 동작 |
|---|---|---|
| O-type | 원형 | 매우 작고 고정된 지연 시간 — 보통 클럭 사이클의 상수 수입니다. 예: 약 3.2 ns의 지연 (312.5 MHz Base Design Clock에서 1사이클). |
| M-type | 사각형 | 가변 지연 시간. 라인 또는 프레임을 버퍼링하거나, 이미지 치수를 변경하거나, 입력을 차단할 수 있습니다. 정확한 지연 시간은 operator 설명서를 확인하세요. |
| P-type | 사각형 | M-type과 유사하지만, 입력을 적극적으로 차단하지는 않습니다. 정확한 지연 시간은 operator 설명서를 확인하세요. |
CxpCamera, LineBuffer및 DmaToPC operator는 M-type입니다. ScaleByN 및 ShiftRight operator는 O-type입니다. 비록 DmaToPC 이(가) M-type이더라도, 이 예시에서는 큰 알고리즘적 지연을 추가하지 않습니다. 데이터가 도착하는 즉시 DMA로 데이터를 전달하기 때문입니다. 이미지가 호스트 소프트웨어에 표시될 때까지의 시간은 이와 별개의 나중 지연 시간입니다.
Key Terms
O-type operator는 고정된 길이를 가진 짧은 파이프 구간으로 생각할 수 있습니다. M-type operator는 저장조(버퍼) 또는 더 복잡한 메커니즘을 포함할 수 있는 구간으로 생각할 수 있습니다. 첫 번째 방울이 나오기 전에 저장조가 채워져야 하며, 이것이 라인 기반 지연 시간입니다. 이러한 파이프와 저장조는 VisualApplets에 배치한 모듈에서 생성된 FPGA의 하드웨어 스테이지입니다.
Parallelism and Latency#
Parallelism은 지연 시간을 제거하지 않습니다. 대역폭을 증가시킵니다. 즉, 클럭 사이클당 더 많은 픽셀이 링크를 통해 이동합니다.
예시: parallelism이 4인 경우, 4개의 픽셀이 한 클럭 사이클에 링크를 통과합니다. 프레임의 첫 번째 픽셀은 여전히 동일한 operator 지연 시간이 필요합니다(예: ImageBuffer의 한 라인). 파이프라인이 가득 찬 후에는 매 클럭 사이클마다 4개의 새로운 픽셀이 operator를 빠져나올 수 있습니다.
- 높은 Parallelism → 높은 처리량(대역폭).
- Buffer 및 algorithm → 첫 번째 픽셀의 latency입니다.
두 Property는 서로 독립적입니다. VisualApplets 디자인은 생성된 FPGA 파이프라인에서 높은 대역폭과 최소한의 latency를 목표로 합니다.
Finding Latency Values for Operators#
디자인에서 사용하려는 operator의 latency 값을 확인하려면 다음 소스를 활용하십시오.
- Operator Reference — 각 operator는 Operator Reference에 latency(또는 처리 지연 시간)가 문서화되어 있습니다.
- 제품 내 도움말 — 디자인에서 operator를 선택하고 파라미터 및 타이밍 세부 정보를 위한 도움말을 엽니다. 이는 VisualApplets에서 툴 내 도움말 형식으로 제공되는 Operator Reference와 동일한 콘텐츠입니다.
특히 M-type operator의 경우 항상 문서를 확인하십시오. Latency는 파라미터(예: 필터 operator의 커널 크기 또는 memory operator의 버퍼 깊이)에 따라 달라질 수 있습니다.
대부분의 operator는 전체 이미지를 저장하지 않습니다. 정보가 사용 가능하고 출력이 차단되지 않는 즉시 출력 결과를 계산합니다. 이것이 생성된 FPGA 파이프라인의 latency가 선택된 algorithm의 이론적 최솟값에 가깝게 유지되는 이유입니다.
예를 들어 PC가 데이터를 충분히 빠르게 수용할 수 없어 출력이 차단되면 버퍼 Fill 레벨이 증가하고 픽셀이 호스트에 나타날 때까지의 시간이 늘어납니다. 이러한 추가 지연은 고정된 operator latency가 아니며 flow control 및 부하 시 버퍼링에서 비롯됩니다.
관련 항목#
- Pipeline Concept 튜토리얼 주제 — 버퍼링되지 않는 flow 및 동시 처리
- Parallelism 튜토리얼 주제 — Parallelism 및 latency
- Operator Types and Synchronization 튜토리얼 주제 — operator 유형 및 latency
- Memory Elements 튜토리얼 주제 — 버퍼 operator의 라인 latency
- Working with Kernels 튜토리얼 주제 — 커널 관련 지연
- 사용 설명서의 Bandwidth of an Applet — 대역폭 대 latency
- Operator Reference — 개별 operator의 latency 값
- Device Resources — Base Design 클럭 주파수